/ Модель

Характеристики

Лицензия
CreativeML OpenRAIL-M
Опубликована
18 ноя 2022

neopian-diffusion

Генерация изображенийТекст → изображение3 профессии

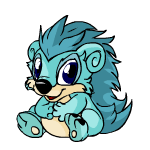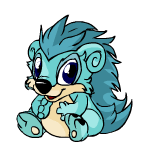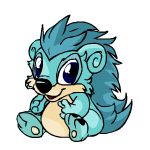
Экспериментальная DreamBooth-версия Stable Diffusion v1.5 для генерации изображений по текстовым запросам в стиле Neopets.

108скачиваний за 30 дней1лайквеса обновлены5 мая 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Изображения» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели сгенерируют результат по каждой задаче. Опубликованный тест появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Neopian-Diffusion — экспериментальная модель генерации изображений по тексту на базе Stable Diffusion v1.5 от runwayml. Её разработчик дообучил с помощью DreamBooth на 1950 изображениях примерно 100×100 пикселей, извлечённых из GIF-файлов Neopets. Для выбора кадров применялся CLIP ViT-B/32: для каждой пары подписи и GIF отбирался кадр с минимальным сферическим расстоянием до подписи.

Модель предназначена для создания изображений в стиле Neopets по текстовым запросам. В README автор предупреждает, что обучение ещё не завершено и нужный стиль пока не достигнут. Также отмечены артефакты низкого разрешения и требование NVIDIA GPU с поддержкой CUDA для описанного способа запуска через Diffusers.

Лицензия репозитория — CreativeML Open RAIL-M. README содержит отдельное уведомление об авторских правах Neopets и просит включать его при использовании извлечённых изображений на страницах, не связанных с Neopets.

Сценарии применения

  • генерация персонажей Neopets по текстовому описанию
  • создание фан-арта по мотивам Neopets
  • эксперименты с генерацией изображений в стиле Neopets

Ограничения

Автор отмечает, что обучение не завершено и желаемый стиль пока не достигнут; небольшие обучающие изображения могут приводить к артефактам. Описанный способ запуска требует NVIDIA GPU с поддержкой CUDA.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Neopian-Diffusion (wip, not done training the style isnt there yet)

Stable Diffusion models, starting with runwayml/stable-diffusion-v1-5, trained on images extracted from gifs from https://www.neopets.com/funimages.phtml. CLIP ViT-B/32 (OpenAI) was used to filter the best matching frame of the GIF for every given caption/GIF pair. The frame with the minimum spherical distance was chosen and saved for training. In total this amounts to 1950 images around 100x100px. The DreamBooth models were finetuned on a Colab T4 with the term "low-resolution" concatenated onto prompts at varying weights, to hopefully combat artifacting in the final results (see this link for a hypothesis from someone on Discord about using negative terms while training Textual Inversions https://cdn.discordapp.com/attachments/1008246088148463648/1041538692432527470/image.png).

Example chosen frame of GIF from CLIP

CaptionUnprocessed GIFChosen Frame
"yurble_baby_clap"

Training Details

Stage 1 (0-8k steps) The text encoder was trained along with the UNet at half precision for 15% of the total 8,000 steps (1,200 steps), and then the UNet was trained alone for the rest. I used a polynomial learning rate decay starting at 2e-6 (the default in fast-DreamBooth). "low quality" concatenated onto 1/3 of the prompts. Trained at 448x448

Stage 2 (8k-16k) Text encoder trained 50% of steps, random choice "low quality" "lowres" "jpeg" concatenated onto 10% of prompts, starting at 1e-6 lr, trained at 384x384

How to use with diffusers library (section from openjourney)

Installing necessary libraries

NOTE: This model currently works on a computer which has at least one NVIDIA GPU with CUDA support.

pip install diffusers transformers ftfy scipy accelerate

Logging in

For logging in, you have to use huggingface-cli login command.

Importing necessary libraries

import torch
from torch import autocast
from diffusers.models import AutoencoderKL
from diffusers import StableDiffusionPipeline

Creating the pipeline

pipe = StableDiffusionPipeline.from_pretrained("doohickey/neopian-diffusion", use_auth_token=True)
pipe = pipe.to("cuda")

(Optional) Disabling NSFW Filter

NOTE: Remember disabling this is not recommended, but since people had problems with some very basic prompts, we offer this. Remember AI art has a vast majority of users, so keep underage and sensitive users safe.

def dummy(images, **kwargs): 
	return images, False
			
pipe.safety_checker = dummy

Image Generation

prompt = "my prompt"

with autocast("cuda"):
  image = pipe(prompt=prompt, num_inference_steps=100, width=512, height=512, guidance_scale=15).images[0]
  
image.save("image.png")

Neopets Copyright Notice

"Don't forget, if you use these images on a non-Neopets page, you need to include our Copyright Notice." https://www.neopets.com/terms.phtml

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Ревизия весов
2134232

0 моделей