🪷 Prajna-CRNv2 — Safe Error Correction for Language Models
📄 Paper published: arXiv:2609.16145
Fix a frozen model's errors without breaking what it already does well.
Prajna-CRNv2 is a tiny correction module (34M params, 0.73% of the base) that sits on top of a fully frozen Gemma-4-E2B and learns to adjust its logits where it detects errors. The base model is never updated — not one gradient, not one weight. What you get is error correction with zero measurable capability loss, trained end-to-end on a Mac Mini M4.
corrected_logits = base_logits + gate * up(gelu(down(hidden)))
Built by eulogik · Code + paper: github.com/eulogik/prajna
✨ Why it matters
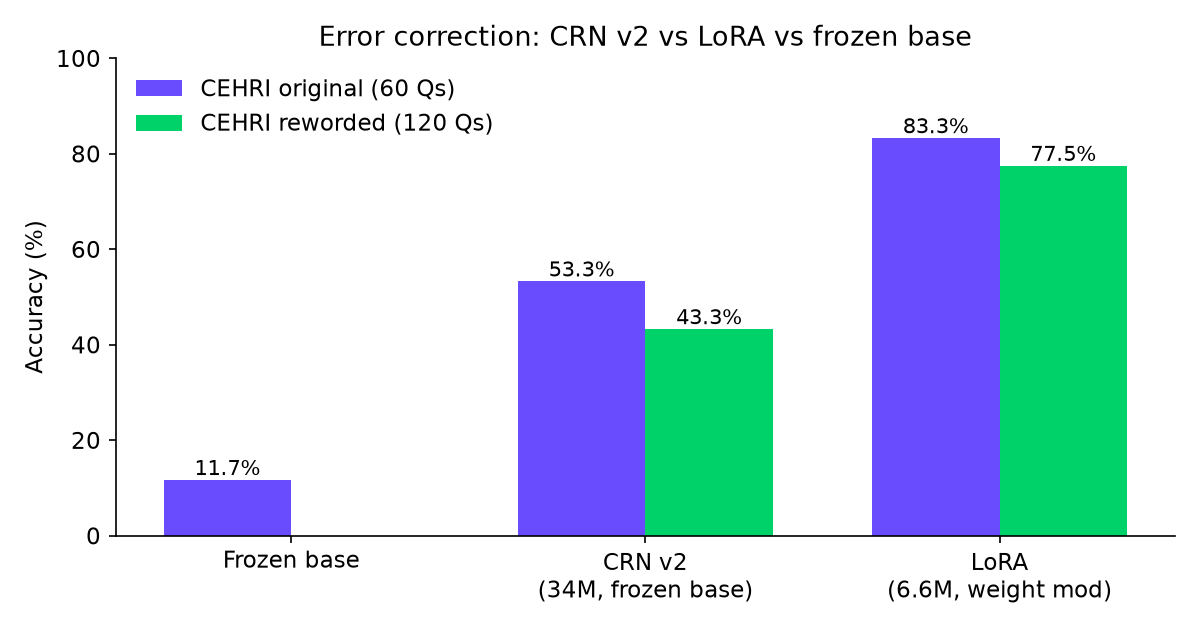
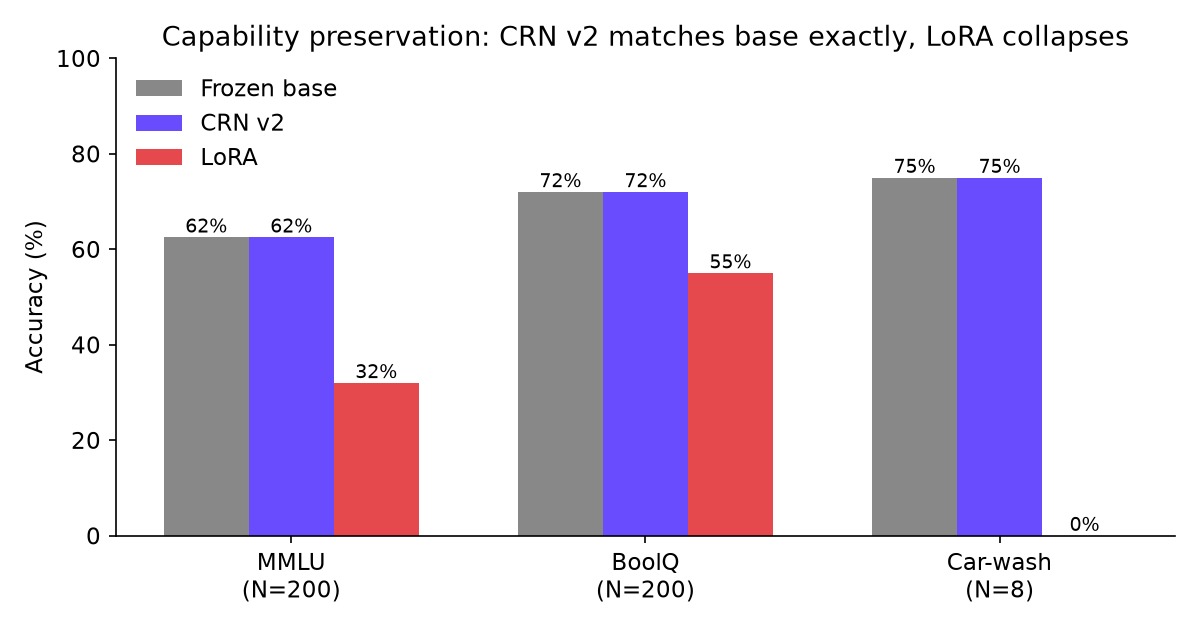
Fine-tuning fixes errors but causes forgetting — the correction–capability tradeoff. A LoRA baseline on the same exam corrects more (83.3%) yet destroys 30–75% of base capabilities (MMLU 62.5% → 32%, car-wash 75% → 0%). Prajna-CRNv2 corrects 53.3% while matching the frozen base exactly on every tested benchmark. For deployment, a model that fixes some errors and stays reliable beats one that fixes more and breaks reasoning.
🏆 Results
| CEHRI Original (60) | CEHRI Reworded (120) | MMLU (200) | BoolQ (200) | Car-wash (8) | |
|---|---|---|---|---|---|
| Frozen base | 11.7% | — | 62.5% | 72.0% | 75.0% |
| Prajna-CRNv2 | 53.3% | 43.3% | 62.5% (Δ=0) | 72.0% (Δ=0) | 75.0% (Δ=0) |
| LoRA baseline (6.6M) | 83.3% | 77.5% | 32.0% (−30.5pp) | 55.0% (−17pp) | 0% (−75pp) |
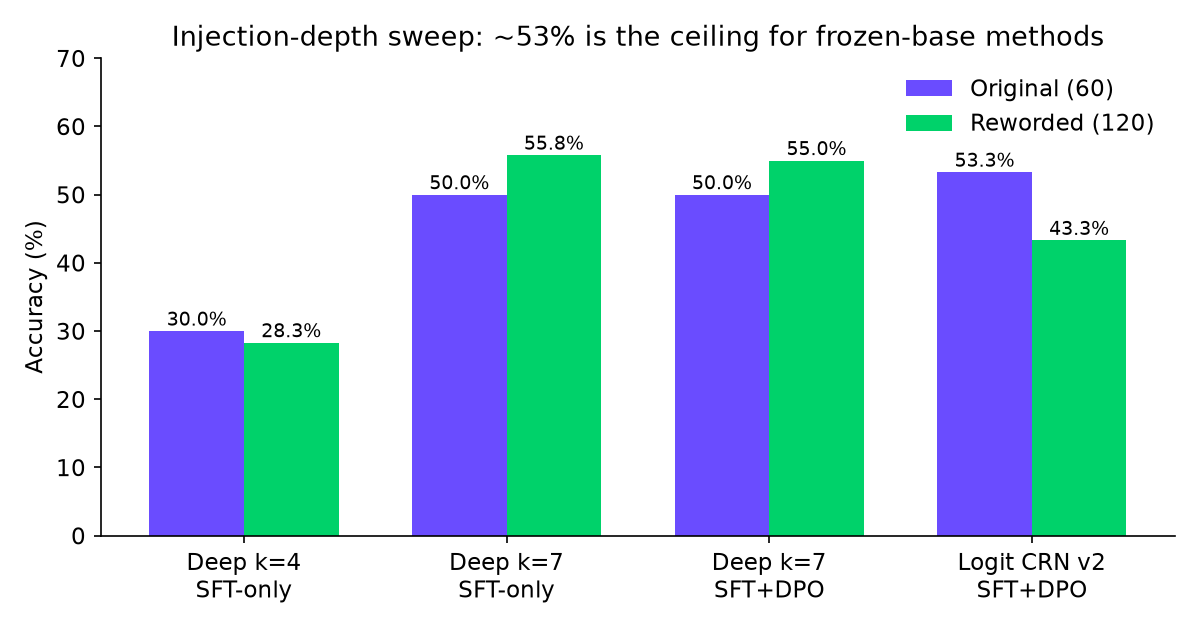
A hidden-state injection sweep (1.6M-param variant at layers 4/7) confirms ~53% as the ceiling for frozen-base methods — deeper injection helps (30% → 50%) but never beats logit correction. See the paper for the full story, including ablations and limitations.
Injection-depth sweep (experimental)
| Variant | Training | CEHRI Original | CEHRI Reworded | Capability |
|---|---|---|---|---|
| Deep layer 4 (1.6M) | SFT-only | 30.0% | 28.3% | not probed |
| Deep layer 7 (1.6M) | SFT-only | 50.0% | 55.8% | intact (small probe) |
| Deep layer 7 (1.6M) | SFT + DPO | 50.0% | 55.0% | destroyed (MMLU 13%) |
| Logit CRN v2 (34M) | SFT + DPO | 53.3% | 43.3% | intact |
🚀 Quickstart
pip install torch transformers
import torch, sys
sys.path.insert(0, ".")  # for crn_v2.py
from crn_v2 import CRNv2

model = CRNv2(device="mps" if torch.backends.mps.is_available() else "cpu")
model.load("crn_v2_dpo.pt")  # 34M correction weights (this repo)

print(model.generate("What is the capital of France?"))
# Or correct a draft answer:
print(model.correct("What is 2+2?", "5"))
Or use the interactive demo:
python inference.py
python inference.py --prompt "What is 2+2?" --draft "5"
Requirements: Python 3.10+, PyTorch 2.0+, ~10GB RAM (Gemma-4-E2B loads in float16; set HF_HOME to an external disk if space is tight).
📁 Files
| File | Size | Purpose |
|---|---|---|
crn_v2_dpo.pt | 130 MB | Trained correction weights (rank-128, SFT+DPO, KL λ=0.1) |
crn_v2.py | — | Architecture (LogitCorrection + CRNv2) |
crn_deep.py | — | Experimental hidden-state injection variant (code only) |
inference.py | — | Interactive demo / single-shot correction |
config.json | — | Model + training metadata |
🔬 Training
- Stage 1 — SFT (2,000 steps): anchor-weighted answer-only CE (anchor 4×, EOS 5×) + KL preservation (λ=0.1) on 83,400 error-correction pairs. AdamW, LR 3e-4, cosine decay.
- Stage 2 — DPO (500 steps): reference-free preference of the correct answer over the frozen base's wrong answer (β=0.1, LR 5e-6).
- Hardware: Apple M4, 16GB, MPS — ~25 min end-to-end. Base frozen throughout.
🤔 FAQ
Is the base model modified? No. Every base parameter is frozen; only the 34M correction module trains.
Why 53.3% and not higher? Frozen-base correction has a real ceiling (~53% here) — closing the gap to weight-modifying methods costs capabilities. We publish the boundary as carefully as the headline; see Limitations in the paper.
Does it generalize? The exam prompts appear verbatim in training (in-distribution: 53.3%); the reworded exam measures near-duplicate correction (43.3%). Neither tests out-of-distribution generalization — stated openly.
Can I retrain it? Yes — full pipeline (data, SFT+DPO trainers, evals) in the GitHub repo.
📜 License
Weights + code released under Gemma terms (as required by the base model). Research use. See the paper for methods, ablations, and limitations.
🪷 Prajna — "wisdom": fix errors, keep knowledge.