/ Модель

Характеристики

Параметры
113 млн
Лицензия
Apache 2.0
Архитектура
data2vec-audio · dense
Опубликована
2 мар 2022

data2vec-audio-base

ЭмбеддингиТекст → embedding3 профессии

Базовая Transformer-модель Facebook для извлечения контекстных признаков из речи и последующего дообучения на распознавание речи.

2 483скачиваний за 30 дней6лайковвеса обновлены19 апр 2022

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Эмбеддинги» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Data2Vec-Audio-Base — базовая модель самоконтролируемого предварительного обучения речи, разработанная Facebook. Она использует Transformer и обучается предсказывать контекстные латентные представления аудиосигнала по его маскированному фрагменту. Модель содержит 113,2 млн параметров и принимает речь с частотой дискретизации 16 кГц.

Модель предназначена для извлечения признаков из речи и может служить основой для дообучения на распознавание речи после добавления токенизатора и обучения на размеченных текстовых данных. Сама по себе она не выдаёт транскрипции и не содержит токенизатора. Поддерживается английский язык; в карточке также указан набор данных LibriSpeech ASR. Модель распространяется под лицензией Apache-2.0.

Сценарии применения

  • извлечение признаков из аудиозаписей речи
  • подготовка представлений речи для downstream-задач
  • дообучение базовой модели на распознавание речи
  • эксперименты с самоконтролируемым обучением речи

Ограничения

Для распознавания речи нужны отдельный токенизатор и дообучение на размеченных текстовых данных. Входную речь следует подавать с частотой дискретизации 16 кГц.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Data2Vec-Audio-Base

Facebook's Data2Vec

The base model pretrained on 16kHz sampled speech audio. When using the model make sure that your speech input is also sampled at 16Khz.

Note: This model does not have a tokenizer as it was pretrained on audio alone. In order to use this model speech recognition, a tokenizer should be created and the model should be fine-tuned on labeled text data. Check out this blog for more in-detail explanation of how to fine-tune the model.

Paper

Authors: Alexei Baevski, Wei-Ning Hsu, Qiantong Xu, Arun Babu, Jiatao Gu, Michael Auli

Abstract

While the general idea of self-supervised learning is identical across modalities, the actual algorithms and objectives differ widely because they were developed with a single modality in mind. To get us closer to general self-supervised learning, we present data2vec, a framework that uses the same learning method for either speech, NLP or computer vision. The core idea is to predict latent representations of the full input data based on a masked view of the input in a self-distillation setup using a standard Transformer architecture. Instead of predicting modality-specific targets such as words, visual tokens or units of human speech which are local in nature, data2vec predicts contextualized latent representations that contain information from the entire input. Experiments on the major benchmarks of speech recognition, image classification, and natural language understanding demonstrate a new state of the art or competitive performance to predominant approaches.

The original model can be found under https://github.com/pytorch/fairseq/tree/main/examples/data2vec .

Pre-Training method
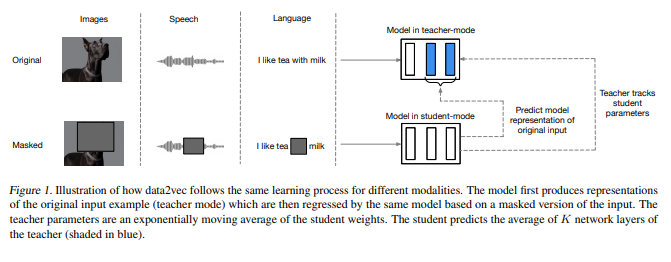
model image

For more information, please take a look at the official paper.

Usage

See this notebook for more information on how to fine-tune the model.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
Data2VecAudioModel
Ревизия весов
1f5a640

0 моделей