/ Модель

Характеристики

Контекст
514 токенов
Параметры
152 млн
Лицензия
MIT
Архитектура
data2vec-text · dense
Опубликована
2 мар 2022

data2vec-text-base

ЭмбеддингиТекст → embedding10 профессий

Англоязычная предварительно обученная Transformer-модель для получения текстовых представлений и дообучения под задачи понимания текста.

5 911скачиваний за 30 дней13лайковвеса обновлены18 апр 2022

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Эмбеддинги» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Data2Vec-Text base — англоязычная предварительно обученная трансформерная модель от команды Facebook, обученная по self-supervised objective семейства data2vec. Она преобразует текст в контекстные векторные представления и предназначена прежде всего для дообучения под задачи, использующие целое предложение или его фрагменты, например классификацию последовательностей и токенов, а также ответы на вопросы. Для генерации текста карточка рекомендует использовать авторегрессионные модели.

Модель содержит 151,8 млн параметров, принимает текст с учетом регистра и рассчитана на контекст до 514 токенов. В метаданных указаны английский язык и PyTorch; среди обучающих данных названы BookCorpus и Wikipedia. Лицензия — MIT.

Data2Vec использует Transformer и предсказывает контекстные латентные представления замаскированного входа. Карточка указывает, что модель рассчитана на дообучение для конкретных задач, поэтому качество непосредственно в прикладных сценариях зависит от выбранного дообучения.

Сценарии применения

  • получение векторных представлений английских предложений
  • дообучение классификатора последовательностей
  • дообучение разметчика токенов
  • дообучение модели для ответов на вопросы по тексту

Ограничения

Модель предназначена для дообучения под прикладную задачу и сама по себе не рассчитана на генерацию текста. Она чувствительна к регистру и ограничена контекстом до 514 токенов.

Для каких профессий подходит10

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Data2Vec-Text base model

Pretrained model on English language using the data2vec objective. It was introduced in this paper and first released in this repository. This model is case-sensitive: it makes a difference between english and English.

Disclaimer: The team releasing Data2Vec-Text did not write a model card for this model so this model card has been written by the Hugging Face team.

Pre-Training method
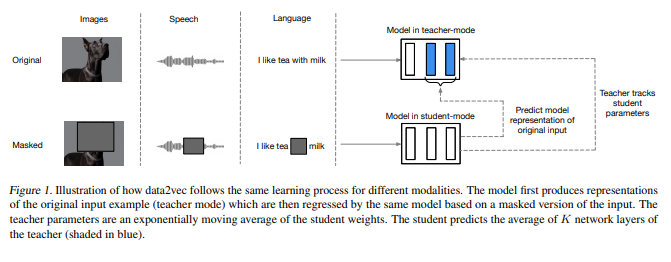
model image

For more information, please take a look at the official paper.

Abstract

While the general idea of self-supervised learning is identical across modalities, the actual algorithms and objectives differ widely because they were developed with a single modality in mind. To get us closer to general self-supervised learning, we present data2vec, a framework that uses the same learning method for either speech, NLP or computer vision. The core idea is to predict latent representations of the full input data based on a masked view of the input in a selfdistillation setup using a standard Transformer architecture. Instead of predicting modality-specific targets such as words, visual tokens or units of human speech which are local in nature, data2vec predicts contextualized latent representations that contain information from the entire input. Experiments on the major benchmarks of speech recognition, image classification, and natural language understanding demonstrate a new state of the art or competitive performance to predominant approaches.

Intended uses & limitations

The model is intended to be fine-tuned on a downstream task. See the model hub to look for fine-tuned versions on a task that interests you.

Note that this model is primarily aimed at being fine-tuned on tasks that use the whole sentence (potentially masked) to make decisions, such as sequence classification, token classification or question answering. For tasks such as text generation you should look at model like GPT2.

Training data

The RoBERTa model was pretrained on the reunion of five datasets:

  • BookCorpus, a dataset consisting of 11,038 unpublished books;
  • English Wikipedia (excluding lists, tables and headers) ;
  • CC-News, a dataset containing 63 millions English news articles crawled between September 2016 and February 2019.
  • OpenWebText, an opensource recreation of the WebText dataset used to train GPT-2,
  • Stories a dataset containing a subset of CommonCrawl data filtered to match the story-like style of Winograd schemas.

Together theses datasets weight 160GB of text.

BibTeX entry and citation info

@misc{https://doi.org/10.48550/arxiv.2202.03555,
  doi = {10.48550/ARXIV.2202.03555},
  url = {https://arxiv.org/abs/2202.03555},
  author = {Baevski, Alexei and Hsu, Wei-Ning and Xu, Qiantong and Babu, Arun and Gu, Jiatao and Auli, Michael},
  keywords = {Machine Learning (cs.LG), FOS: Computer and information sciences, FOS: Computer and information sciences},
  title = {data2vec: A General Framework for Self-supervised Learning in Speech, Vision and Language},
  publisher = {arXiv},
  year = {2022},
  copyright = {arXiv.org perpetual, non-exclusive license}
}

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
Data2VecTextModel
Ревизия весов
bd0db19

0 моделей