Mask2Former
Mask2Former model trained on Cityscapes instance segmentation (base-IN21k version, Swin backbone). It was introduced in the paper Masked-attention Mask Transformer for Universal Image Segmentation and first released in this repository.
Disclaimer: The team releasing Mask2Former did not write a model card for this model so this model card has been written by the Hugging Face team.
Model description
Mask2Former addresses instance, semantic and panoptic segmentation with the same paradigm: by predicting a set of masks and corresponding labels. Hence, all 3 tasks are treated as if they were instance segmentation. Mask2Former outperforms the previous SOTA, MaskFormer both in terms of performance an efficiency by (i) replacing the pixel decoder with a more advanced multi-scale deformable attention Transformer, (ii) adopting a Transformer decoder with masked attention to boost performance without without introducing additional computation and (iii) improving training efficiency by calculating the loss on subsampled points instead of whole masks.
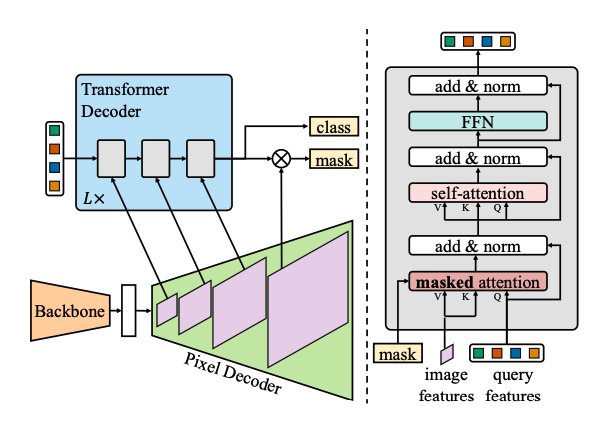
Intended uses & limitations
You can use this particular checkpoint for instance segmentation. See the model hub to look for other fine-tuned versions on a task that interests you.
How to use
Here is how to use this model:
import requests
import torch
from PIL import Image
from transformers import AutoImageProcessor, Mask2FormerForUniversalSegmentation


# load Mask2Former fine-tuned on Cityscapes instance segmentation
processor = AutoImageProcessor.from_pretrained("facebook/mask2former-swin-base-IN21k-cityscapes-instance")
model = Mask2FormerForUniversalSegmentation.from_pretrained("facebook/mask2former-swin-base-IN21k-cityscapes-instance")

url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
inputs = processor(images=image, return_tensors="pt")

with torch.no_grad():
    outputs = model(**inputs)

# model predicts class_queries_logits of shape `(batch_size, num_queries)`
# and masks_queries_logits of shape `(batch_size, num_queries, height, width)`
class_queries_logits = outputs.class_queries_logits
masks_queries_logits = outputs.masks_queries_logits

# you can pass them to processor for postprocessing
result = processor.post_process_instance_segmentation(outputs, target_sizes=[image.size[::-1]])[0]
# we refer to the demo notebooks for visualization (see "Resources" section in the Mask2Former docs)
predicted_instance_map = result["segmentation"]
For more code examples, we refer to the documentation.