/ Модель

Характеристики

Лицензия
Своя лицензия
Архитектура
mask2former · dense
Опубликована
3 янв 2023

mask2former-swin-tiny-cityscapes-panoptic

Сегментация изображенийИзображение → mask3 профессии

Компактная версия Mask2Former со Swin-Tiny для паноптической сегментации городских сцен Cityscapes.

6 968скачиваний за 30 дней1лайквеса обновлены11 сен 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Mask2Former — модель компьютерного зрения семейства Mask2Former, опубликованная командой Hugging Face. Эта версия с компактным Swin-Tiny backbone обучена на Cityscapes для паноптической сегментации городских сцен и предсказывает маски объектов вместе с соответствующими метками. Архитектура использует многоуровневый декодер признаков на основе deformable attention и Transformer-декодер с masked attention.

Модель предназначена для разделения изображения на семантические области и отдельные экземпляры объектов в рамках паноптической сегментации. Её можно применять для анализа уличных сцен, например, чтобы выделять и классифицировать объекты на изображениях городской среды. Чекпойнт опубликован в форматах PyTorch и safetensors; лицензия указана как other, поэтому конкретные условия использования следует проверять в репозитории модели.

Сценарии применения

  • паноптическая сегментация городских уличных сцен
  • выделение и классификация объектов на изображениях Cityscapes
  • разделение дорожной сцены на семантические области и экземпляры объектов

Ограничения

Этот чекпойнт обучен для паноптической сегментации на Cityscapes, поэтому его применение к изображениям за пределами городской дорожной среды может дать менее подходящие результаты. Лицензия обозначена как other; условия использования нужно уточнить в репозитории.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Mask2Former

Mask2Former model trained on Cityscapes panoptic segmentation (tiny-sized version, Swin backbone). It was introduced in the paper Masked-attention Mask Transformer for Universal Image Segmentation and first released in this repository.

Disclaimer: The team releasing Mask2Former did not write a model card for this model so this model card has been written by the Hugging Face team.

Model description

Mask2Former addresses instance, semantic and panoptic segmentation with the same paradigm: by predicting a set of masks and corresponding labels. Hence, all 3 tasks are treated as if they were instance segmentation. Mask2Former outperforms the previous SOTA, MaskFormer both in terms of performance an efficiency by (i) replacing the pixel decoder with a more advanced multi-scale deformable attention Transformer, (ii) adopting a Transformer decoder with masked attention to boost performance without without introducing additional computation and (iii) improving training efficiency by calculating the loss on subsampled points instead of whole masks.
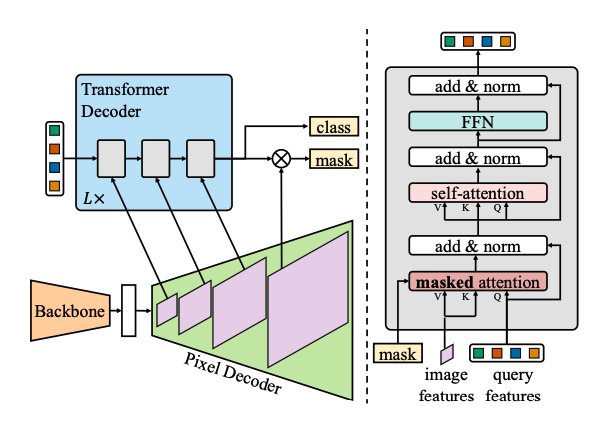
model image

Intended uses & limitations

You can use this particular checkpoint for panoptic segmentation. See the model hub to look for other fine-tuned versions on a task that interests you.

How to use

Here is how to use this model:

import requests
import torch
from PIL import Image
from transformers import AutoImageProcessor, Mask2FormerForUniversalSegmentation


# load Mask2Former fine-tuned on Cityscapes panoptic segmentation
processor = AutoImageProcessor.from_pretrained("facebook/mask2former-swin-tiny-cityscapes-panoptic")
model = Mask2FormerForUniversalSegmentation.from_pretrained("facebook/mask2former-swin-tiny-cityscapes-panoptic")

url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
inputs = processor(images=image, return_tensors="pt")

with torch.no_grad():
    outputs = model(**inputs)

# model predicts class_queries_logits of shape `(batch_size, num_queries)`
# and masks_queries_logits of shape `(batch_size, num_queries, height, width)`
class_queries_logits = outputs.class_queries_logits
masks_queries_logits = outputs.masks_queries_logits

# you can pass them to processor for postprocessing
result = processor.post_process_panoptic_segmentation(outputs, target_sizes=[image.size[::-1]])[0]
# we refer to the demo notebooks for visualization (see "Resources" section in the Mask2Former docs)
predicted_panoptic_map = result["segmentation"]

For more code examples, we refer to the documentation.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · image-segmentation

Можно запустить

Подбираем GPU…

Класс архитектуры
Mask2FormerForUniversalSegmentation
Ревизия весов
9118379

0 моделей