/ Модель

Характеристики

Параметры
403 млн
Лицензия
Apache 2.0
Архитектура
wav2vec2 · dense
Опубликована
2 мар 2022

wav2vec2-large-xlsr-53

Распознавание речи3 профессии

Многоязычная базовая модель wav2vec 2.0, извлекающая речевые представления для дообучения на распознавание речи и другие задачи обработки аудио.

114 тыс.скачиваний за 30 дней165лайковвеса обновлены18 мар 2022

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки22

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

  • SIBFLEURS

    main_score

    Результат

    0,053

    Общий результат 0,0881Общий результат 0,0791Общий результат 0,0708
    MTEB

    Публичная таблицаревизия совпадает

  • MInDS14

    main_score

    Результат

    0,0785

    Общий результат 0,1034Общий результат 0,0908Общий результат 0,0871
    MTEB

    Публичная таблицаревизия совпадает

  • UrbanSound8k

    main_score

    Результат

    0,2223

    MTEB

    Публичная таблицаревизия совпадает

  • VoxPopuliGenderID

    main_score

    Результат

    0,516

    MTEB

    Публичная таблицаревизия совпадает

  • GTZANAudioReranking

    main_score

    Результат

    0,4615

    MTEB

    Публичная таблицаревизия совпадает

  • BirdSet

    main_score

    Результат

    0,2048

    MTEB

    Публичная таблицаревизия совпадает

  • JamAltArtistA2ARetrieval

    main_score

    Результат

    0,5369

    Общий результат 0,465
    MTEB

    Публичная таблицаревизия совпадает

  • FSDD

    main_score

    Результат

    0,1893

    MTEB

    Публичная таблицаревизия совпадает

  • NSynth

    main_score

    Результат

    0,3278

    MTEB

    Публичная таблицаревизия совпадает

  • ESC50Clustering

    main_score

    Результат

    0,2742

    MTEB

    Публичная таблицаревизия совпадает

  • AudioSetMini

    main_score

    Результат

    0,1967

    MTEB

    Публичная таблицаревизия совпадает

  • SpokenQAForIC

    main_score

    Результат

    0,1165

    MTEB

    Публичная таблицаревизия совпадает

  • VocalSoundPairClassification

    main_score

    Результат

    0,4996

    MTEB

    Публичная таблицаревизия совпадает

  • ESC50AudioReranking

    main_score

    Результат

    0,4635

    MTEB

    Публичная таблицаревизия совпадает

  • ESC50

    main_score

    Результат

    0,067

    MTEB

    Публичная таблицаревизия совпадает

  • VoxPopuliGenderClustering

    main_score

    Результат

    0,0094

    MTEB

    Публичная таблицаревизия совпадает

  • CommonLanguageAgeDetection

    main_score

    Результат

    0,1569

    MTEB

    Публичная таблицаревизия совпадает

  • NMSQAPairClassification

    main_score

    Результат

    0,5378

    MTEB

    Публичная таблицаревизия совпадает

  • IEMOCAPEmotion

    main_score

    Результат

    0,1606

    MTEB

    Публичная таблицаревизия совпадает

  • FSDnoisy18kAudioReranking

    main_score

    Результат

    0,3817

    MTEB

    Публичная таблицаревизия совпадает

  • VoxPopuliLanguageID

    main_score

    Результат

    0,194

    MTEB

    Публичная таблицаревизия совпадает

  • VoxPopuliAccentID

    main_score

    Результат

    0,0807

    MTEB

    Публичная таблицаревизия совпадает

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Wav2Vec2-XLSR-53 — многоязычная базовая модель для речи, разработанная Facebook (ныне Meta) на основе архитектуры wav2vec 2.0. Она предварительно обучена на аудиозаписях речи с частотой дискретизации 16 кГц и содержит 402,7 млн параметров. Модель учится извлекать общие межъязыковые представления из необработанной формы звукового сигнала; карточка указывает предобучение на 53 языках и датасет Common Voice.

Модель предназначена для дообучения под задачи обработки речи, например автоматическое распознавание речи. После дообучения она может служить основой многоязычных систем распознавания, включая сценарии с ограниченным количеством размеченных данных. Сама базовая модель не является готовой системой транскрибирования: для целевой задачи требуется дообучение.

Доступны форматы PyTorch и Flax. Лицензия — Apache-2.0. Для входного аудио требуется частота дискретизации 16 кГц; README не приводит подробностей о качестве по отдельным языкам или ограничениях по длительности записей.

Сценарии применения

  • дообучение многоязычной системы распознавания речи
  • транскрибирование речи после настройки модели на размеченных данных
  • создание систем распознавания для языков с малым количеством обучающих данных

Ограничения

Базовая модель не готова к распознаванию речи без дообучения на целевой задаче. Входное аудио должно иметь частоту дискретизации 16 кГц.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Wav2Vec2-XLSR-53

Facebook's XLSR-Wav2Vec2

The base model pretrained on 16kHz sampled speech audio. When using the model make sure that your speech input is also sampled at 16Khz. Note that this model should be fine-tuned on a downstream task, like Automatic Speech Recognition. Check out this blog for more information.

Paper

Authors: Alexis Conneau, Alexei Baevski, Ronan Collobert, Abdelrahman Mohamed, Michael Auli

Abstract This paper presents XLSR which learns cross-lingual speech representations by pretraining a single model from the raw waveform of speech in multiple languages. We build on wav2vec 2.0 which is trained by solving a contrastive task over masked latent speech representations and jointly learns a quantization of the latents shared across languages. The resulting model is fine-tuned on labeled data and experiments show that cross-lingual pretraining significantly outperforms monolingual pretraining. On the CommonVoice benchmark, XLSR shows a relative phoneme error rate reduction of 72% compared to the best known results. On BABEL, our approach improves word error rate by 16% relative compared to a comparable system. Our approach enables a single multilingual speech recognition model which is competitive to strong individual models. Analysis shows that the latent discrete speech representations are shared across languages with increased sharing for related languages. We hope to catalyze research in low-resource speech understanding by releasing XLSR-53, a large model pretrained in 53 languages.

The original model can be found under https://github.com/pytorch/fairseq/tree/master/examples/wav2vec#wav2vec-20.

Usage

See this notebook for more information on how to fine-tune the model.
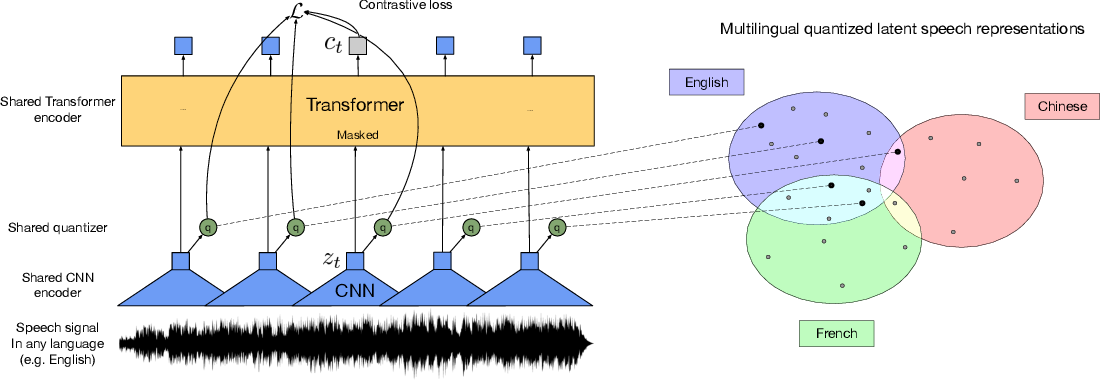
model image

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Нельзя запустить

У модели не указана задача.

Класс архитектуры
Wav2Vec2ForPreTraining
Ревизия весов
c3f9d88

0 моделей