/ Модель

Характеристики

Лицензия
Apache 2.0
Архитектура
speech-encoder-decoder · dense
Опубликована
2 мар 2022

wav2vec2-xls-r-1b-21-to-en

Распознавание речиАудио → текст4 профессии

Модель преобразует аудио на 21 языке в текстовый перевод на английском языке.

238скачиваний за 30 дней3лайкавеса обновлены24 янв 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Распознавание речи» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

facebook/wav2vec2-xls-r-1b-21-to-en — модель перевода речи, разработанная Facebook (Meta) на основе Wav2Vec2-XLS-R. Она принимает аудио на одном из 21 языков и генерирует текстовый перевод на английский. Архитектура — SpeechEncoderDecoderModel: энкодер инициализирован из facebook/wav2vec2-xls-r-1b, декодер — из facebook/mbart-large-50; модель дообучена на парах перевода датасета CoVoST 2. Репозиторий содержит веса PyTorch, лицензия — Apache-2.0.

Модель подходит для перевода записей и устной речи на английский, например для обработки многоязычного аудио и демонстрационных сценариев. В карточке указаны французский, немецкий, испанский, каталанский, итальянский, русский, китайский, португальский, персидский, эстонский, монгольский, нидерландский, турецкий, арабский, шведский, латышский, словенский, тамильский, японский, индонезийский и валлийский как исходные языки. Карточка также предлагает оценивать модель на CoVoST 2, но не приводит численные результаты. Модель ориентирована на перевод только в английский; качество может зависеть от языка, акцента и условий записи.

Сценарии применения

  • перевод русской устной речи на английский
  • перевод записей на английский с французского или немецкого
  • подготовка английских субтитров по многоязычному аудио
  • перевод речи из аудиозаписей на английский

Ограничения

Перевод выполняется только на английский; численные показатели качества в карточке не приведены. Качество может меняться в зависимости от языка, акцента и условий записи.

Для каких профессий подходит4

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Wav2Vec2-XLS-R-2b-21-EN

Facebook's Wav2Vec2 XLS-R fine-tuned for Speech Translation.
model image

This is a SpeechEncoderDecoderModel model. The encoder was warm-started from the facebook/wav2vec2-xls-r-1b checkpoint and the decoder from the facebook/mbart-large-50 checkpoint. Consequently, the encoder-decoder model was fine-tuned on 21 {lang} -> en translation pairs of the Covost2 dataset.

The model can translate from the following spoken languages {lang} -> en (English):

{fr, de, es, ca, it, ru, zh-CN, pt, fa, et, mn, nl, tr, ar, sv-SE, lv, sl, ta, ja, id, cy} -> en

For more information, please refer to Section 5.1.2 of the official XLS-R paper.

Usage

Demo

The model can be tested directly on the speech recognition widget on this model card! Simple record some audio in one of the possible spoken languages or pick an example audio file to see how well the checkpoint can translate the input.

Example

As this a standard sequence to sequence transformer model, you can use the generate method to generate the transcripts by passing the speech features to the model.

You can use the model directly via the ASR pipeline

from datasets import load_dataset
from transformers import pipeline

# replace following lines to load an audio file of your choice
librispeech_en = load_dataset("patrickvonplaten/librispeech_asr_dummy", "clean", split="validation")
audio_file = librispeech_en[0]["file"]

asr = pipeline("automatic-speech-recognition", model="facebook/wav2vec2-xls-r-1b-21-to-en", feature_extractor="facebook/wav2vec2-xls-r-1b-21-to-en")

translation = asr(audio_file)

or step-by-step as follows:

import torch
from transformers import Speech2Text2Processor, SpeechEncoderDecoderModel
from datasets import load_dataset

model = SpeechEncoderDecoderModel.from_pretrained("facebook/wav2vec2-xls-r-1b-21-to-en")
processor = Speech2Text2Processor.from_pretrained("facebook/wav2vec2-xls-r-1b-21-to-en")

ds = load_dataset("patrickvonplaten/librispeech_asr_dummy", "clean", split="validation")

inputs = processor(ds[0]["audio"]["array"], sampling_rate=ds[0]["audio"]["array"]["sampling_rate"], return_tensors="pt")
generated_ids = model.generate(input_ids=inputs["input_features"], attention_mask=inputs["attention_mask"])
transcription = processor.batch_decode(generated_ids)

Results {lang} -> en

See the row of XLS-R (1B) for the performance on Covost2 for this model.
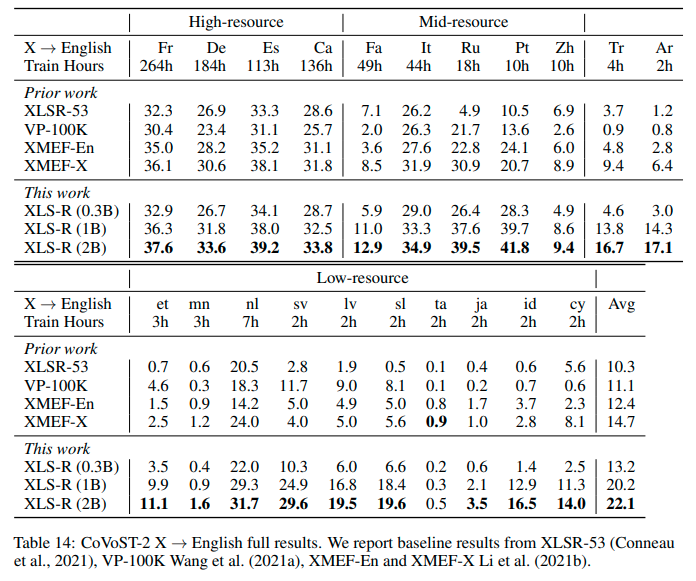
results image

More XLS-R models for {lang} -> en Speech Translation

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
SpeechEncoderDecoderModel
Ревизия весов
5000ecd

0 моделей