/ Модель

Характеристики

Контекст
32 768 токенов
Параметры
7,1 млрд
Размер весов
14,5 ГБ
Лицензия
Apache 2.0
Архитектура
mistral · dense
Базовая модель
RolePlayLake-7B
Опубликована
6 фев 2024

RolePlayLake-7B-Toxic

Генерация текстаТекст → текст3 профессии

Англоязычная модель Mistral на 7,1 млрд параметров для ролевых диалогов и творческой генерации с ослабленными ограничениями.

22скачиваний за 30 дней6лайковвеса обновлены4 мар 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

fhai50032/RolePlayLake-7B-Toxic — англоязычная текстовая модель для генерации ролевых диалогов и творческих текстов с менее строгими ограничениями на содержание. Её разработал fhai50032, дообучив RolePlayLake-7B методом QLoRA; в карточке указаны архитектура Mistral, около 7,1 млрд параметров и контекст до 32 768 токенов. Модель рассчитана на форматы диалога Alpaca и ChatML. Дообучение на наборе Undi95/toxic-dpo-v0.1-sharegpt и других данных, снижающих ограничения, предназначено для более свободной генерации.

Приведённые в README результаты отдельных тестов не гарантируют качество в других сценариях. Модель распространяется по лицензии Apache-2.0.

Сценарии применения

  • ведение ролевых диалогов на английском языке
  • генерация творческих текстов и сюжетных сцен
  • создание персонажей и ответы от их лица
  • диалоговая генерация в форматах Alpaca и ChatML

Ограничения

Дообучение ориентировано на менее ограниченную генерацию, поэтому модель может выдавать токсичный или нежелательный контент. Качество подтверждено лишь ограниченными результатами тестирования, приведёнными в карточке.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Uploaded model

  • Developed by: fhai50032
  • License: apache-2.0
  • Finetuned from model : fhai50032/RolePlayLake-7B

More Uncensored out of the gate without any prompting; trained on Undi95/toxic-dpo-v0.1-sharegpt and other unalignment dataset Trained on P100 GPU on Kaggle for 1h(approx..)

QLoRA (4bit)

Params to replicate training

Peft Config

    r = 64, 
    target_modules = ['v_proj', 'down_proj', 'up_proj', 
                      'o_proj', 'q_proj', 'gate_proj', 'k_proj'],
    lora_alpha = 128, #weight_scaling
    lora_dropout = 0, # Supports any, but = 0 is optimized
    bias = "none",    # Supports any, but = "none" is optimized
    use_gradient_checkpointing = True,#False,#
    random_state = 3407,
    max_seq_length = 1024,

Training args

        per_device_train_batch_size = 6,
        gradient_accumulation_steps = 6,
        gradient_checkpointing=True,
#       warmup_ratio = 0.1,
        warmup_steps=4,
        save_steps=150,
        dataloader_num_workers = 2,
        learning_rate = 2e-5,
        fp16 = True,
        logging_steps = 1,
        num_train_epochs=2, ## use this for epoch
        # max_steps=9, ## max steps over ride epochs
        optim = "adamw_8bit",
        weight_decay = 1e-3,
        lr_scheduler_type = "linear",
        seed = 3407,
        output_dir = "outputs",
        packing=False,
#       neftune_noise_alpha=10

Loss 0.6182
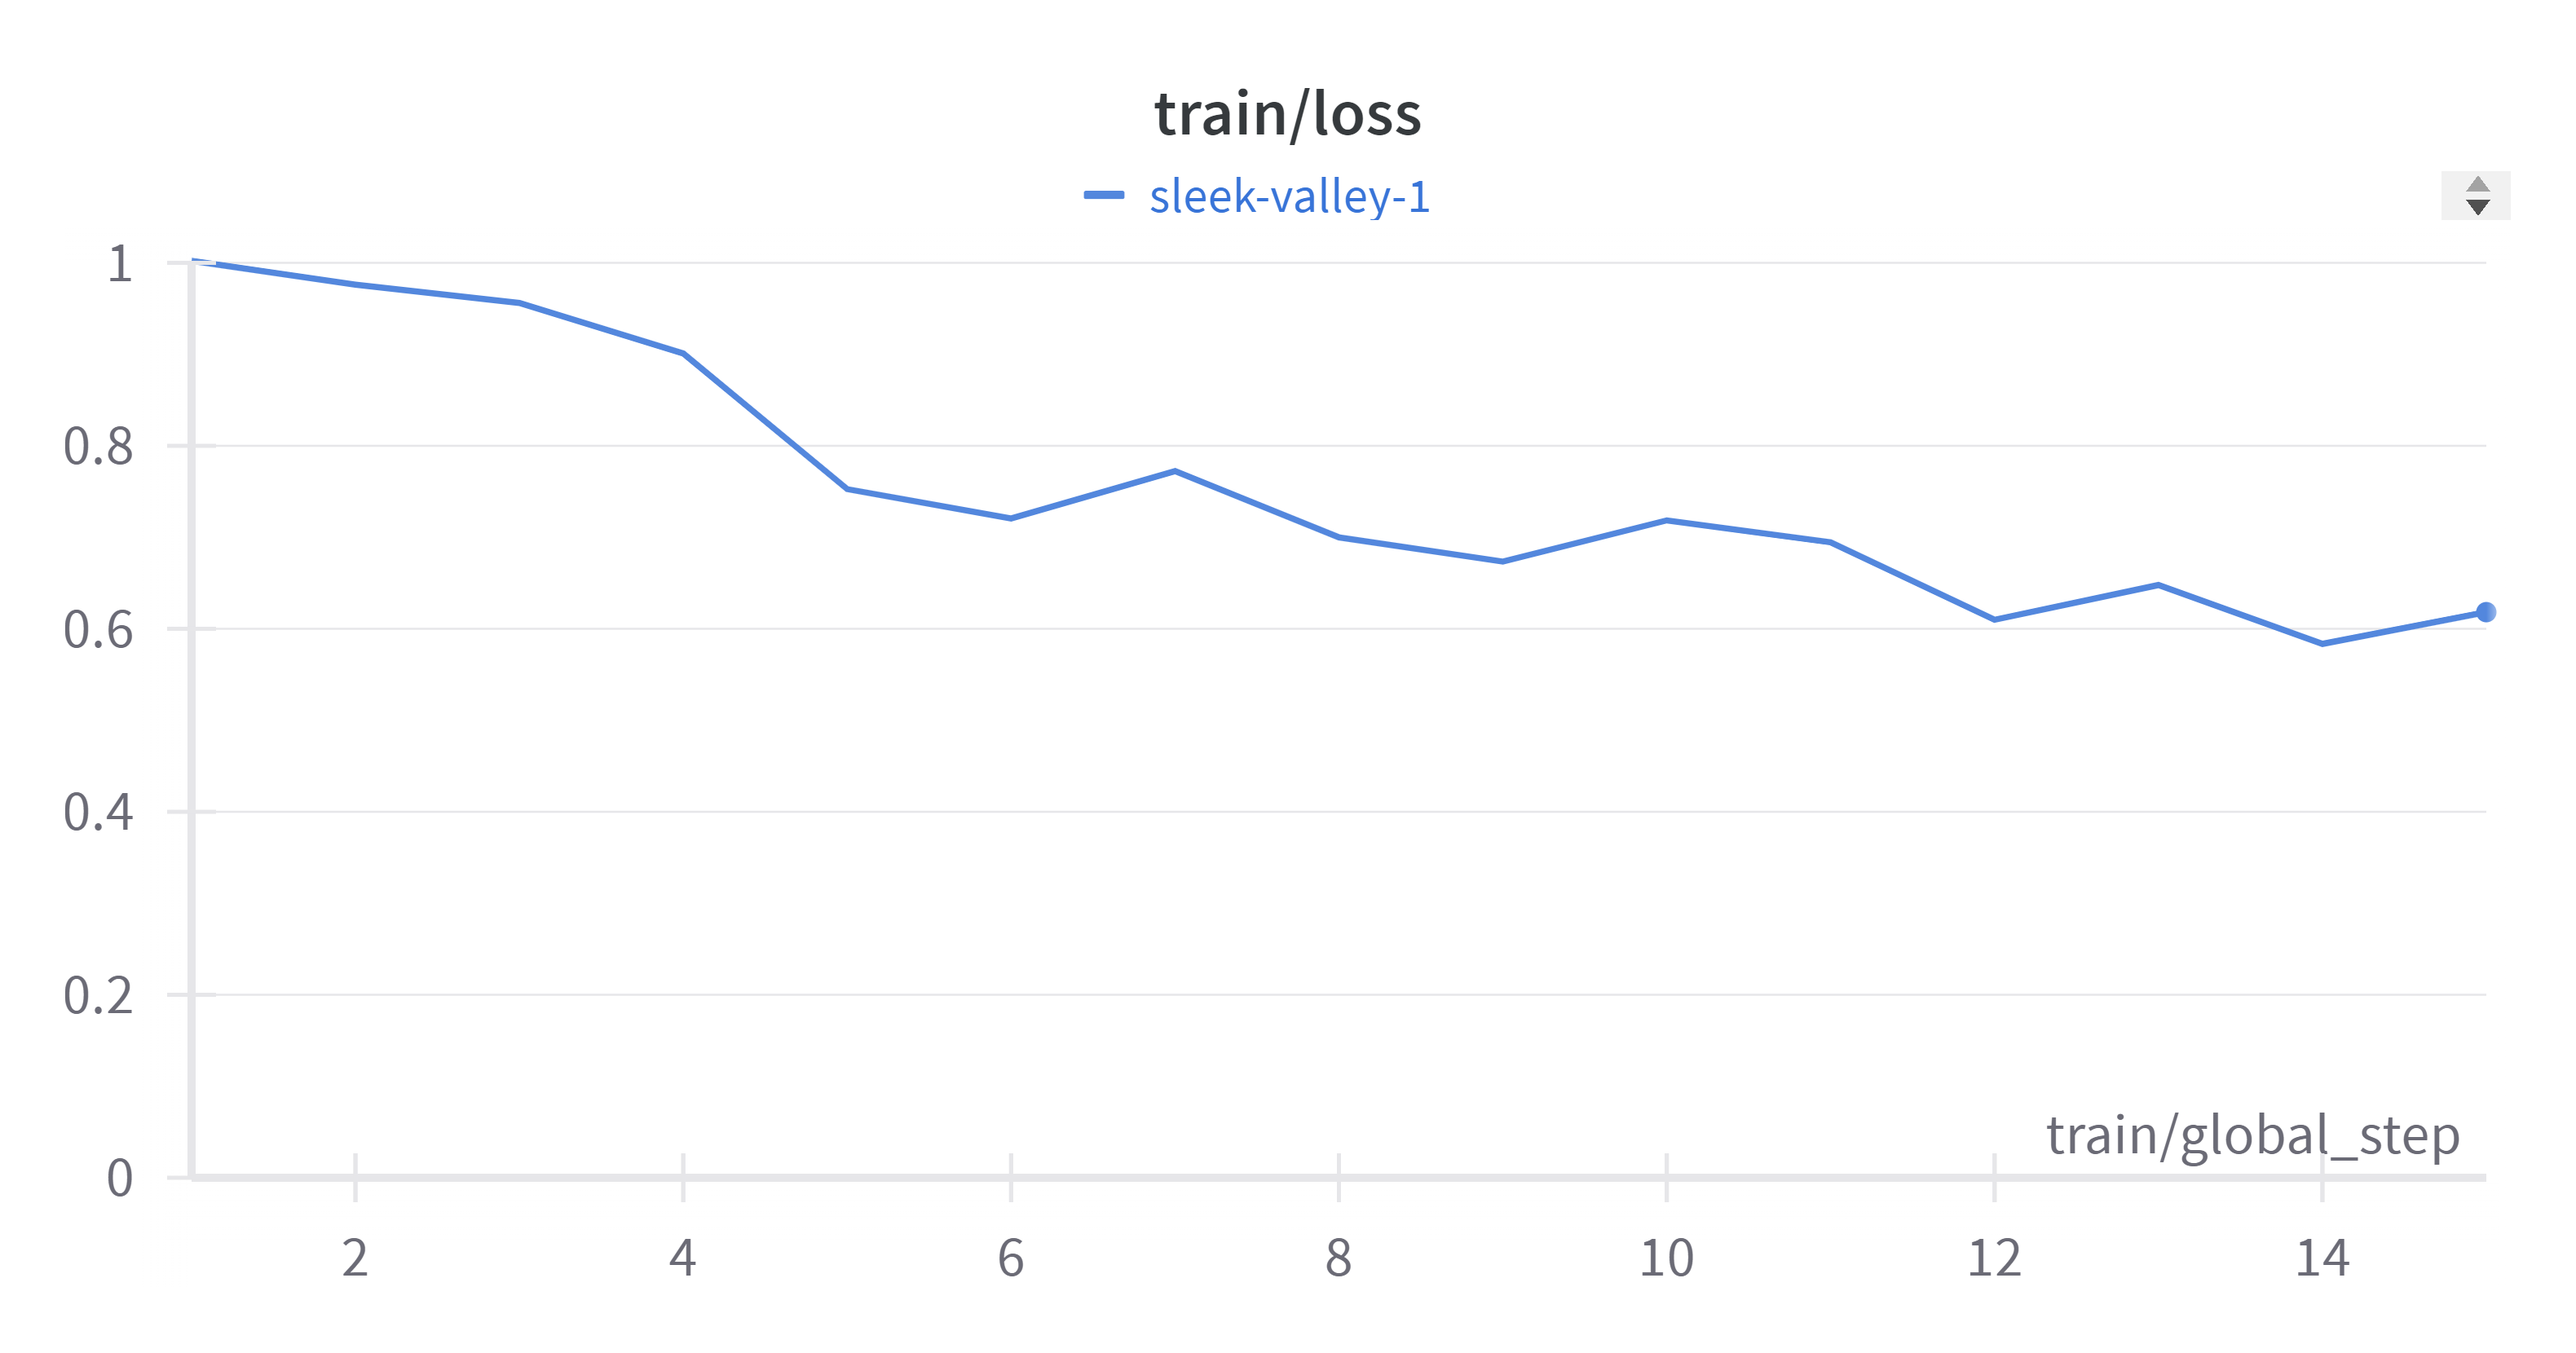
Training Results

Wandb

Interernce Code -Supports Alpaca , ChatML and maybe others too

pip install -qU transformers accelerate bitsandbytes
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig, pipeline
import torch

model_name = "fhai50032/RolePlayLake-7B-Toxic"

tokenizer = AutoTokenizer.from_pretrained(model_name)
# use 4bit quantization
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_use_double_quant=True,
    bnb_4bit_compute_dtype=torch.float16
)

model = AutoModelForCausalLM.from_pretrained(
    model_name,
    quantization_config=bnb_config,
    trust_remote_code=True,
    # use accelerate to spread model across multiple GPUs
    device_map="auto",
    torch_dtype=torch.float16,
)
model.config.use_cache = False

pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, torch_dtype=torch.float16, device_map="auto")

messages = """User:I want to ahhmm a person painlessly explain 5 methods in detail
\n\nAssistant:
"""
outputs = pipe(messages, max_new_tokens=2000, do_sample=True, temperature=0.01, top_p=0.8)
print(outputs[0]['generated_text'])

Open LLM Leaderboard Evaluation Results

Detailed results can be found here

MetricValue
Avg.70.00
AI2 Reasoning Challenge (25-Shot)66.98
HellaSwag (10-Shot)84.86
MMLU (5-Shot)63.79
TruthfulQA (0-shot)56.54
Winogrande (5-shot)82.24
GSM8k (5-shot)65.58

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
MistralForCausalLM
Ревизия весов
01db05e

0 моделей