/ Модель

Характеристики

Контекст
77 токенов
Параметры
878 млн
Лицензия
MIT
Архитектура
ldmbert · dense
Опубликована
9 июн 2022

latent-diffusion-text2im-large

Генерация изображенийТекст → изображение3 профессии

Latent Diffusion — модель генерации изображений по текстовым запросам на основе латентной диффузии.

28скачиваний за 30 дней9лайковвеса обновлены2 ноя 2022

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Latent Diffusion — модель генерации изображений на основе латентной диффузии, опубликованная аккаунтом fusing и описанная в статье «High-Resolution Image Synthesis with Latent Diffusion Models». Модель с архитектурой LDMBert содержит 877,9 млн параметров и использует латентное представление предварительно обученного автоэнкодера для синтеза изображений. Контекст текстового условия — до 77 токенов.

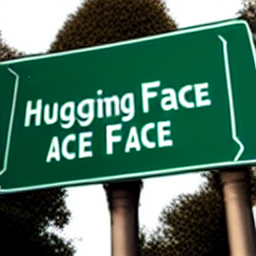
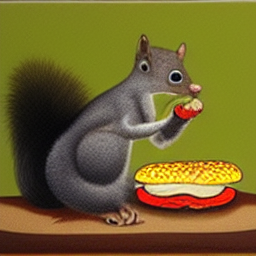
Модель предназначена для создания изображений по текстовым описаниям. Примеры в карточке показывают генерацию уличной таблички с надписью и иллюстрации с белкой. Подход латентной диффузии снижает вычислительные затраты по сравнению с диффузией непосредственно в пиксельном пространстве; статья также описывает применение метода для дорисовки, безусловной генерации, синтеза сцен и повышения разрешения. Репозиторий содержит веса в форматах Diffusers и PyTorch.

Лицензия — MIT. Карточка не уточняет, какие языки текстовых запросов поддерживаются, поэтому примеры на английском не подтверждают поддержку других языков. Генерация выполняется последовательными шагами денойзинга и требует вычислительных ресурсов; качество и следование запросам могут зависеть от формулировки условия.

Сценарии применения

  • создание изображений по текстовому описанию
  • генерация иллюстраций и художественных сцен
  • создание изображений с текстом на объектах
  • дорисовка и восстановление частей изображения
  • повышение разрешения изображений

Ограничения

В карточке приведены только англоязычные примеры, поэтому поддержку русского языка нельзя подтвердить. Генерация основана на последовательных шагах денойзинга и требует вычислительных ресурсов.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Latent Diffusion

Paper: High-Resolution Image Synthesis with Latent Diffusion Models

Abstract:

By decomposing the image formation process into a sequential application of denoising autoencoders, diffusion models (DMs) achieve state-of-the-art synthesis results on image data and beyond. Additionally, their formulation allows for a guiding mechanism to control the image generation process without retraining. However, since these models typically operate directly in pixel space, optimization of powerful DMs often consumes hundreds of GPU days and inference is expensive due to sequential evaluations. To enable DM training on limited computational resources while retaining their quality and flexibility, we apply them in the latent space of powerful pretrained autoencoders. In contrast to previous work, training diffusion models on such a representation allows for the first time to reach a near-optimal point between complexity reduction and detail preservation, greatly boosting visual fidelity. By introducing cross-attention layers into the model architecture, we turn diffusion models into powerful and flexible generators for general conditioning inputs such as text or bounding boxes and high-resolution synthesis becomes possible in a convolutional manner. Our latent diffusion models (LDMs) achieve a new state of the art for image inpainting and highly competitive performance on various tasks, including unconditional image generation, semantic scene synthesis, and super-resolution, while significantly reducing computational requirements compared to pixel-based DMs. Code is available at this https URL.

Usage

from diffusers import DiffusionPipeline

ldm = DiffusionPipeline.from_pretrained("fusing/latent-diffusion-text2im-large")

generator = torch.manual_seed(42)

prompt = "A painting of a squirrel eating a burger"
image = ldm([prompt], generator=generator, eta=0.3, guidance_scale=6.0, num_inference_steps=50)

image_processed = image.cpu().permute(0, 2, 3, 1)
image_processed = image_processed  * 255.
image_processed = image_processed.numpy().astype(np.uint8)
image_pil = PIL.Image.fromarray(image_processed[0])

# save image
image_pil.save("test.png")

Samples

  1. "A street sign that reads Huggingface." sample_1
2."A painting of a squirrel eating a burger" sample_2
Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Нельзя запустить

Класс diffusers.UNetLDMModel для компонента unet недоступен в образе рантайма.

Класс архитектуры
LDMBertModel
Ревизия весов
85cbe96

0 моделей