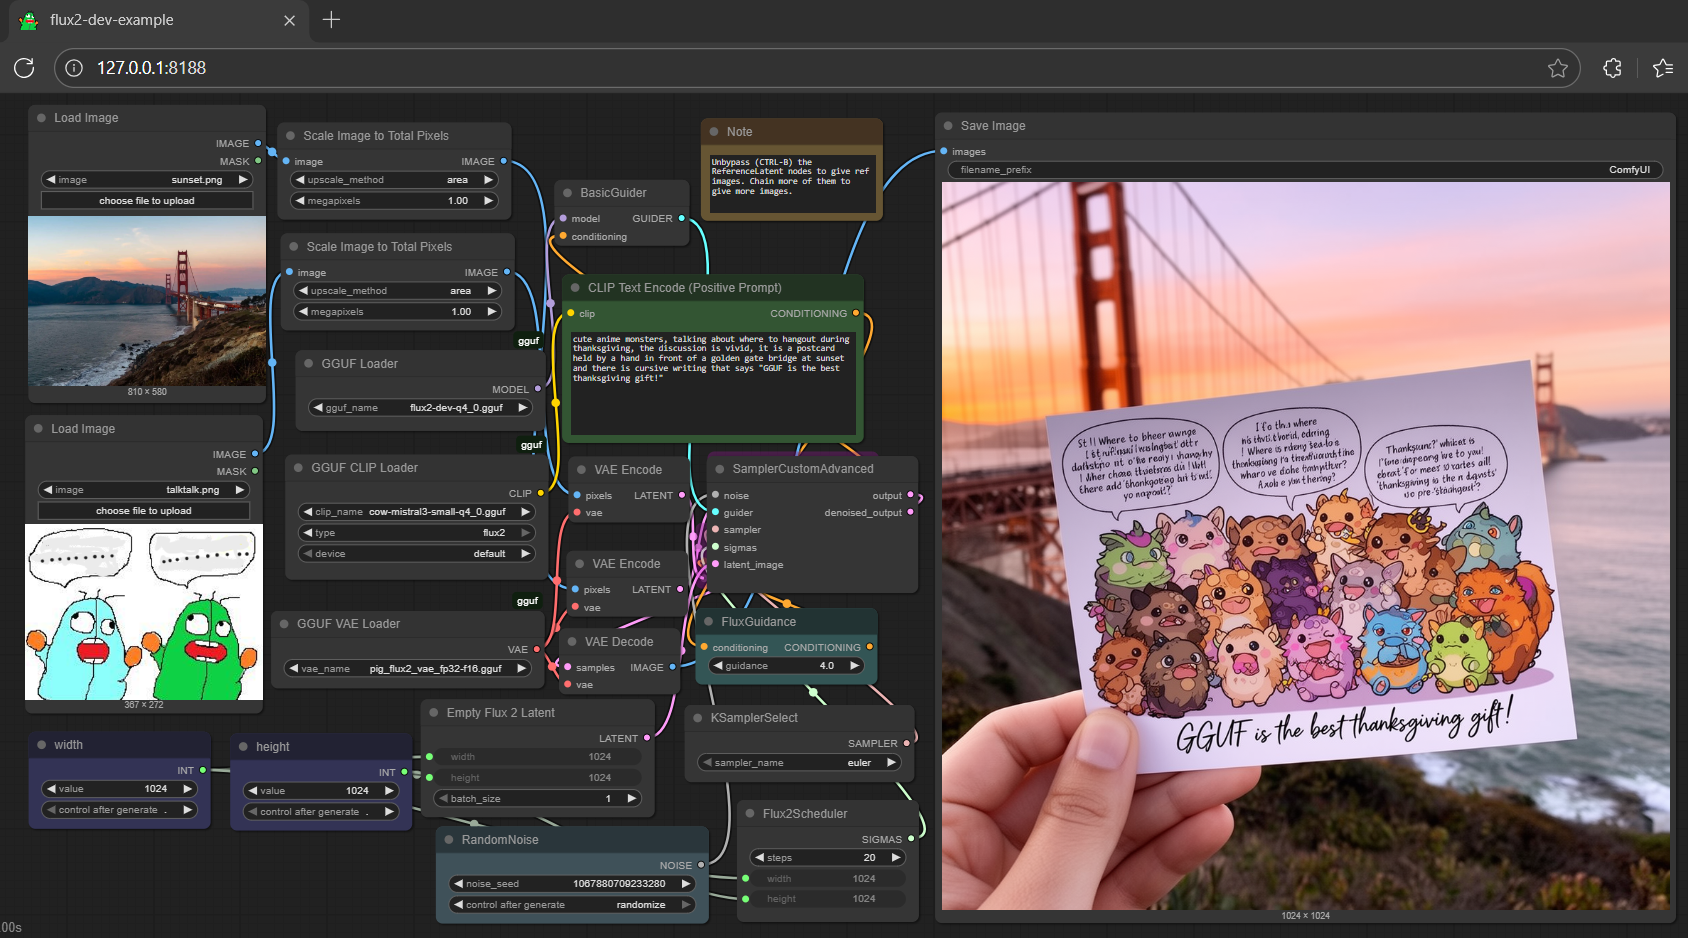
Модель предназначена для генерации и преобразования изображений по текстовым описаниям в ComfyUI; в README она обозначена как image-to-image и демонстрирует создание сложных сцен, персонажей, открыток, надписей и композиций с несколькими объектами.
Для работы используются отдельные компоненты: текстовый энкодер cow размещается в каталоге ComfyUI/models/text_encoders, модель flux2 — в ComfyUI/models/diffusion_models, а pig — в ComfyUI/models/vae. Поддерживаются совместимые GGUF-энкодеры, включая Magistral-Small-2509-GGUF и Mistral-Small-3.2-24B-Instruct-2506-GGUF. В README указано, что вариант квантования q2 работает, однако энкодер более высокого уровня лучше следует исходному запросу. Точные архитектура, размер, контекст и набор модальностей не указаны; заявлен английский язык.
Модель подходит для локальной генерации изображений и экспериментов с ComfyUI, особенно когда важны детализированные сцены и отображение текста на изображении. Ограничения включают зависимость от правильно установленных компонентов и возможное снижение точности следования промпту при использовании низкоуровневого q2-энкодера. Распространение регулируется лицензией flux-dev-non-commercial-license; коммерческое использование README не разрешает.