/ Модель

Характеристики

Контекст
512 токенов
Параметры
1 млрд
Лицензия
Apache 2.0
Архитектура
bert · dense
Опубликована
22 мая 2022

ScholarBERT-XL

Заполнение пропусковТекст → текст3 профессии

Англоязычная BERT-модель, предварительно обученная на научной литературе и предназначенная для заполнения пропусков в научных текстах.

47скачиваний за 30 дней8лайковвеса обновлены21 янв 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

ScholarBERT-XL100 — англоязычная модель семейства BERT от Globus Labs, предварительно обученная на 221 млрд токенов научных статей из корпуса PRD. Это чувствительная к регистру плотная модель с архитектурой BertForMaskedLM: 36 слоёв, размер скрытого состояния 1280, 20 голов внимания и контекст до 512 токенов. В README указано 770 млн параметров, тогда как метаданные Hugging Face сообщают 1 млрд.

Модель предназначена для заполнения пропусков в научных текстах на английском языке и может использоваться в сценариях продолжения или анализа научных формулировок через masked language modeling. Обучающий корпус охватывает гуманитарные науки, науки о жизни и биомедицину, физические и социальные науки, а также технологии. Доступны веса PyTorch и Safetensors. Лицензия — Apache 2.0.

Сценарии применения

  • Заполнение пропущенных слов в научных статьях
  • Подбор вероятного слова по контексту научного текста
  • Восстановление замаскированных терминов в англоязычных публикациях

Ограничения

Контекст ограничен 512 токенами, а модель чувствительна к регистру. В README и метаданных расходятся сведения о размере: указаны 770 млн и 1 млрд параметров соответственно.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

ScholarBERT-XL_100 Model

This is the ScholarBERT-XL_100 variant of the ScholarBERT model family.

The model is pretrained on a large collection of scientific research articles (221B tokens).

This is a cased (case-sensitive) model. The tokenizer will not convert all inputs to lower-case by default.

The model has a total of 770M parameters.

Model Architecture

HyperparameterValue
Layers36
Hidden Size1280
Attention Heads20
Total Parameters770M

Training Dataset

The vocab and the model are pertrained on 100% of the PRD scientific literature dataset.

The PRD dataset is provided by Public.Resource.Org, Inc. (“Public Resource”), a nonprofit organization based in California. This dataset was constructed from a corpus of journal article files, from which We successfully extracted text from 75,496,055 articles from 178,928 journals. The articles span across Arts & Humanities, Life Sciences & Biomedicine, Physical Sciences, Social Sciences, and Technology. The distribution of articles is shown below.
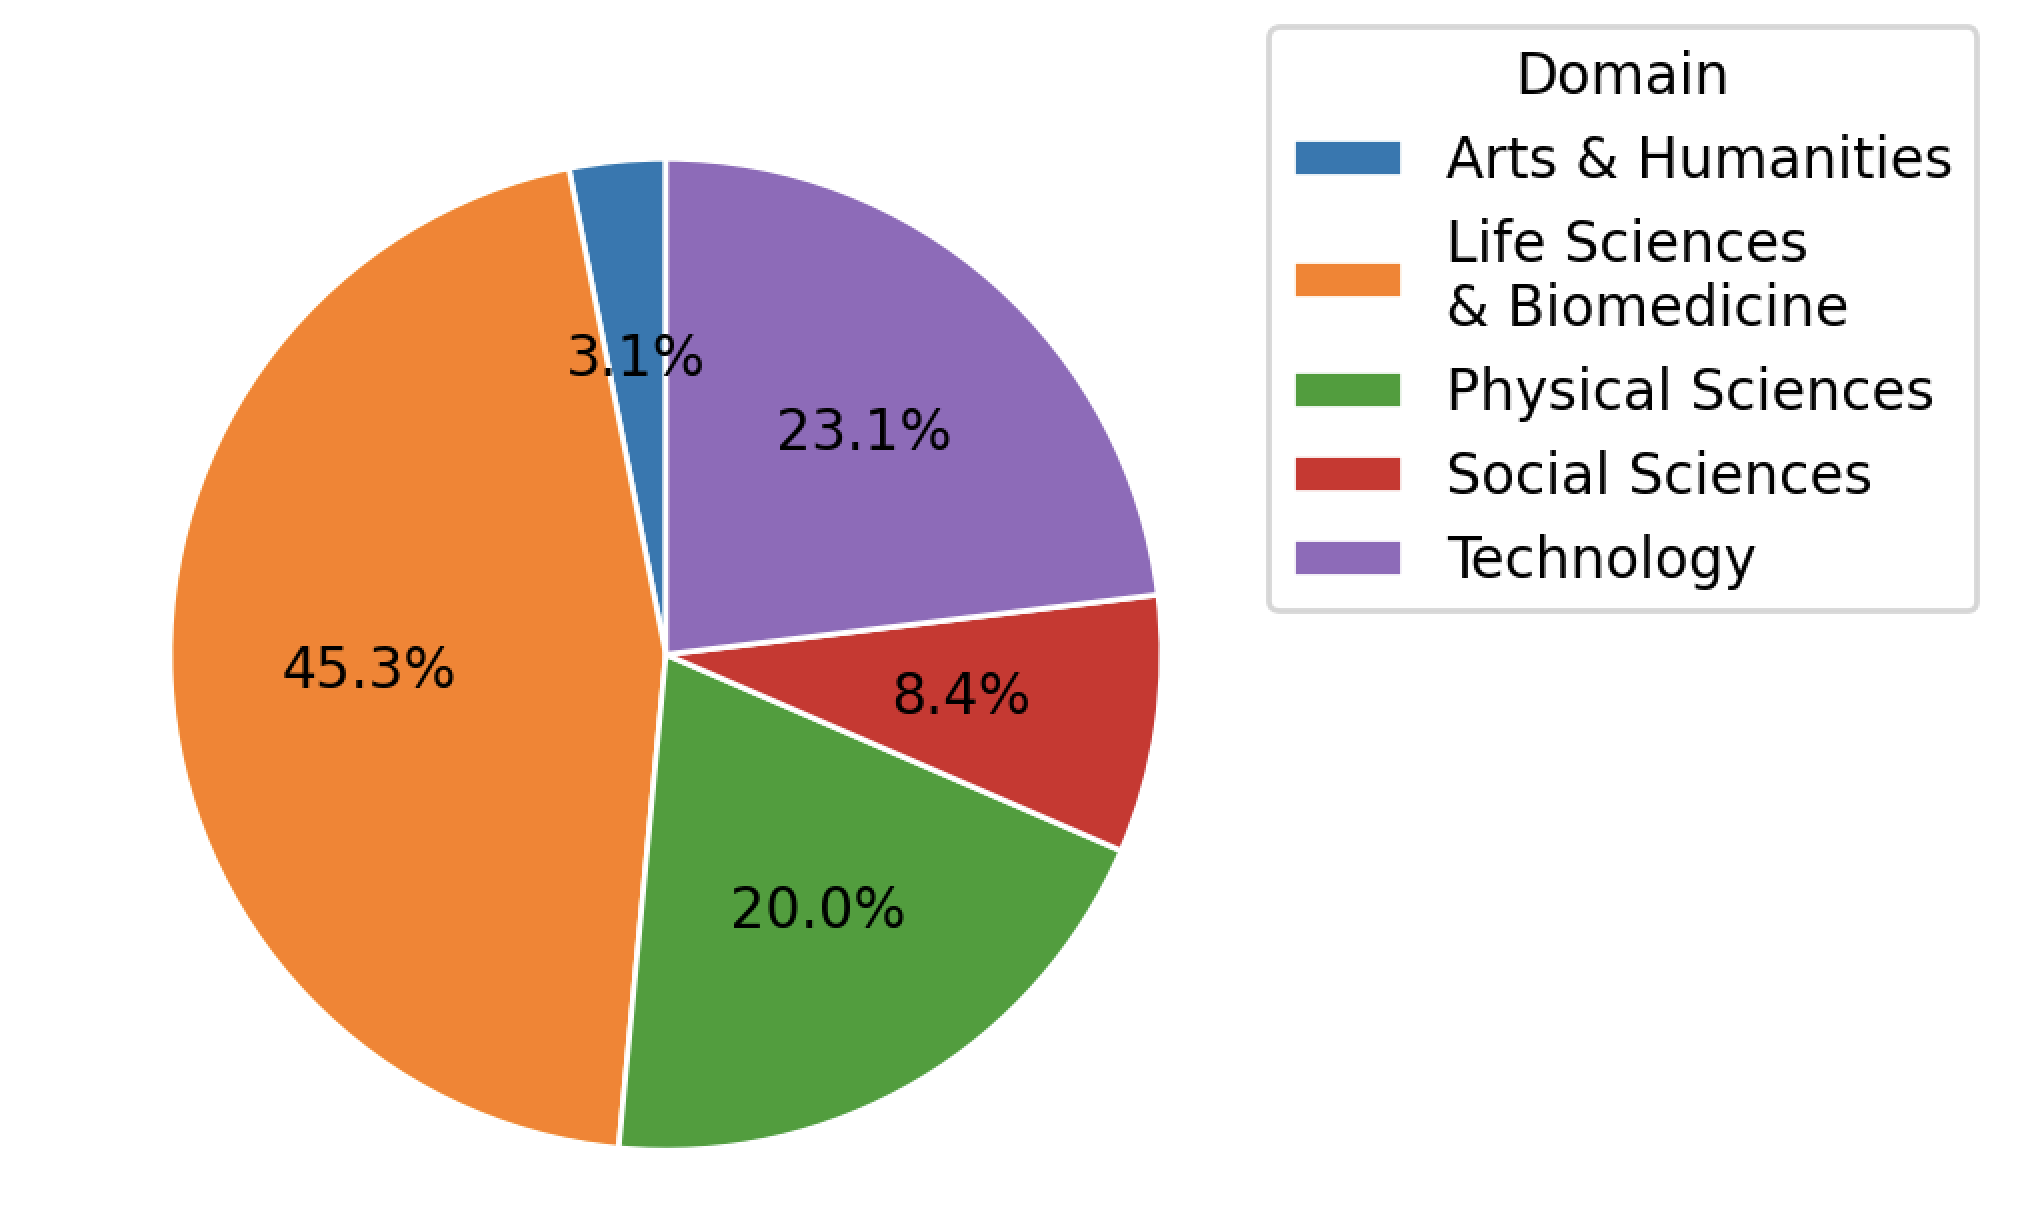
corpus pie chart

BibTeX entry and citation info

If using this model, please cite this paper:

@inproceedings{hong2023diminishing,
  title={The diminishing returns of masked language models to science},
  author={Hong, Zhi and Ajith, Aswathy and Pauloski, James and Duede, Eamon and Chard, Kyle and Foster, Ian},
  booktitle={Findings of the Association for Computational Linguistics: ACL 2023},
  pages={1270--1283},
  year={2023}
}

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · fill-mask

Можно запустить

Подбираем GPU…

Класс архитектуры
BertForMaskedLM
Ревизия весов
4ec1c7c

0 моделей