ByT5 - xl
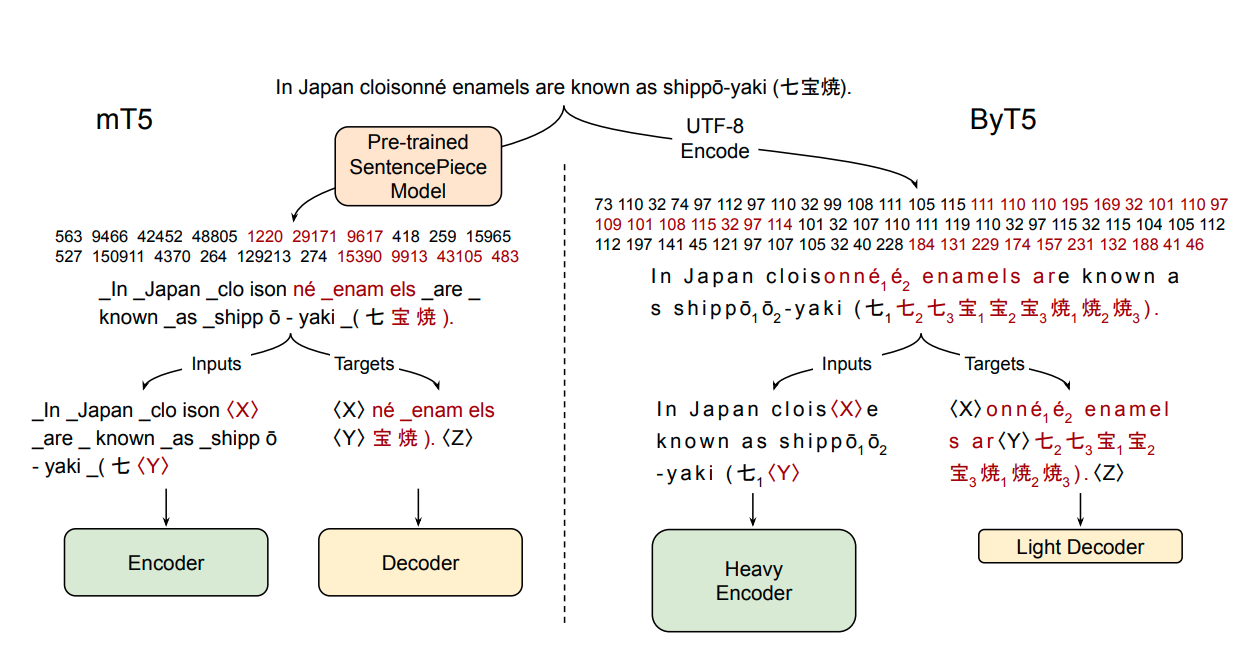
ByT5 is a tokenizer-free version of Google's T5 and generally follows the architecture of MT5.
ByT5 was only pre-trained on mC4 excluding any supervised training with an average span-mask of 20 UTF-8 characters. Therefore, this model has to be fine-tuned before it is useable on a downstream task.
ByT5 works especially well on noisy text data,e.g., google/byt5-xl significantly outperforms mt5-xl on TweetQA.
Paper: ByT5: Towards a token-free future with pre-trained byte-to-byte models
Authors: Linting Xue, Aditya Barua, Noah Constant, Rami Al-Rfou, Sharan Narang, Mihir Kale, Adam Roberts, Colin Raffel
Example Inference
ByT5 works on raw UTF-8 bytes and can be used without a tokenizer:
from transformers import T5ForConditionalGeneration
import torch

model = T5ForConditionalGeneration.from_pretrained('google/byt5-xl')

input_ids = torch.tensor([list("Life is like a box of chocolates.".encode("utf-8"))]) + 3  # add 3 for special tokens
labels = torch.tensor([list("La vie est comme une boîte de chocolat.".encode("utf-8"))]) + 3  # add 3 for special tokens

loss = model(input_ids, labels=labels).loss # forward pass
For batched inference & training it is however recommended using a tokenizer class for padding:
from transformers import T5ForConditionalGeneration, AutoTokenizer

model = T5ForConditionalGeneration.from_pretrained('google/byt5-xl')
tokenizer = AutoTokenizer.from_pretrained('google/byt5-xl')

model_inputs = tokenizer(["Life is like a box of chocolates.", "Today is Monday."], padding="longest", return_tensors="pt")
labels = tokenizer(["La vie est comme une boîte de chocolat.", "Aujourd'hui c'est lundi."], padding="longest", return_tensors="pt").input_ids

loss = model(**model_inputs, labels=labels).loss # forward pass
Abstract
Most widely-used pre-trained language models operate on sequences of tokens corresponding to word or subword units. Encoding text as a sequence of tokens requires a tokenizer, which is typically created as an independent artifact from the model. Token-free models that instead operate directly on raw text (bytes or characters) have many benefits: they can process text in any language out of the box, they are more robust to noise, and they minimize technical debt by removing complex and error-prone text preprocessing pipelines. Since byte or character sequences are longer than token sequences, past work on token-free models has often introduced new model architectures designed to amortize the cost of operating directly on raw text. In this paper, we show that a standard Transformer architecture can be used with minimal modifications to process byte sequences. We carefully characterize the trade-offs in terms of parameter count, training FLOPs, and inference speed, and show that byte-level models are competitive with their token-level counterparts. We also demonstrate that byte-level models are significantly more robust to noise and perform better on tasks that are sensitive to spelling and pronunciation. As part of our contribution, we release a new set of pre-trained byte-level Transformer models based on the T5 architecture, as well as all code and data used in our experiments.