/ Модель

Характеристики

Контекст
512 токенов
Параметры
1,5 млрд
Лицензия
Apache 2.0
Архитектура
t5 · dense
Опубликована
2 мар 2022

t5-xl-ssm-nq

Генерация текстаТекст → текст3 профессии

Модель Google T5-XL отвечает на текстовые вопросы без внешнего контекста, используя знания, усвоенные при обучении.

362скачиваний за 30 дней3лайкавеса обновлены24 янв 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Google T5-XL SSM-NQ — encoder-decoder-модель семейства T5 на 1,5 млрд параметров для ответов на вопросы без обращения к внешним документам. Модель сначала обучалась на задаче восстановления текста на C4, затем дополнительно обучалась на Wikipedia с целью salient span masking, после чего была дообучена на Natural Questions: 10 тысяч шагов на полной обучающей выборке.

Модель принимает текстовый вопрос и генерирует текстовый ответ, используя знания, усвоенные при обучении. Она предназначена для закрытого книжного ответа на вопросы и оценки таких систем на Natural Questions. Репозиторий содержит веса PyTorch и TensorFlow; модель распространяется по лицензии Apache-2.0.

Сценарии применения

  • ответы на вопросы по общим знаниям без поиска по документам
  • закрытое книжное извлечение ответов из знаний модели
  • оценка систем ответов на вопросы на датасете Natural Questions

Ограничения

Ответы основаны на знаниях, усвоенных при обучении, и модель не получает внешние источники для проверки актуальности или подтверждения фактов. Дообучение выполнено на Natural Questions, поэтому качество за пределами подобных задач и данных может отличаться.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Google's T5 for Closed Book Question Answering.

The model was pre-trained using T5's denoising objective on C4, subsequently additionally pre-trained using REALM's salient span masking objective on Wikipedia, and finally fine-tuned on Natural Questions (NQ).

Note: The model was fine-tuned on 100% of the train splits of Natural Questions (NQ) for 10k steps.

Other community Checkpoints: here

Paper: How Much Knowledge Can You Pack Into the Parameters of a Language Model?

Authors: Adam Roberts, Colin Raffel, Noam Shazeer

Results on Natural Questions - Test Set

IdlinkExact Match
T5-smallhttps://huggingface.co/google/t5-small-ssm-nq25.5
T5-largehttps://huggingface.co/google/t5-large-ssm-nq30.4
T5-xlhttps://huggingface.co/google/t5-xl-ssm-nq35.6
T5-xxlhttps://huggingface.co/google/t5-xxl-ssm-nq37.9
T5-3bhttps://huggingface.co/google/t5-3b-ssm-nq33.2
T5-11bhttps://huggingface.co/google/t5-11b-ssm-nq36.6

Usage

The model can be used as follows for closed book question answering:

from transformers import AutoModelForSeq2SeqLM, AutoTokenizer

t5_qa_model = AutoModelForSeq2SeqLM.from_pretrained("google/t5-xl-ssm-nq")
t5_tok = AutoTokenizer.from_pretrained("google/t5-xl-ssm-nq")

input_ids = t5_tok("When was Franklin D. Roosevelt born?", return_tensors="pt").input_ids
gen_output = t5_qa_model.generate(input_ids)[0]

print(t5_tok.decode(gen_output, skip_special_tokens=True))

Abstract

It has recently been observed that neural language models trained on unstructured text can implicitly store and retrieve knowledge using natural language queries. In this short paper, we measure the practical utility of this approach by fine-tuning pre-trained models to answer questions without access to any external context or knowledge. We show that this approach scales with model size and performs competitively with open-domain systems that explicitly retrieve answers from an external knowledge source when answering questions. To facilitate reproducibility and future work, we release our code and trained models at https://goo.gle/t5-cbqa.
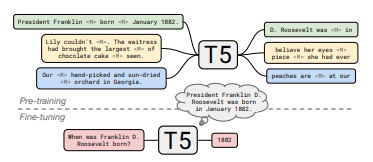
model image

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
T5ForConditionalGeneration
Ревизия весов
64549ec

0 моделей