Evt_V4-preview
EVT series is an experimental project for finetune with large datasets on animation style model. Evt_V4 uses a larger dataset than before, and its cosine similarity with ACertainty reaches 85%. It may behave differently from other models, hope you enjoy it.
🧨 Diffusers
This model can be used just like any other Stable Diffusion model. For more information, please have a look at the Stable Diffusion.
You can also export the model to ONNX, MPS and/or FLAX/JAX.
from diffusers import StableDiffusionPipeline
import torch

model_id = "haor/Evt_V4-preview"
branch_name= "main"

pipe = StableDiffusionPipeline.from_pretrained(model_id, revision=branch_name, torch_dtype=torch.float16)
pipe = pipe.to("cuda")

prompt = "1girl"
image = pipe(prompt).images[0]

image.save("./1girl.png")
Examples
Prompt1:
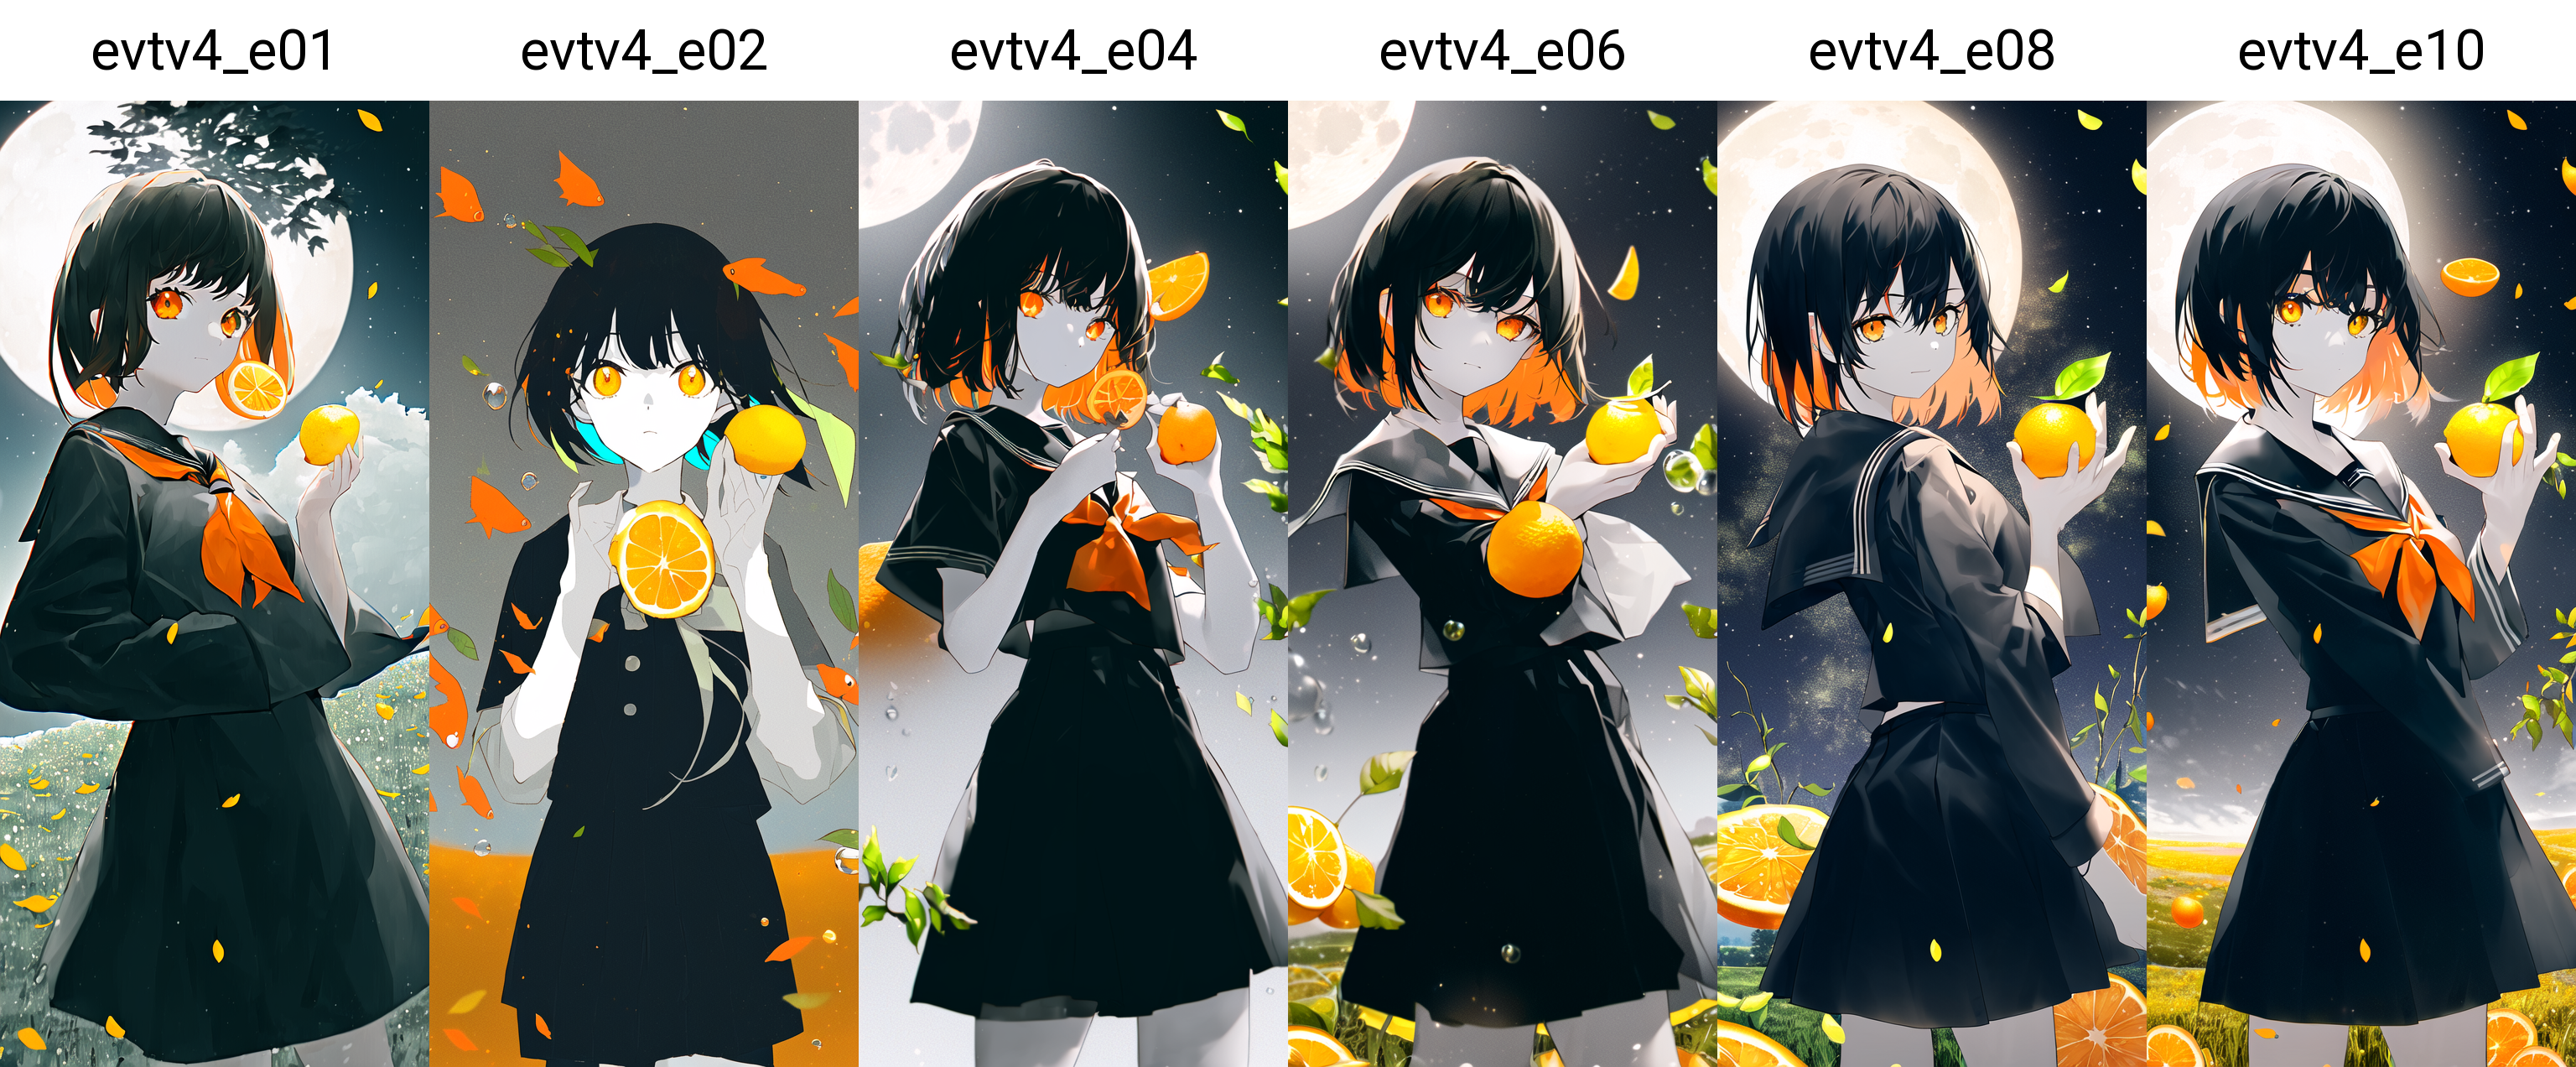
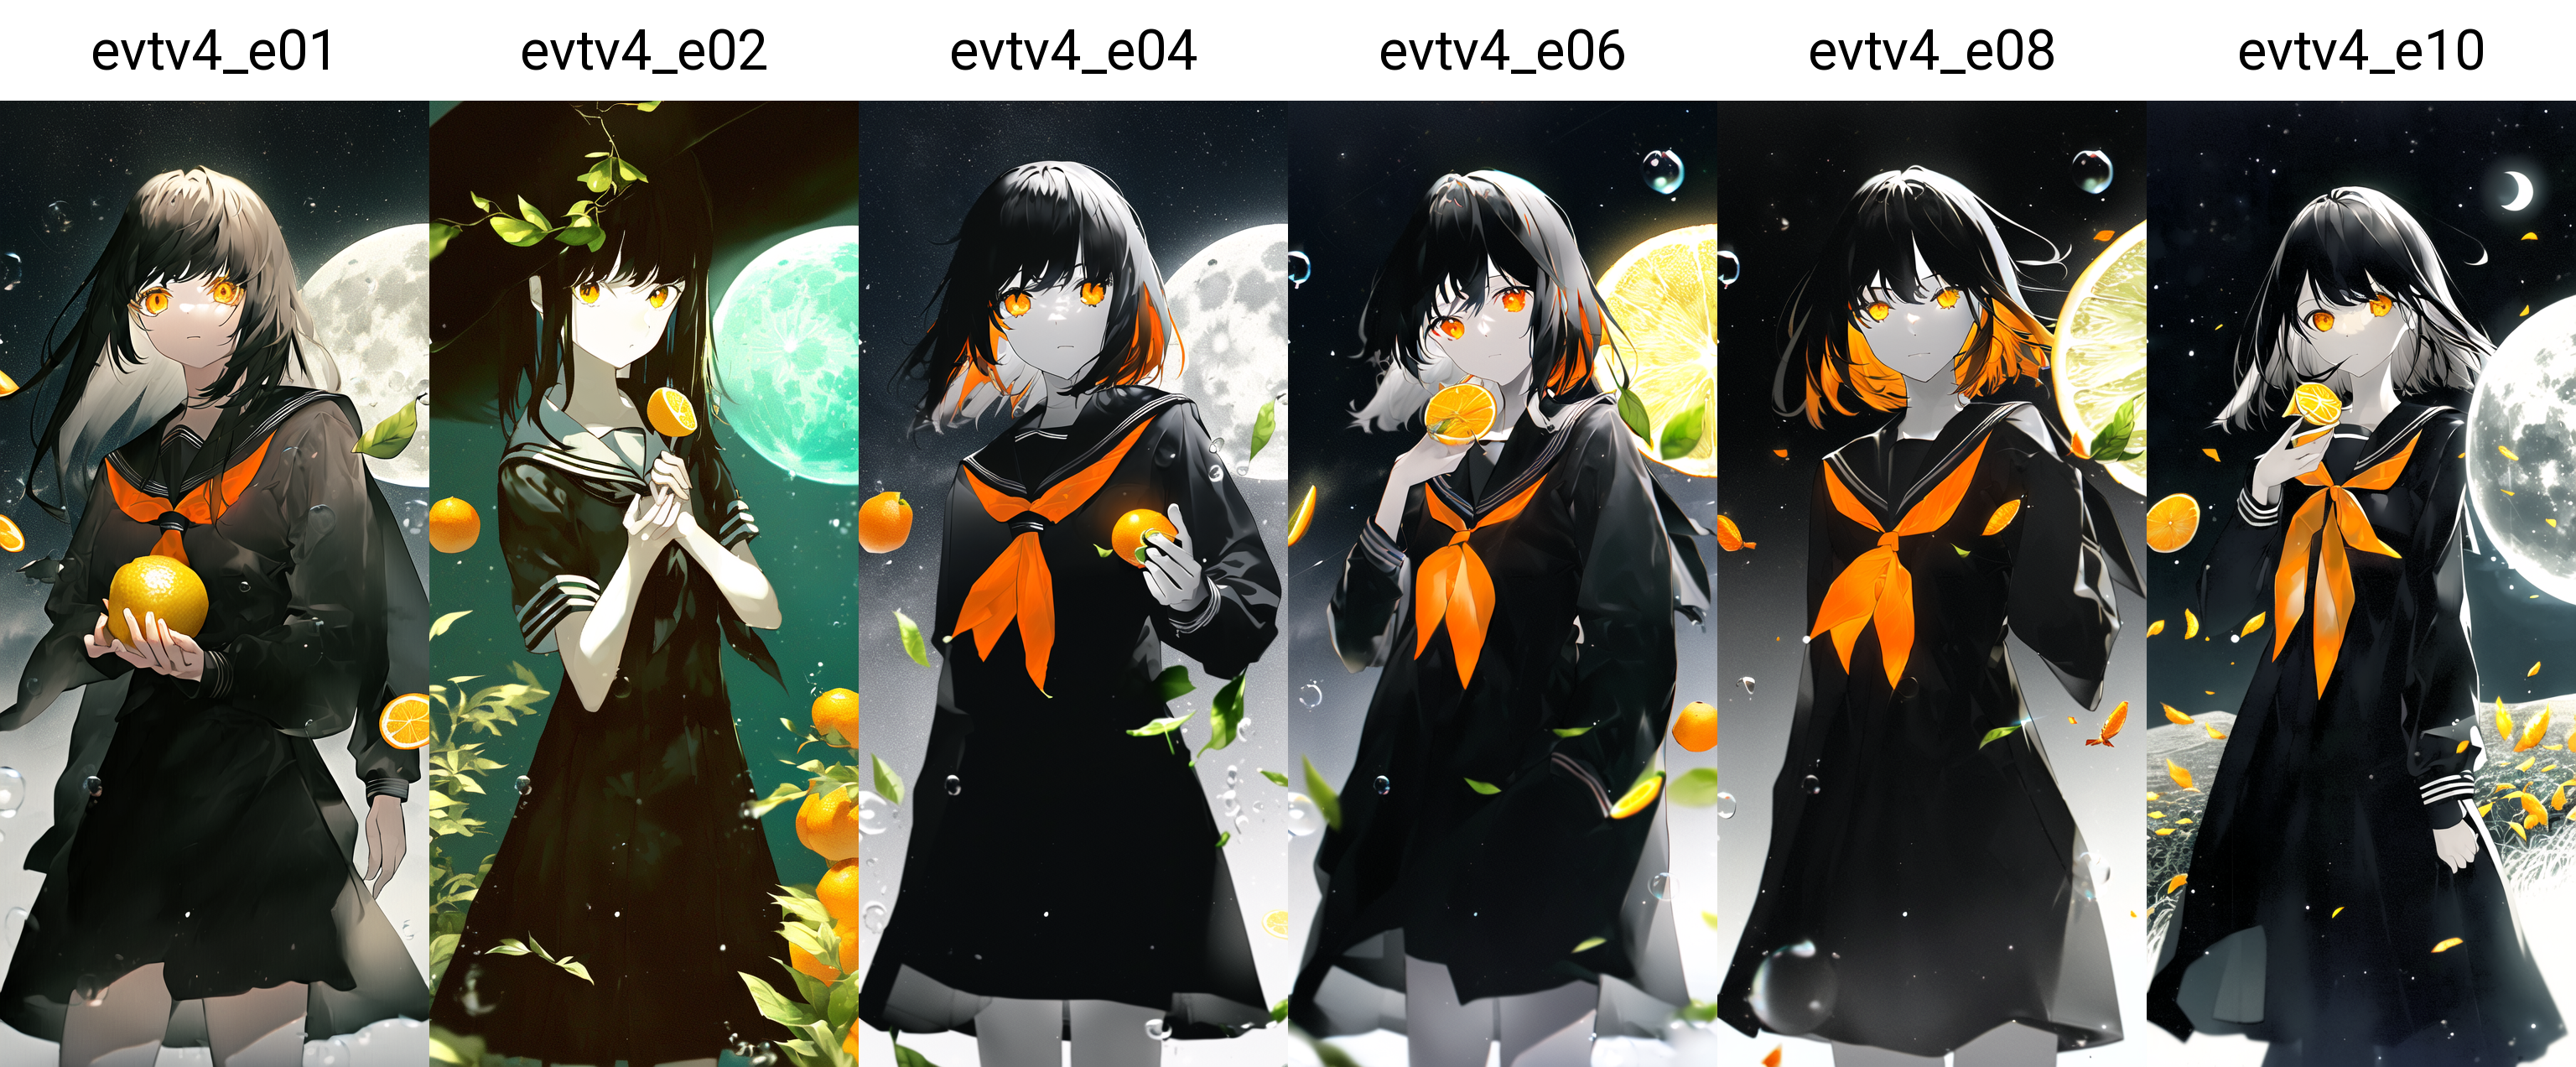
1girl in black serafuku standing in a field solo, food, fruit, lemon, bubble, planet, moon, orange \(fruit\), lemon slice, leaf, fish, orange slice, by (tabi:1.25), spot color, looking at viewer, closeup cowboy shot
Negative prompt: (bad:0.81), (comic:0.81), (cropped:0.81), (error:0.81), (extra:0.81), (low:0.81), (lowres:0.81), (speech:0.81), (worst:0.81), (blush:0.9), 2koma, 3koma, 4koma, collage, lipstick
Steps: 20, Sampler: DPM++ SDE Karras, CFG scale: 7, Seed: 2285895007, Size: 512x1152, Denoising strength: 0.7, Clip skip: 2
Prompt2:
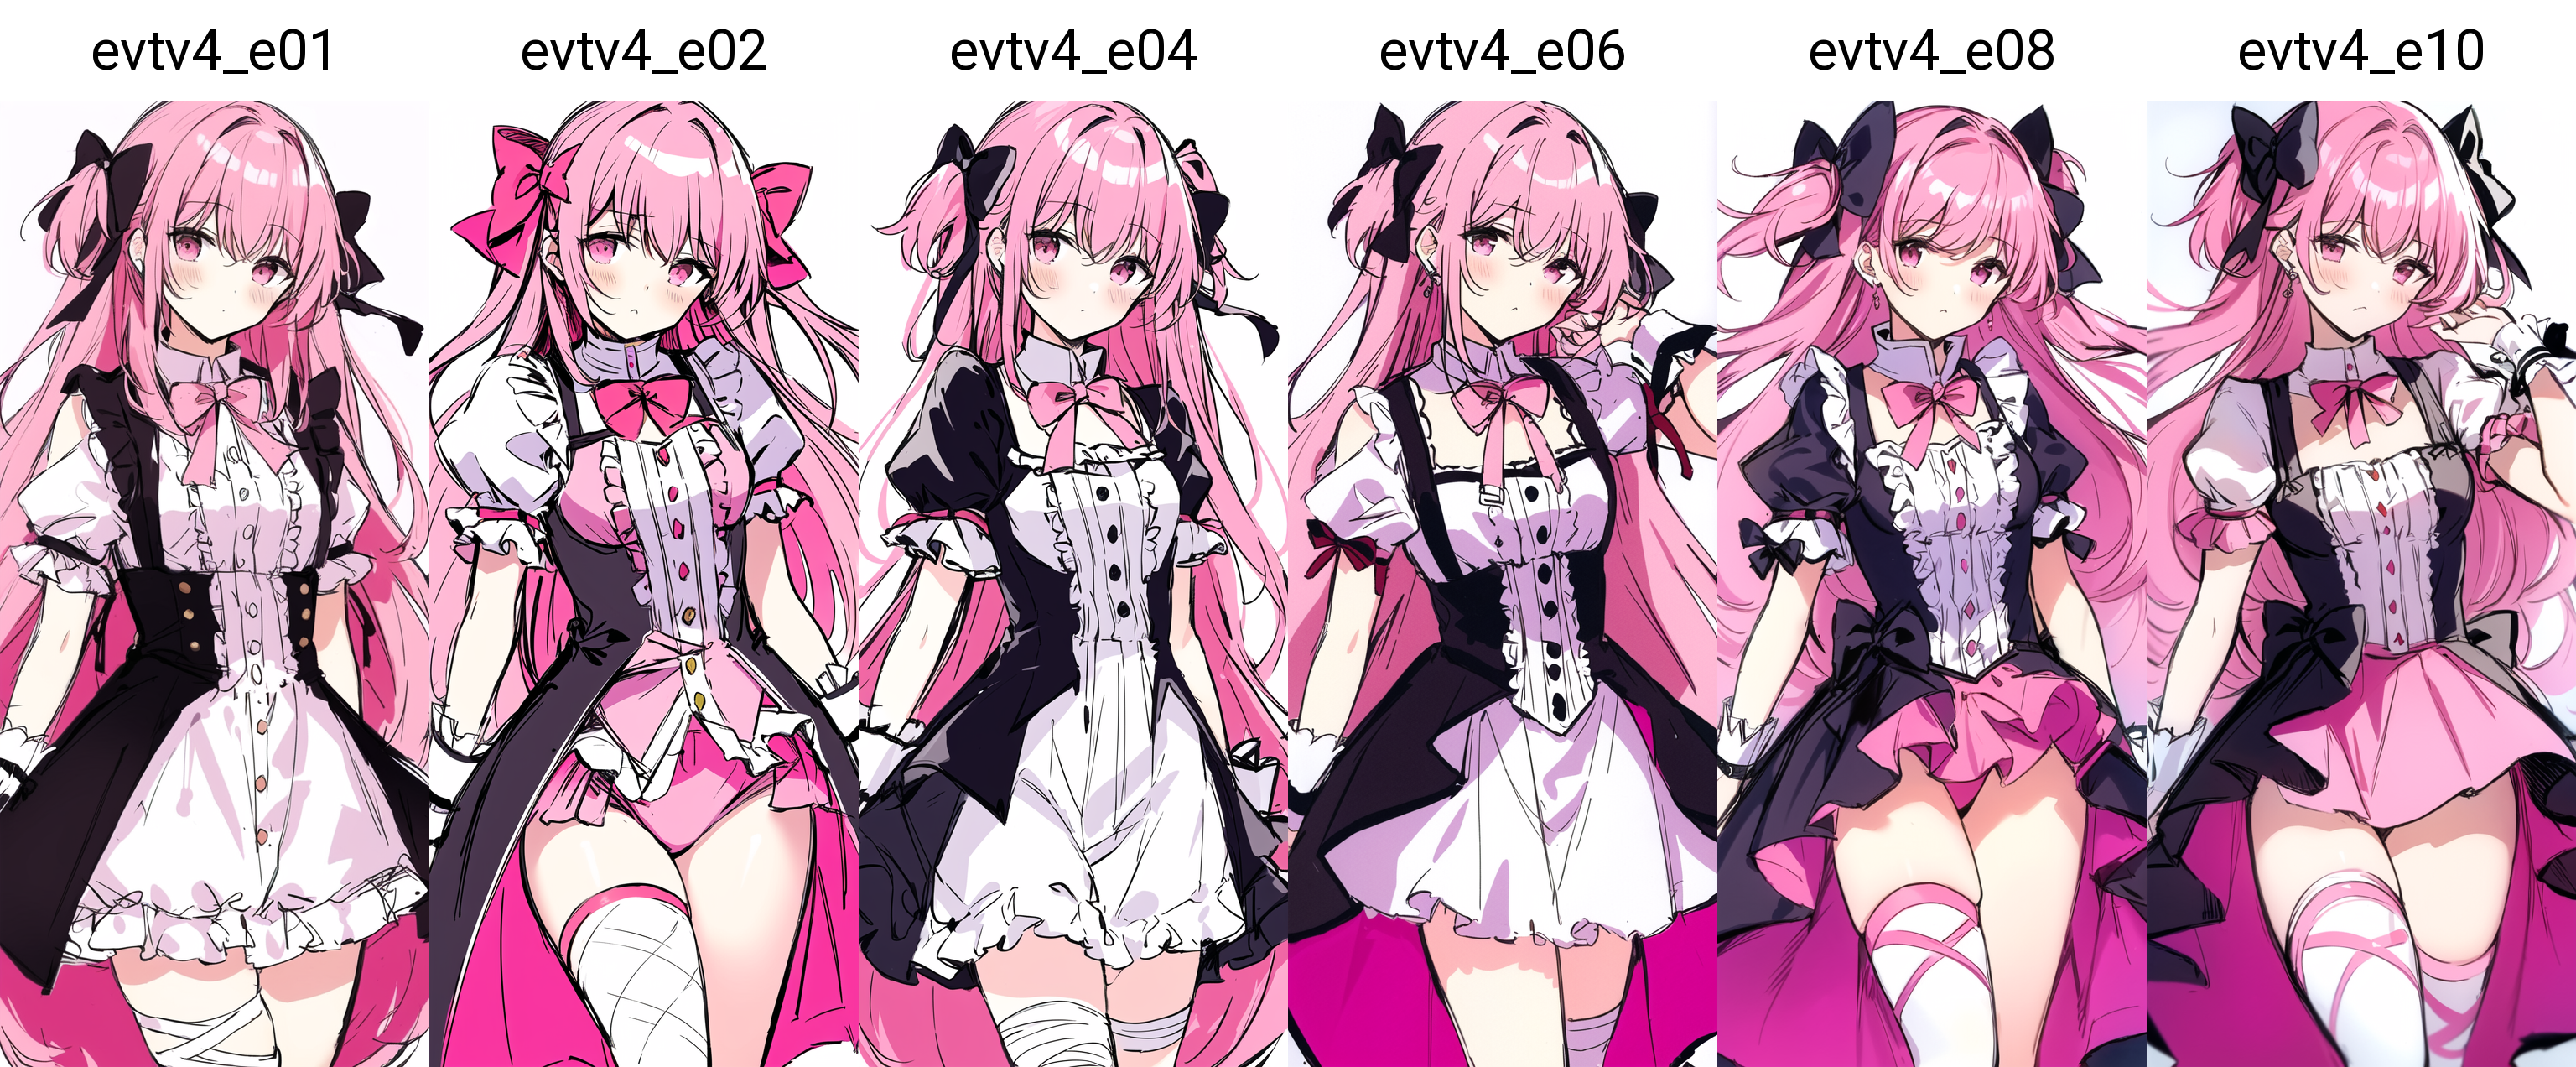
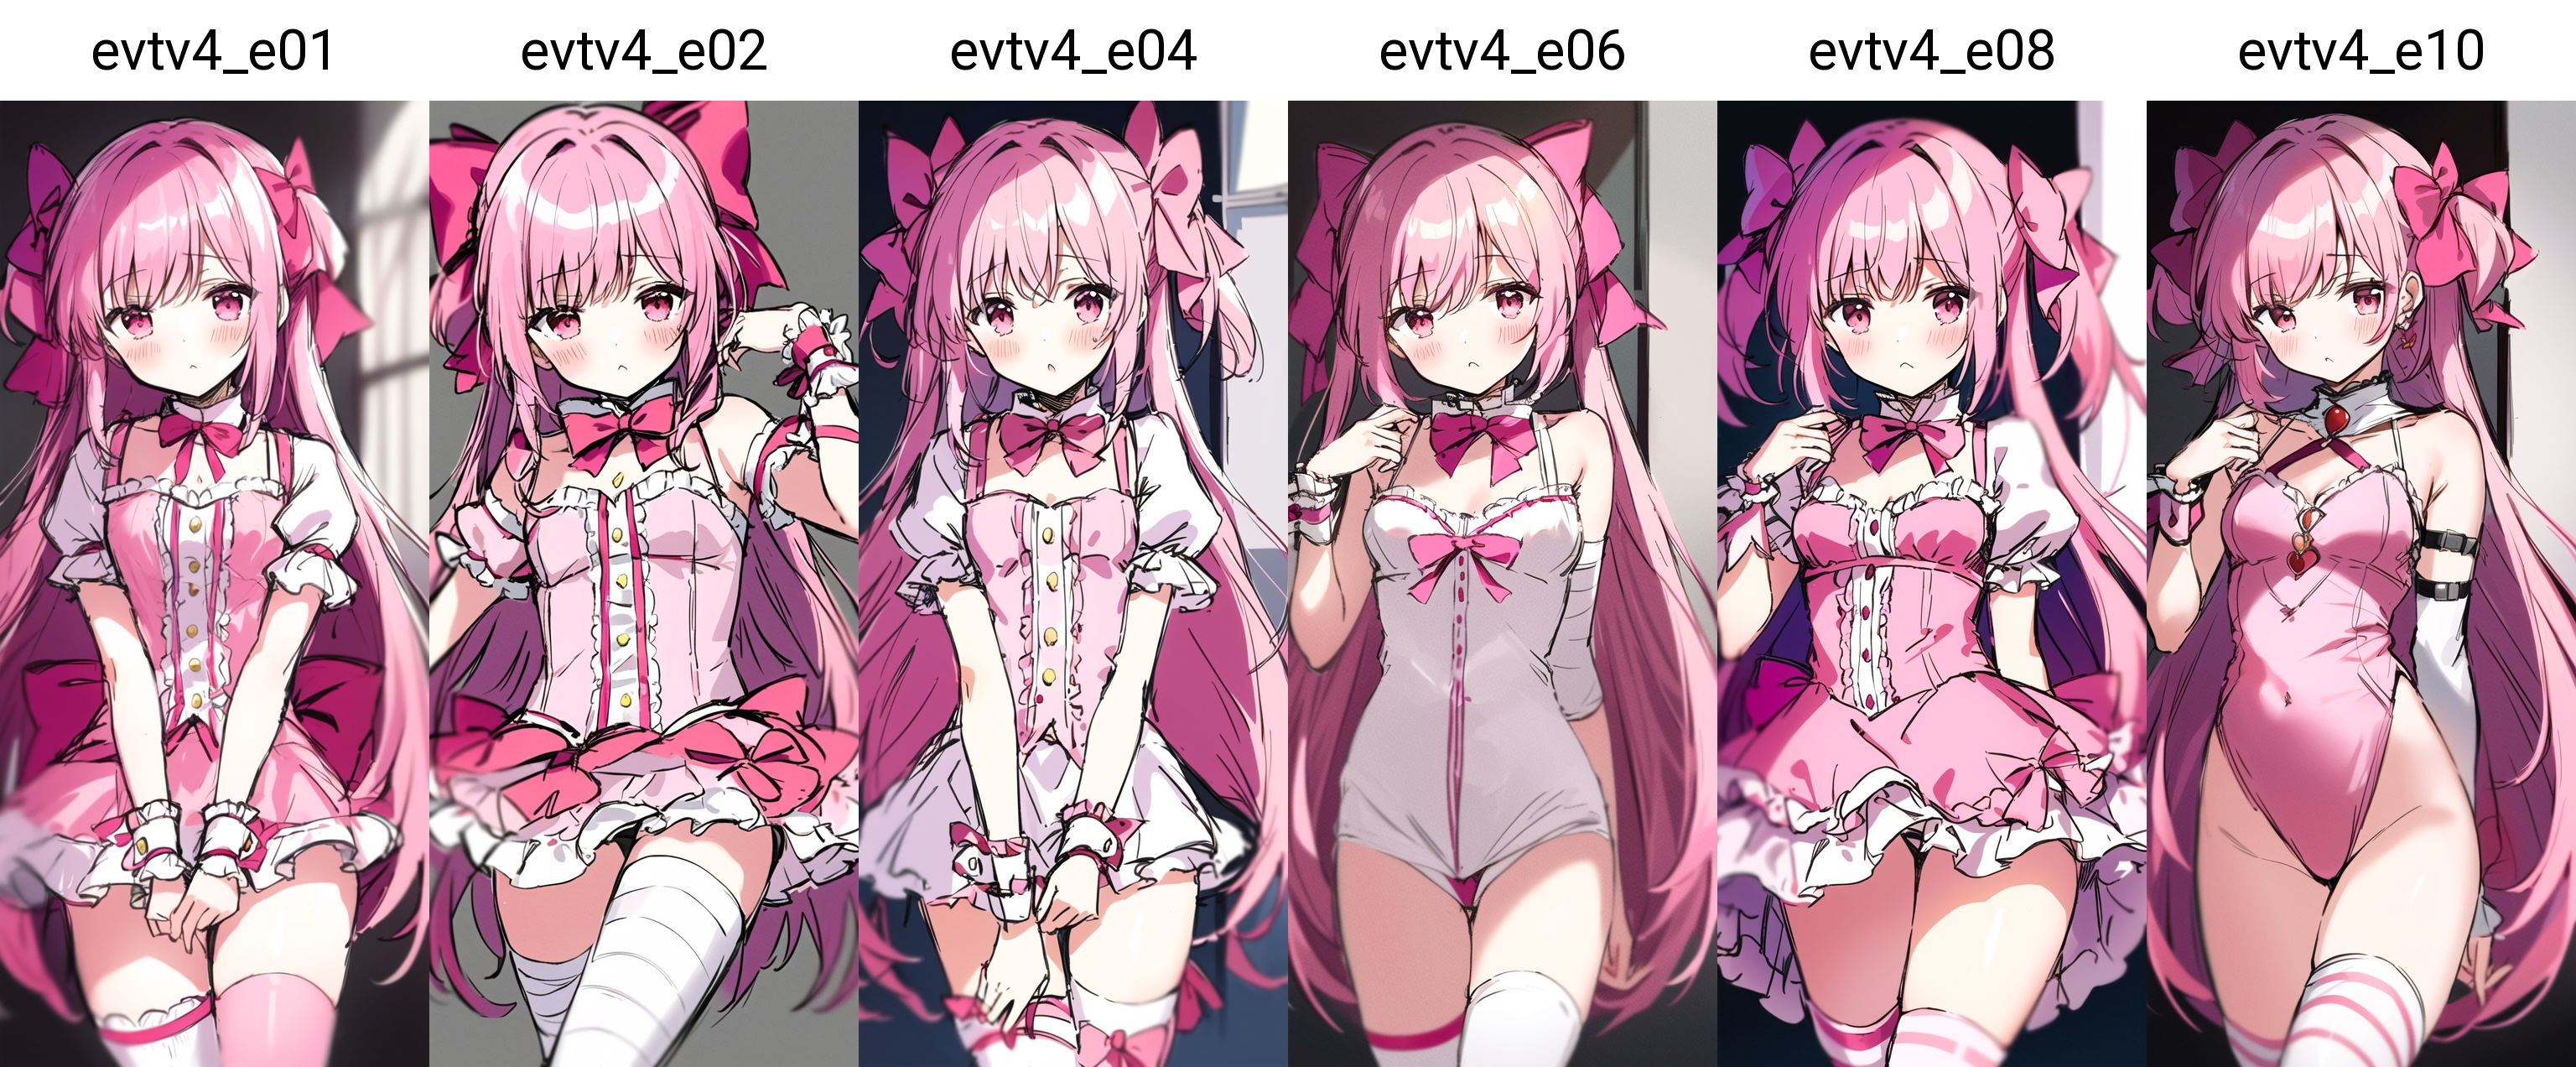
{Masterpiece, Kaname_Madoka, tall and long double tails, well rooted hair, (pink hair), pink eyes, crossed bangs, ojousama, jk, thigh bandages, wrist cuffs, (pink bow: 1.2)}, plain color, sketch, masterpiece, high detail, masterpiece portrait, best quality, ray tracing, {:<, look at the edge}
Negative prompt: ((((ugly)))), (((duplicate))), ((morbid)), ((mutilated)),extra fingers, mutated hands, ((poorly drawn hands)), ((poorly drawn face)), (((bad proportions))), ((extra limbs)), (((deformed))), (((disfigured))), cloned face, gross proportions, (malformed limbs), ((missing arms)), ((missing legs)), (((extra arms))), (((extra legs))), too many fingers, (((long neck))), (((low quality))), normal quality, blurry, bad feet, text font ui, ((((worst quality)))), anatomical nonsense, (((bad shadow))), unnatural body, liquid body, 3D, 3D game, 3D game scene, 3D character, bad hairs, poorly drawn hairs, fused hairs, big muscles, bad face, extra eyes, furry, pony, mosaic, disappearing calf, disappearing legs, extra digit, fewer digit, fused digit, missing digit, fused feet, poorly drawn eyes, big face, long face, bad eyes, thick lips, obesity, strong girl, beard,Excess legs
Steps: 20, Sampler: DPM++ SDE Karras, CFG scale: 7, Seed: 2468255263, Size: 512x1152, Denoising strength: 0.7, Clip skip: 2
Training
base model:ACertainty
Trained for 10 epochs using around 550k anime-style images(pixiv and yandere).
Resolution: 512
UCG:0.1
Use arb:True
Trainer:Mikubill/naifu-diffusion
arb:
  enabled: true
  debug: false
  base_res: [512, 512]
  max_size: [768, 512]
  divisible: 64
  max_ar_error: 4
  min_dim: 256
  dim_limit: 1024
scheduler:
  name: diffusers.DDIMScheduler
  params:
      beta_end: 0.012
      beta_schedule: "scaled_linear"
      beta_start: 0.00085
      clip_sample: false
      num_train_timesteps: 1000
      set_alpha_to_one: false
      steps_offset: 1
      trained_betas: null

optimizer:
  name: bitsandbytes.optim.AdamW8bit
  params:
    lr: 2e-6
    weight_decay: 5e-2
    eps: 1e-7

lr_scheduler:
  name: torch.optim.lr_scheduler.CosineAnnealingWarmRestarts
  warmup:
    enabled: true
    init_lr: 2e-8
    num_warmup: 50
    strategy: "cos"
  params:
    T_0: 5
    T_mult: 1
    eta_min: 6e-7
    last_epoch: -1
Spent about 300 V100 GPU hours.
License
This model is open access and available to all, with a CreativeML OpenRAIL-M license further specifying rights and usage. The CreativeML OpenRAIL License specifies:
- You can't use the model to deliberately produce nor share illegal or harmful outputs or content
- The authors claims no rights on the outputs you generate, you are free to use them and are accountable for their use which must not go against the provisions set in the license
- You may re-distribute the weights and use the model commercially and/or as a service. If you do, please be aware you have to include the same use restrictions as the ones in the license and share a copy of the CreativeML OpenRAIL-M to all your users (please read the license entirely and carefully) Please read the full license here