/ Модель

Характеристики

Лицензия
Llama 3
Базовая модель
CLIP-ViT-B-16-laion2B-s34B-b88K
Библиотека
terratorch
Опубликована
25 июн 2025

Llama3-MS-CLIP-base

Классификация изображений без дообученияИзображение, текст → label3 профессии

Мультиспектральная модель CLIP для классификации спутниковых снимков Sentinel-2 по текстовым меткам и поиска изображений по запросу.

2 732скачиваний за 30 дней8лайковвеса обновлены6 авг 2025

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Llama3-MS-CLIP ViT-B/16 — разработанная IBM и ESA Geospatial модель семейства CLIP для сопоставления текста с мультиспектральными спутниковыми изображениями. Она обучена на миллионе пар изображение–текст из SSL4EO-S12-v1.1 с автоматически созданными описаниями. Архитектура включает отдельные кодировщики изображений и текста; входные RGB-слои расширены для мультиспектральных данных, а дополнительные каналы изначально обнулены.

Модель предназначена для классификации спутниковых снимков по текстовым меткам без специального обучения на этих метках, а также для поиска изображений по текстовому запросу. В README указана работа со снимками Sentinel-2 L2A со всеми 12 каналами; при оценке модель превзошла RGB-модели на большинстве приведённых бенчмарков. Репозиторий содержит веса в формате PyTorch и использует библиотеку TerraTorch. Лицензия — Llama 3.

Модель специализирована на мультиспектральных данных наблюдения Земли; заявленные сценарии связаны со снимками Sentinel-2 L2A. Описание не сообщает ограничений по качеству или применению, помимо этой специализации.

Сценарии применения

  • классификация снимков Sentinel-2 по текстовым описаниям классов
  • поиск спутниковых изображений по текстовому запросу
  • сопоставление мультиспектральных снимков с текстовыми описаниями

Ограничения

Модель специализирована на мультиспектральных изображениях Sentinel-2 L2A с 12 каналами; применимость к другим источникам и форматам данных не подтверждена в карточке.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

arXiv Code Images Dataset

Llama3-MS-CLIP ViT-B/16

Llama3-MS-CLIP is the first Vision-Language Model in the CLIP family that understands multispectral imagery. It is trained on one million image-text pairs from the SSL4EO-S12-v1.1 dataset with generated captions.

Architecture

The CLIP model consists of two encoders for text and images. We extended the RGB patch embeddings to multispectral input and initialized the weights of the additional input channels with zeros. During the continual pre-training, the images and texts of each batch are encoded and combined. The loss increases the similarity of matching pairs while decreasing other combinations.
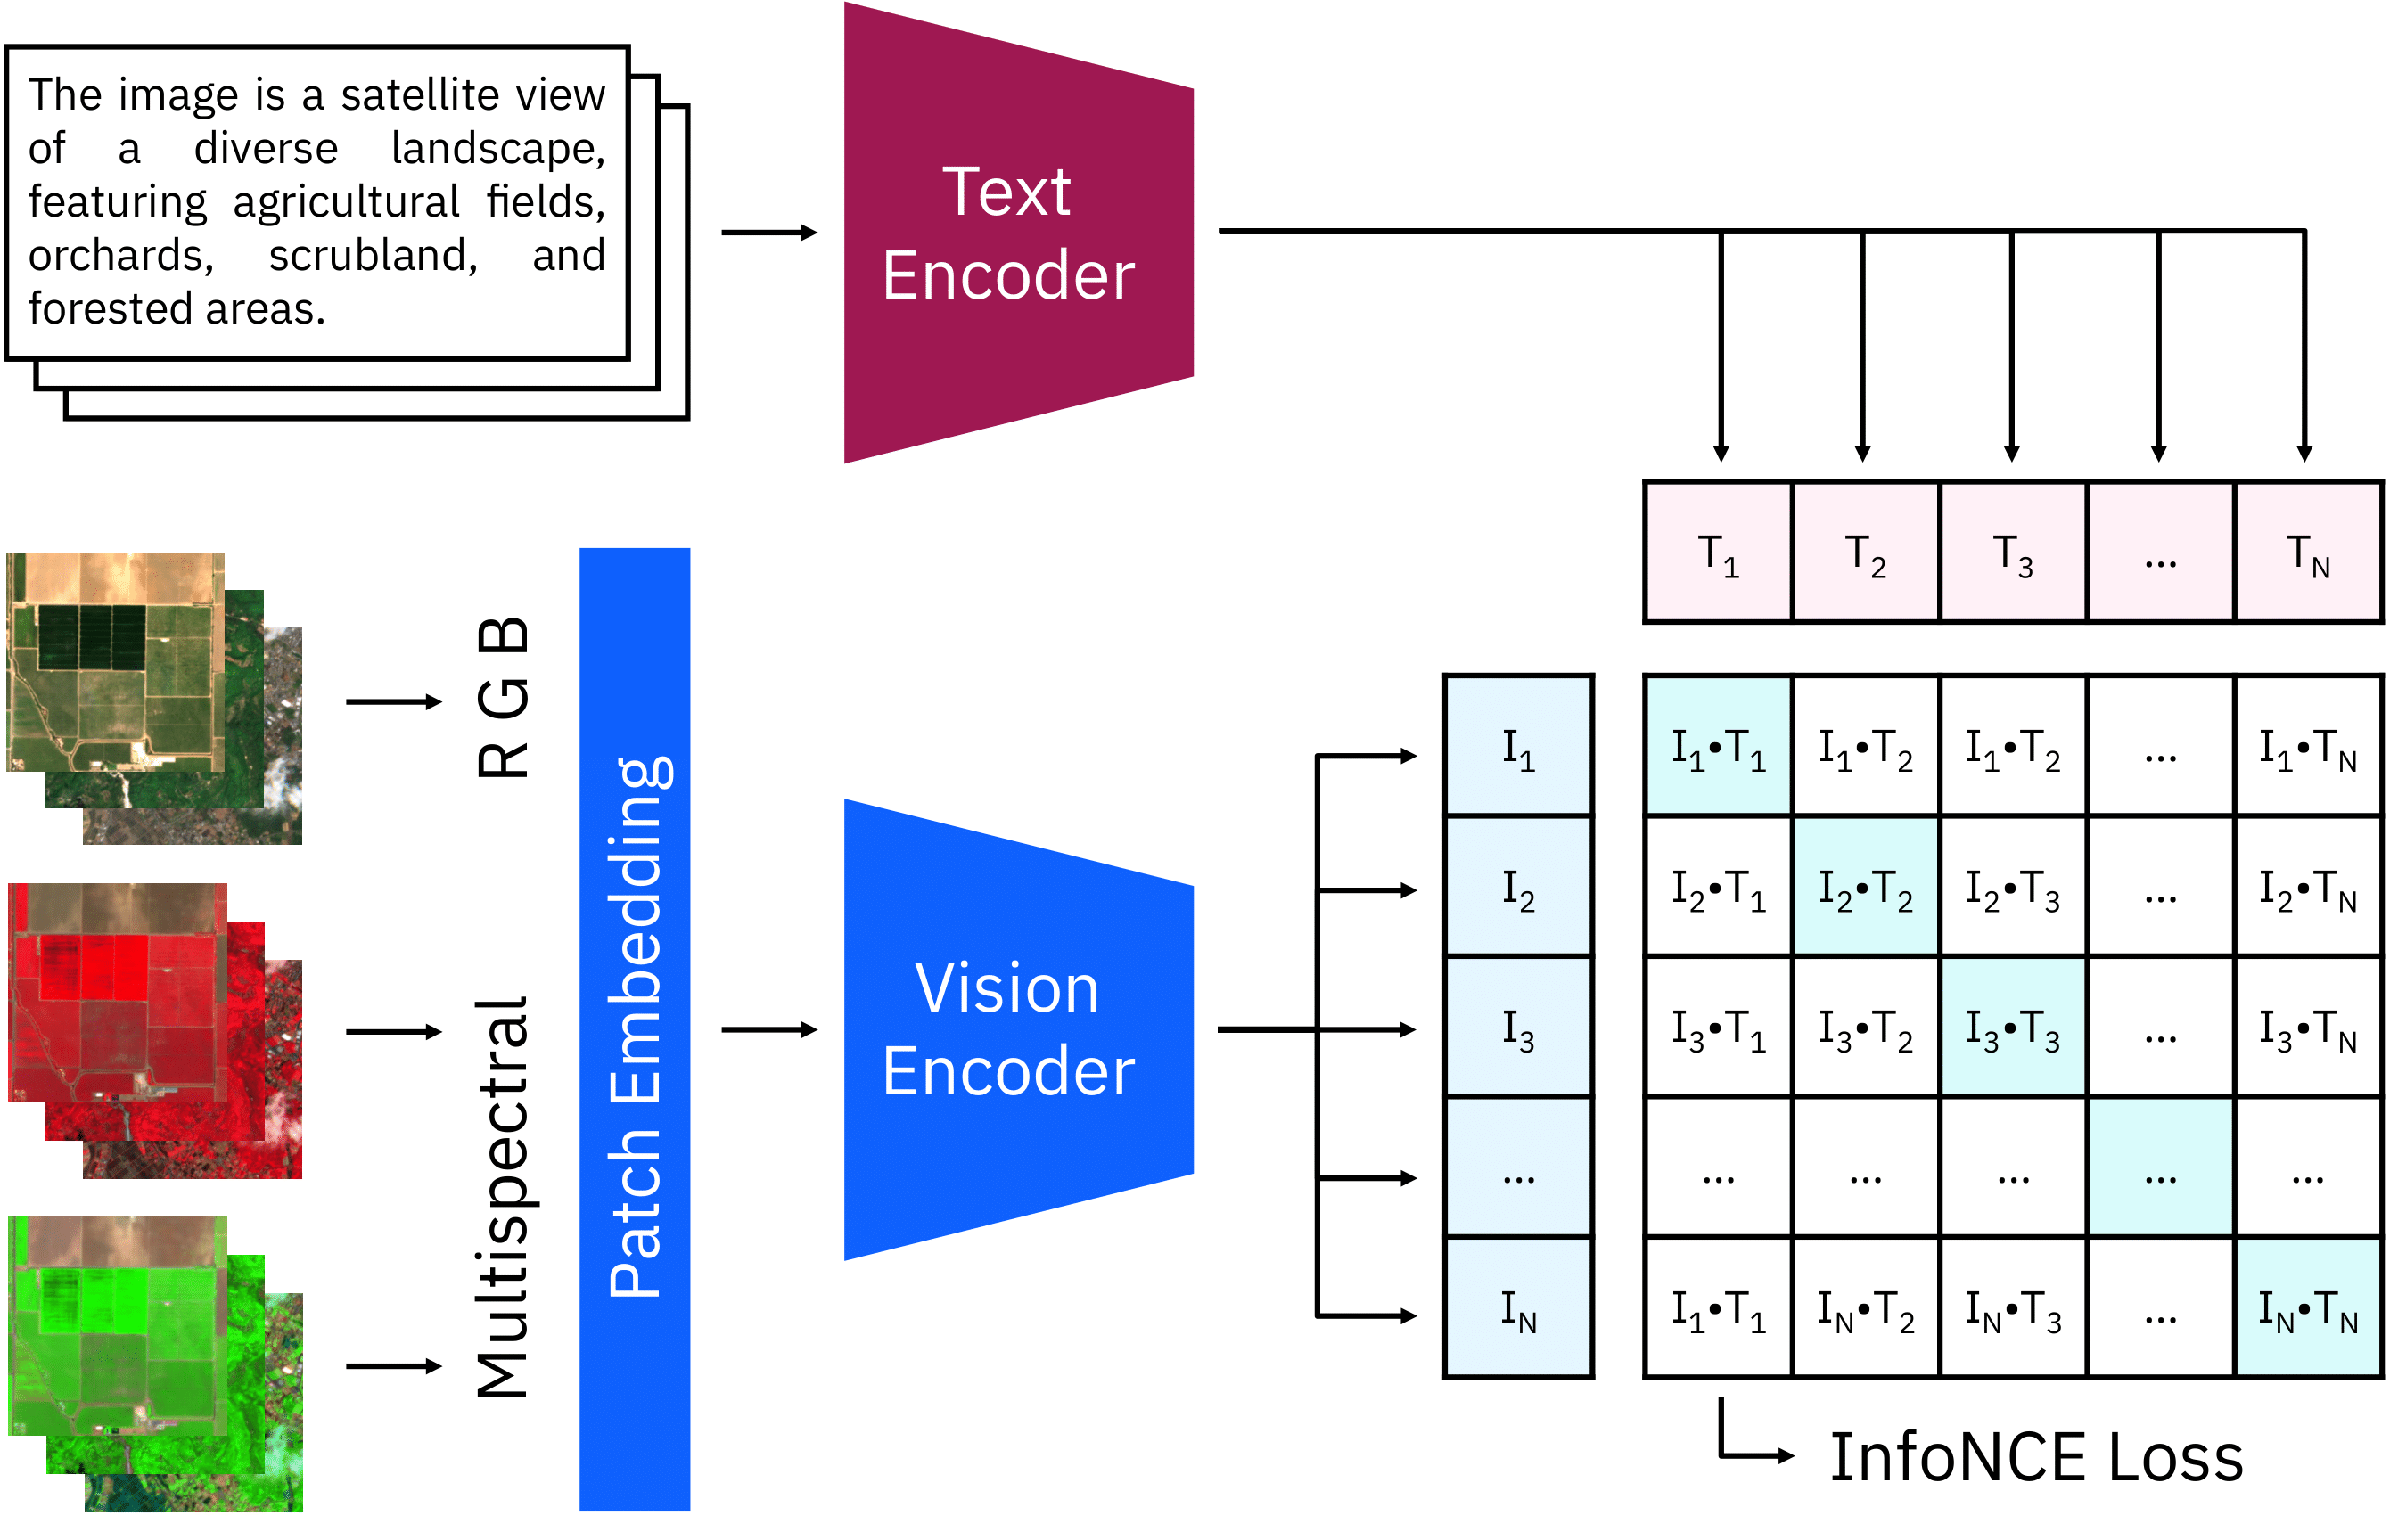
Architecture

Evaluation

We evaluated Llama3-MS-CLIP with zero-shot classification and text-to-image retrieval results, measured in accuracy (%) ↑ and mAP@100 (%) ↑, respectively. The following Figure compares our model with the OpenCLIP baselines and other EO-VLMs. We applied a smoothed min-max scaling and annotated the lowest and highest scores. Our multispectral CLIP model is outperforming other RGB-based models on most benchmarks.
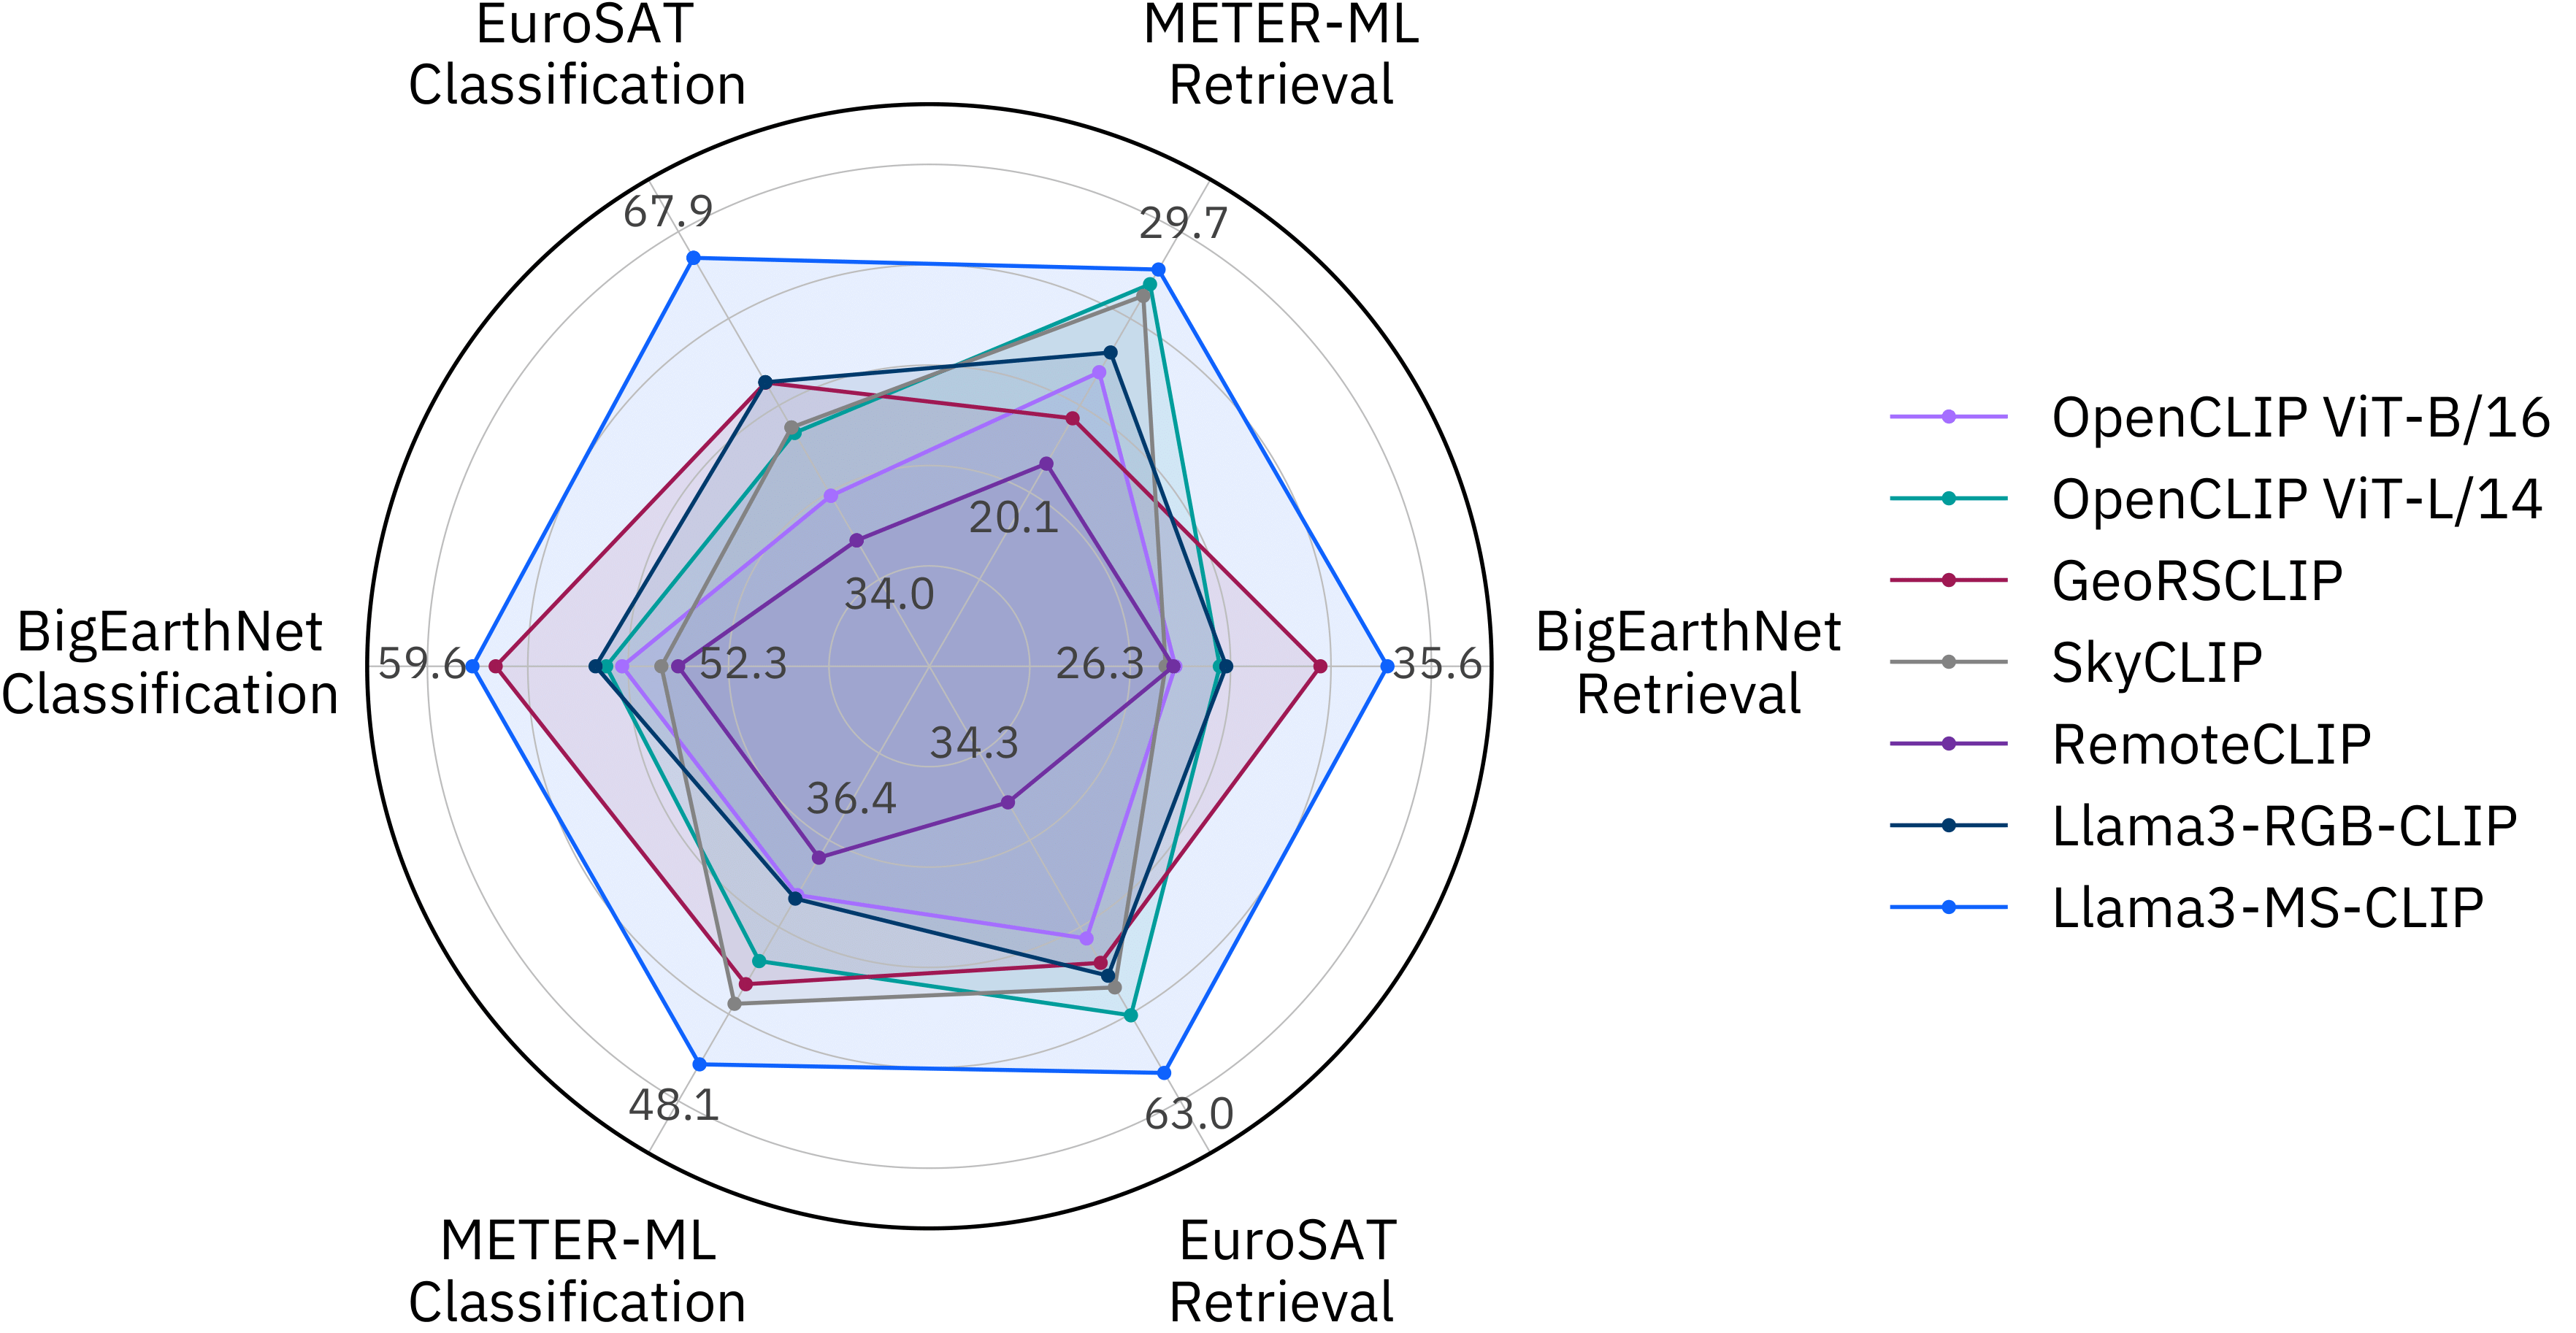
Benchmarking

Usage

You can use the model out of the box for zero-shot classification and text-to-image retrieval with Sentinel-2 L2A images.

Setup

Clone the repository and set up a new env:

git clone https://github.com/IBM/MS-CLIP
cd MS-CLIP
python -m venv venv
source venv/bin/activate
pip install -e .

Infernece

We provide an easy-to-use inference script that automatically downloads the weights from Hugging Face. You just need to provide a path to folder with Sentinel-2 L2A files (all 12 bands) and class_names or a query.

Run zero-shot classification with:

python inference.py --run-classification \
    --model-name "Llama3-MS-CLIP-Base" \
    --images "path/to/sentinel2_l2a_files/" \
    --class-names "class 1" "class 2" "class 3"

Run text-to-image retrieval with:

python inference.py --run_retrieval\
    --model-name "Llama3-MS-CLIP-Base" \
    --images "path/to/sentinel2_l2a_files/" \
    --query "Your query text" \
    --top-k 5  # Number of retrieved images

More information is provided in the GitHub repository MS-CLIP.

Citation

Please cite the following paper, if you use Llama3-MS-CLIP in your research:

@article{marimo2025beyond,
  title={Beyond the Visible: Multispectral Vision-Language Learning for Earth Observation},
  author={Marimo, Clive Tinashe and Blumenstiel, Benedikt and Nitsche, Maximilian and Jakubik, Johannes and Brunschwiler, Thomas},
  journal={arXiv preprint arXiv:2503.15969},
  year={2025}
}

License

Built with Meta Llama 3.

While the model itself is not based on Llama 3 but OpenCLIP B/16, it is trained on captions generated by a Llama 3-derivative model (License: https://github.com/meta-llama/llama3/blob/main/LICENSE).

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · terratorch · zero-shot-image-classification

Нельзя запустить

В репозитории нет config.json: не понять архитектуру модели.

Ревизия весов
251adb8

0 моделей