/ Модель

Характеристики

Лицензия
MIT
Архитектура
vision-encoder-decoder · dense
Опубликована
4 ноя 2022

OCR-DocVQA-Donut

Вопросы по документамИзображение, файл, текст → текст9 профессий

Donut, дообученная на DocVQA, отвечает на вопросы по изображениям документов, генерируя текст без отдельного OCR-этапа.

18скачиваний за 30 дней12лайковвеса обновлены4 ноя 2022

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Распознавание текста» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

jinhybr/OCR-DocVQA-Donut — модель Donut базового размера, дообученная на наборе DocVQA для ответов на вопросы по изображениям документов. Она принимает изображение документа и генерирует текстовый ответ, используя архитектуру vision encoder-decoder: визуальный энкодер Swin Transformer кодирует изображение, а декодер BART авторегрессионно формирует ответ. Модель предназначена для визуального анализа документов и сценариев вопросно-ответного поиска по их содержимому без отдельного этапа OCR. Выпущена под лицензией MIT.

Модель специализирована на DocVQA; её точность на других типах документов и задачах не подтверждена в карточке. Указанная конфигурация — базовый размер; число параметров и длина контекста в предоставленных данных не приведены.

Сценарии применения

  • ответы на вопросы по сканам документов
  • извлечение нужных сведений из изображения формы
  • поиск значений в документе по вопросу на естественном языке

Ограничения

Модель дообучена на DocVQA, поэтому её качество на иных типах документов и задачах не подтверждено. Она генерирует ответы по изображению и может ошибаться при интерпретации содержимого.

Для каких профессий подходит9

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Donut (base-sized model, fine-tuned on DocVQA)

Donut model fine-tuned on DocVQA. It was introduced in the paper OCR-free Document Understanding Transformer by Geewok et al. and first released in this repository.

Disclaimer: The team releasing Donut did not write a model card for this model so this model card has been written by the Hugging Face team.

Model description

Donut consists of a vision encoder (Swin Transformer) and a text decoder (BART). Given an image, the encoder first encodes the image into a tensor of embeddings (of shape batch_size, seq_len, hidden_size), after which the decoder autoregressively generates text, conditioned on the encoding of the encoder.
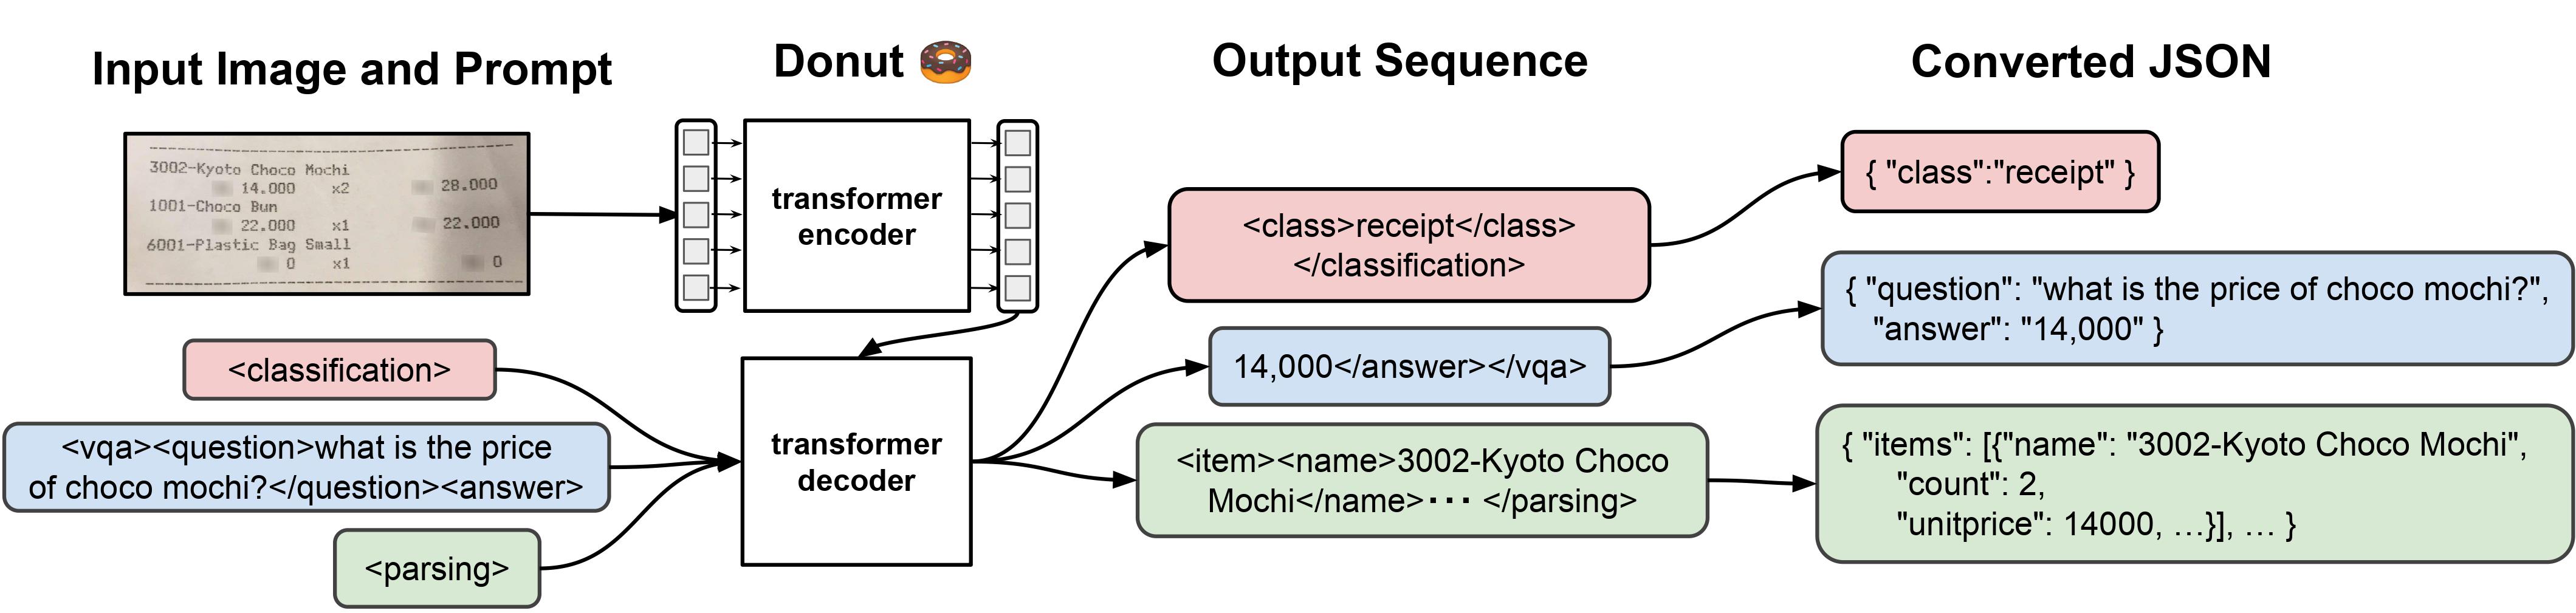
model image

Intended uses & limitations

This model is fine-tuned on DocVQA, a document visual question answering dataset.

We refer to the documentation which includes code examples.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
VisionEncoderDecoderModel
Ревизия весов
8436d13

0 моделей