/ Модель

Характеристики

Контекст
512 токенов
Параметры
137 млн
Архитектура
bert · dense

scibert_scivocab_uncased-finetuned-ner

Разметка токеновТекст → label3 профессии

Модель на базе SciBERT извлекает из английских медицинских текстов названия препаратов и нежелательные эффекты.

21 141скачиваний за 30 дней16лайковвеса обновлены22 ноя 2021

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Модель на архитектуре BERT, дообученная на базе SciBERT для распознавания именованных сущностей в медицинских текстах. Она помечает токены, относящиеся к названиям лекарств и нежелательным эффектам, пятью метками: начало и продолжение сущности препарата, начало и продолжение описания эффекта, а также токены вне этих сущностей. Модель предназначена для извлечения упоминаний препаратов и побочных эффектов из текста, например при анализе сообщений о нежелательных реакциях.

Она содержит 137,1 млн параметров, принимает текст с контекстом до 512 токенов и выдаёт метки токенов. Указанная библиотека — Transformers; формат весов — PyTorch. Языковая метка карточки — английский. Условия лицензии в предоставленных данных не указаны.

Сценарии применения

  • извлечение названий лекарств из медицинских сообщений
  • выделение побочных эффектов препаратов в текстах
  • разметка упоминаний лекарств и нежелательных реакций по токенам

Ограничения

Модель распознаёт только названия препаратов и нежелательные эффекты в пределах заданного набора меток; заявленный контекст ограничен 512 токенами.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

This is a SciBERT-based model fine-tuned to perform Named Entity Recognition for drug names and adverse drug effects. model image
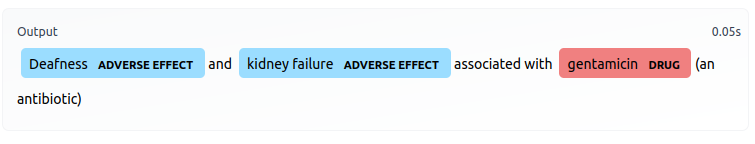
This model classifies input tokens into one of five classes:

  • B-DRUG: beginning of a drug entity
  • I-DRUG: within a drug entity
  • B-EFFECT: beginning of an AE entity
  • I-EFFECT: within an AE entity
  • O: outside either of the above entities

To get started using this model for inference, simply set up an NER pipeline like below:

from transformers import (AutoModelForTokenClassification, 
                          AutoTokenizer, 
                          pipeline,
                          )

model_checkpoint = "jsylee/scibert_scivocab_uncased-finetuned-ner"
model = AutoModelForTokenClassification.from_pretrained(model_checkpoint, num_labels=5,
                                                        id2label={0: 'O', 1: 'B-DRUG', 2: 'I-DRUG', 3: 'B-EFFECT', 4: 'I-EFFECT'} 
                                                        )                                                        
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)

model_pipeline = pipeline(task="ner", model=model, tokenizer=tokenizer)

print( model_pipeline ("Abortion, miscarriage or uterine hemorrhage associated with misoprostol (Cytotec), a labor-inducing drug."))

SciBERT: https://huggingface.co/allenai/scibert_scivocab_uncased

Dataset: https://huggingface.co/datasets/ade_corpus_v2

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · token-classification

Можно запустить

Подбираем GPU…

Класс архитектуры
BertForTokenClassification
Ревизия весов
609e6d9

0 моделей