/ Модель

Характеристики

Лицензия
MIT
Опубликована
14 янв 2023

mann-e_rev-3

Генерация изображенийТекст → изображение3 профессии

Mann-E rev-3 «Prompt Muse» — модель Muhammadreza Haghiri для генерации изображений по текстовым запросам.

105скачиваний за 30 дней10лайковвеса обновлены16 мая 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Изображения» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели сгенерируют результат по каждой задаче. Опубликованный тест появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Mann-E rev-3 «Prompt Muse» — модель преобразования текста в изображения, разработанная Muhammadreza Haghiri для проектов движения Cognitive Web. Это третья редакция Mann-E и первая версия с кодовым названием Prompt Muse. Модель распространяется в форматах Diffusers и PyTorch и использует StableDiffusionPipeline.

Модель предназначена для генерации изображений по текстовым запросам. В README описан запуск через Diffusers с Euler Scheduler; приведённый пример рассчитан на устройства с поддержкой CUDA, а для других сред настройки могут потребовать изменений. Автор предупреждает о срабатывании NSFW-фильтра даже на простых запросах и упоминает возможность его отключения. Лицензия модели — MIT.

Сценарии применения

  • создание иллюстраций по текстовому описанию
  • визуализация идей и концепций
  • генерация художественных изображений
  • подготовка изображений для творческих проектов

Ограничения

Пример запуска в README рассчитан на CUDA; для других сред могут потребоваться настройки. Автор предупреждает о срабатывании NSFW-фильтра на простых запросах.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

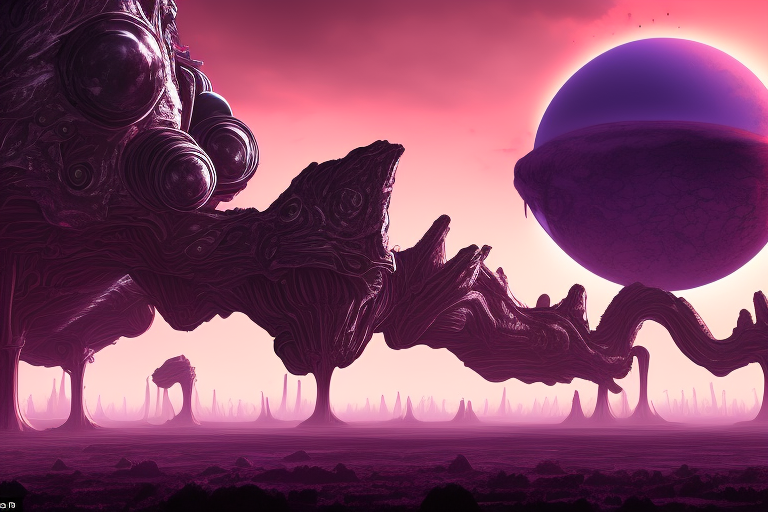
Sample

Mann-E 3 revision 3 "Prompt Muse"

Mann-E is a text to image model which has been developed by Muhammadreza Haghiri in order to be part of the Cognitive Web movement and projects. This is revision 3 of the model and it's the first one to have a code name. The code name is Prompt Muse.

What does Mann-E mean?

It's a play with the name Mani, who was a Persian religious leader at the early Sassanian era and also a painter and he's famous for both his religious and artistic works. His artistic side was more considered for naming the model of course.

How to use the model

Colab

You easily can click on this link and use model's inference notebook.

Code

The following code is written for CUDA supported devices. If you use UI's or inference tools on other devices, you may need to tweak them in order to get them to the work. Otherwise, it will be fine.

First, you need to install required libraries:

pip3 install diffusers transformers scipy ftfy accelerate

NOTE: installation of accelerate library makes the inference process amazingly faster. but it's totally optional.

Then, you need to import required libraries:

from diffusers import StableDiffusionPipeline, EulerDiscreteScheduler, DiffusionPipeline, DPMSolverMultistepScheduler
import torch

and then, create a pipeline (this pipeline is made with Euler Scheduler):

model_id = "mann-e/mann-e_rev-3"

scheduler = EulerDiscreteScheduler.from_pretrained(model_id, subfolder="scheduler")

pipe = StableDiffusionPipeline.from_pretrained(model_id, scheduler=scheduler, torch_dtype=torch.float16)
pipe = pipe.to("cuda")

and of course, since you may get NSFW filteration warnings even on simplest prompts, you may consider disabling it:

def dummy(images, **kwargs): 
    return images, False 

pipe.safety_checker = dummy

NOTE: Please consider consequences of disabling this filter as well. we do not want people to get any sort of damage or injury from the image generation results.

And after that, you easily can start inference:

prompt = "Concept art of a hostile alien planet with unbreathable purple air and toxic clouds, sinister atmosphere, deep shadows, sharp details" 
negative_prompt = "low quality, blurry" 
width = 768 
height = 512 

then:

image = pipe(prompt=prompt, negative_prompt=negative_prompt, num_inference_steps=100, width=width, height=height, guidance_scale=10).images[0]
image.save("My_image.png")

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Ревизия весов
cebb76b

0 моделей