FocalNet (base-sized large reception field model)
FocalNet model trained on ImageNet-1k at resolution 384x384. It was introduced in the paper Focal Modulation Networks by Yang et al. and first released in this repository.
Disclaimer: The team releasing FocalNet did not write a model card for this model so this model card has been written by the Hugging Face team.
Model description
Focul Modulation Networks are an alternative to Vision Transformers, where self-attention (SA) is completely replaced by a focal modulation mechanism for modeling token interactions in vision. Focal modulation comprises three components: (i) hierarchical contextualization, implemented using a stack of depth-wise convolutional layers, to encode visual contexts from short to long ranges, (ii) gated aggregation to selectively gather contexts for each query token based on its content, and (iii) element-wise modulation or affine transformation to inject the aggregated context into the query. Extensive experiments show FocalNets outperform the state-of-the-art SA counterparts (e.g., Vision Transformers, Swin and Focal Transformers) with similar computational costs on the tasks of image classification, object detection, and segmentation.
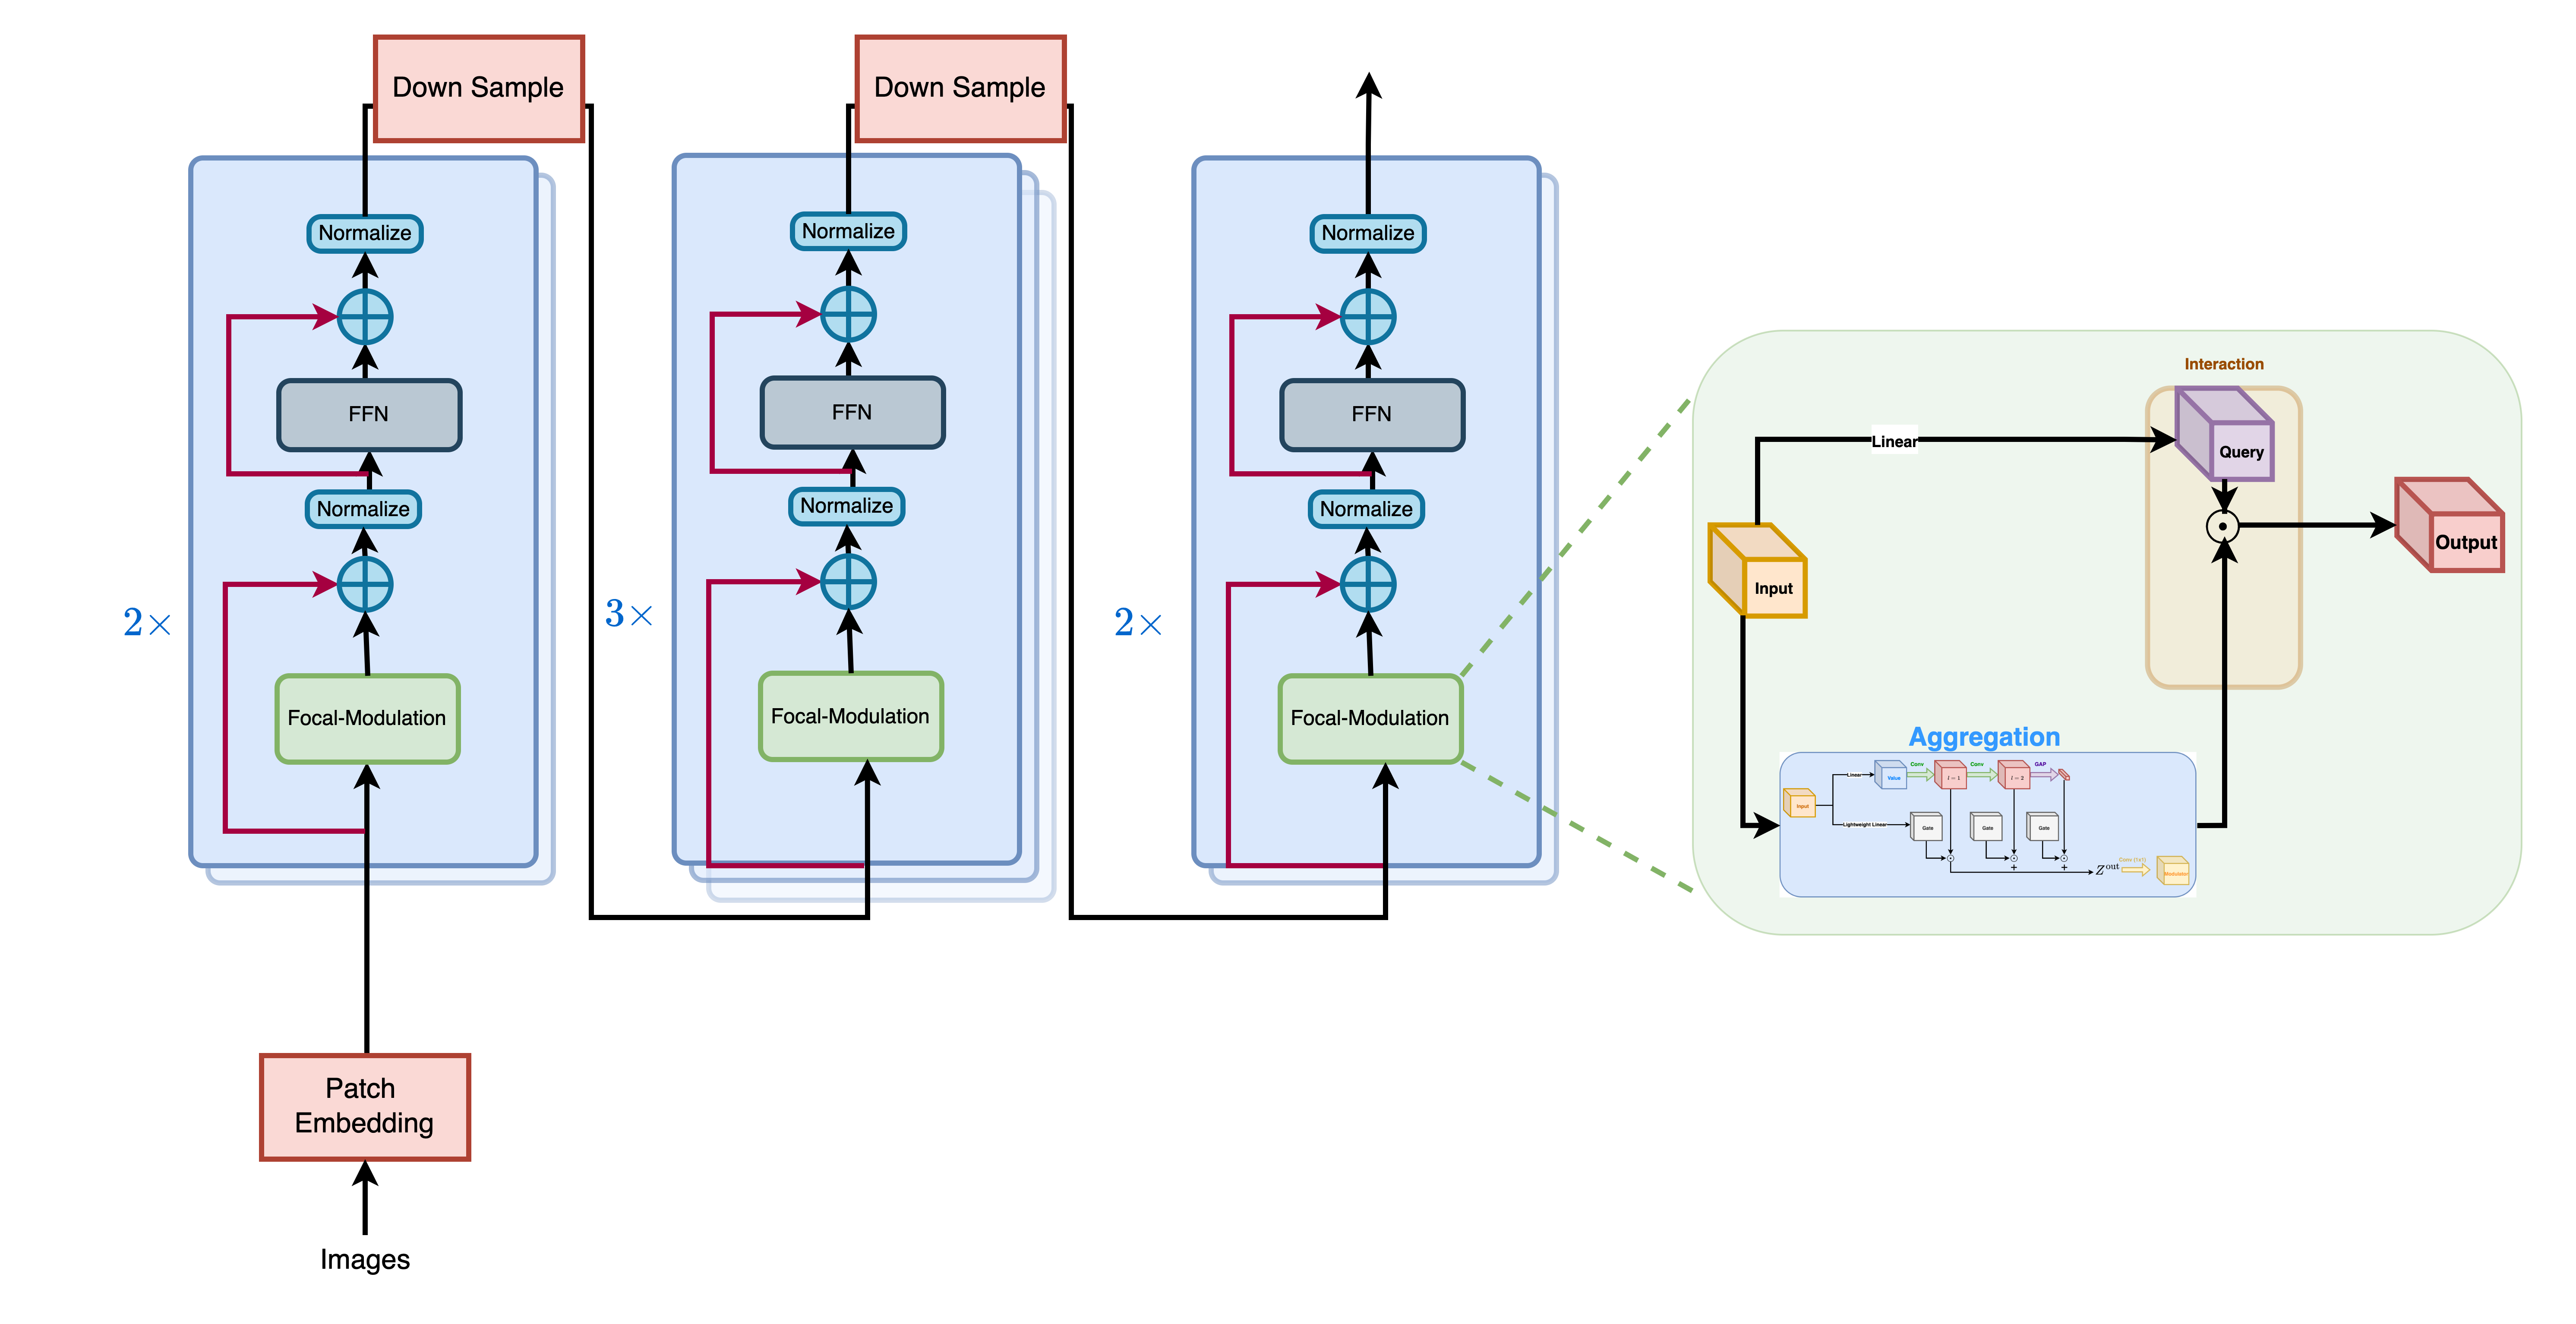
Intended uses & limitations
You can use the raw model for image classification. See the model hub to look for fine-tuned versions on a task that interests you.
How to use
Here is how to use this model to classify an image of the COCO 2017 dataset into one of the 1,000 ImageNet classes:
from transformers import FocalNetImageProcessor, FocalNetForImageClassification
import torch
from datasets import load_dataset

dataset = load_dataset("huggingface/cats-image")
image = dataset["test"]["image"][0]

preprocessor = FocalNetImageProcessor.from_pretrained("microsoft/focalnet-base-lrf")
model = FocalNetForImageClassification.from_pretrained("microsoft/focalnet-base-lrf")

inputs = preprocessor(image, return_tensors="pt")

with torch.no_grad():
    logits = model(**inputs).logits

# model predicts one of the 1000 ImageNet classes
predicted_label = logits.argmax(-1).item()
print(model.config.id2label[predicted_label]),
For more code examples, we refer to the documentation.
BibTeX entry and citation info
@article{DBLP:journals/corr/abs-2203-11926,
  author       = {Jianwei Yang and
                  Chunyuan Li and
                  Jianfeng Gao},
  title        = {Focal Modulation Networks},
  journal      = {CoRR},
  volume       = {abs/2203.11926},
  year         = {2022},
  url          = {https://doi.org/10.48550/arXiv.2203.11926},
  doi          = {10.48550/arXiv.2203.11926},
  eprinttype    = {arXiv},
  eprint       = {2203.11926},
  timestamp    = {Tue, 29 Mar 2022 18:07:24 +0200},
  biburl       = {https://dblp.org/rec/journals/corr/abs-2203-11926.bib},
  bibsource    = {dblp computer science bibliography, https://dblp.org}
}