/ Модель

Характеристики

Контекст
1 024 токена
Параметры
80,1 млн
Лицензия
MIT
Архитектура
git · dense
Опубликована
2 янв 2023

git-large-textcaps

Генерация текстаТекст → текст4 профессии

GIT-large-TextCaps — модель Microsoft для создания англоязычных описаний изображений с распознаванием видимого на них текста.

687скачиваний за 30 дней33лайкавеса обновлены8 фев 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

GIT-large-TextCaps — модель Microsoft семейства GenerativeImage2Text (GIT), дообученная на наборе TextCaps для создания описаний изображений, содержащих текст. Архитектура представляет собой трансформерный декодер, который получает визуальные токены изображения от CLIP и текстовые токены; размер модели — 80,1 млн параметров, контекст — до 1024 токенов. Репозиторий содержит веса PyTorch, лицензия — MIT.

Модель генерирует текст по изображению и подходит прежде всего для подписи изображений с чтением видимых надписей, а также для задач описания сцен. В карточке семейства GIT также упомянуты ответы на визуальные вопросы и классификация через генерацию текста, но этот чекпойнт специально дообучен на TextCaps. Модель ориентирована на английский язык. Ограничения включают зависимость качества от читаемости текста и содержания изображения; результаты оценки для данного чекпойнта в карточке не приведены.

Сценарии применения

  • создание подписей к изображениям с вывесками и надписями
  • описание фотографий с текстом на объектах
  • извлечение видимых надписей в форме связного описания
  • автоматическое составление текстовых описаний изображений для каталогов

Ограничения

Качество зависит от разрешения изображения и читаемости текста; возможны ошибки или пропуски при описании сцены и надписей. Количественные результаты оценки этого чекпойнта в карточке не приведены.

Для каких профессий подходит4

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

GIT (GenerativeImage2Text), large-sized, fine-tuned on TextCaps

GIT (short for GenerativeImage2Text) model, large-sized version, fine-tuned on TextCaps. It was introduced in the paper GIT: A Generative Image-to-text Transformer for Vision and Language by Wang et al. and first released in this repository.

Disclaimer: The team releasing GIT did not write a model card for this model so this model card has been written by the Hugging Face team.

Model description

GIT is a Transformer decoder conditioned on both CLIP image tokens and text tokens. The model is trained using "teacher forcing" on a lot of (image, text) pairs.

The goal for the model is simply to predict the next text token, giving the image tokens and previous text tokens.

The model has full access to (i.e. a bidirectional attention mask is used for) the image patch tokens, but only has access to the previous text tokens (i.e. a causal attention mask is used for the text tokens) when predicting the next text token.
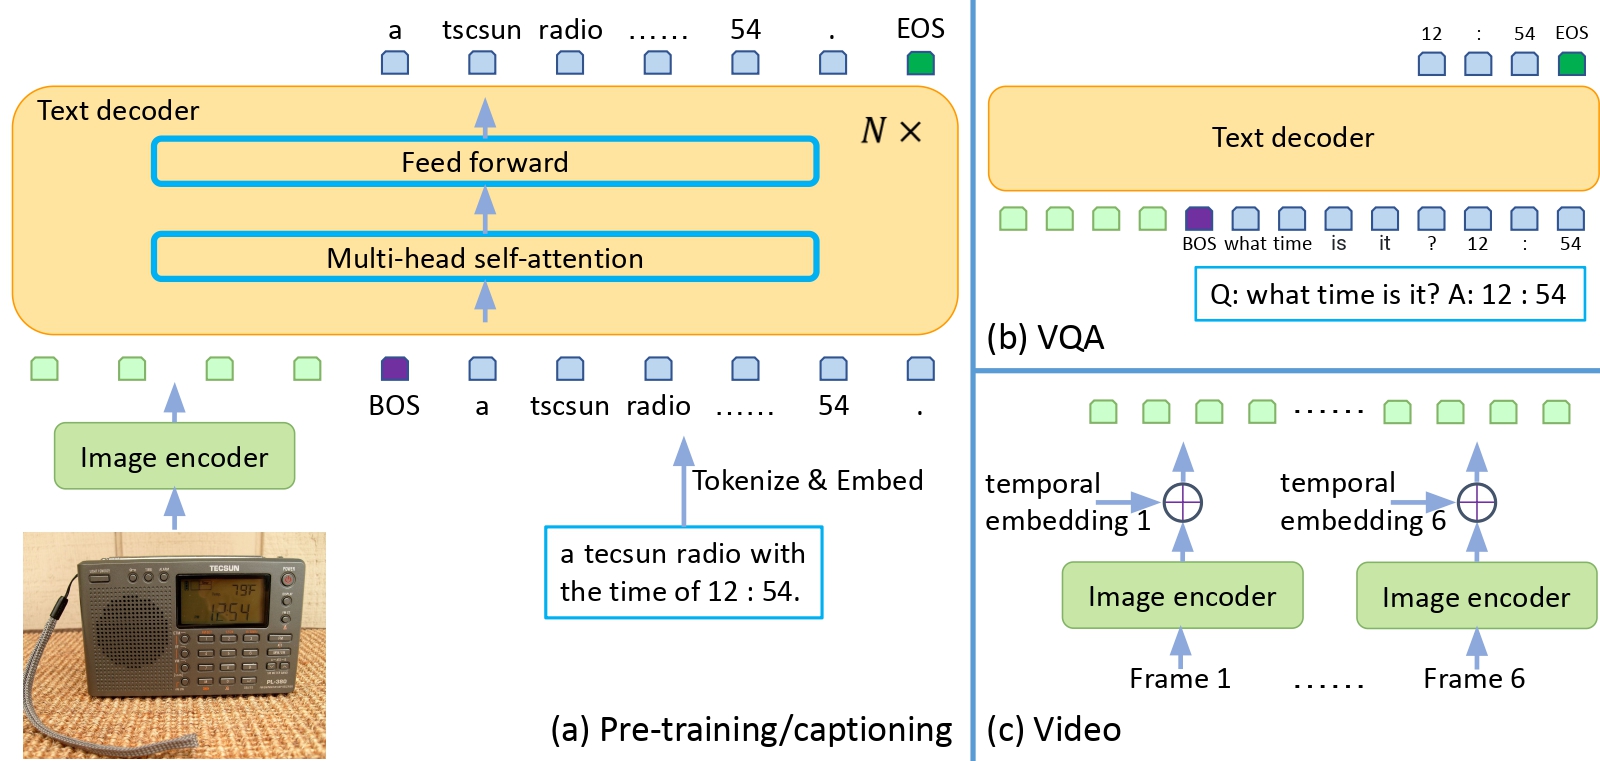
GIT architecture

This allows the model to be used for tasks like:

  • image and video captioning
  • visual question answering (VQA) on images and videos
  • even image classification (by simply conditioning the model on the image and asking it to generate a class for it in text).

Intended uses & limitations

You can use the raw model for image captioning. See the model hub to look for fine-tuned versions on a task that interests you.

How to use

For code examples, we refer to the documentation.

Training data

From the paper:

We collect 0.8B image-text pairs for pre-training, which include COCO (Lin et al., 2014), Conceptual Captions (CC3M) (Sharma et al., 2018), SBU (Ordonez et al., 2011), Visual Genome (VG) (Krishna et al., 2016), Conceptual Captions (CC12M) (Changpinyo et al., 2021), ALT200M (Hu et al., 2021a), and an extra 0.6B data following a similar collection procedure in Hu et al. (2021a).

=> however this is for the model referred to as "GIT" in the paper, which is not open-sourced.

This checkpoint is "GIT-large", which is a smaller variant of GIT trained on 20 million image-text pairs.

Next, the model was fine-tuned on TextCaps.

See table 11 in the paper for more details.

Preprocessing

We refer to the original repo regarding details for preprocessing during training.

During validation, one resizes the shorter edge of each image, after which center cropping is performed to a fixed-size resolution. Next, frames are normalized across the RGB channels with the ImageNet mean and standard deviation.

Evaluation results

For evaluation results, we refer readers to the paper.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
GitForCausalLM
Ревизия весов
3fd449a

0 моделей