/ Модель

Характеристики

Параметры
403 млн
Архитектура
unispeech · dense

unispeech-1350-en-17h-ky-ft-1h

Распознавание речиАудио → текст3 профессии

UniSpeech-Large-plus Kyrgyz распознаёт речь на аудио 16 кГц и предназначена для получения последовательностей кыргызских фонем.

86скачиваний за 30 дней3лайкавеса обновлены19 дек 2021

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Распознавание речи» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

UniSpeech-Large-plus Kyrgyz — модель распознавания речи Microsoft на архитектуре UniSpeech с плотной архитектурой и CTC-выходом; размер составляет 402,7 млн параметров. Модель предварительно обучена на речевых аудиозаписях с частотой 16 кГц и фонетической разметкой, затем дообучена на одном часе кыргызских фонем. Для распознавания аудио требуется частота дискретизации 16 кГц, а ожидаемый текст необходимо преобразовать в последовательность фонем.

Модель предназначена для распознавания кыргызской речи с выводом фонетической последовательности. UniSpeech сочетает обучение CTC на размеченных фонемах с контрастивным самообучением на размеченных и неразмеченных данных; в карточке упомянут Common Voice. Модель опубликована в формате PyTorch и использует лицензию Microsoft Research License. Она требует фонемного представления целевого текста и ограниченного объёма дообучения на кыргызском материале, поэтому область её применения уже, чем у универсальных систем транскрибирования.

Сценарии применения

  • распознавание кыргызской речи в аудио с частотой 16 кГц
  • получение фонетической транскрипции кыргызской речи
  • эксперименты по распознаванию речи на кыргызском языке
  • оценка фонемного распознавания на данных Common Voice

Ограничения

Модель дообучена только на одном часе кыргызских фонем и ожидает аудио с частотой 16 кГц. Для сопоставления требуется представлять текст как последовательность фонем, поэтому обычная текстовая транскрипция напрямую не подходит.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

UniSpeech-Large-plus Kyrgyz

Microsoft's UniSpeech

The large model pretrained on 16kHz sampled speech audio and phonetic labels and consequently fine-tuned on 1h of Kyrgyz phonemes. When using the model make sure that your speech input is also sampled at 16kHz and your text in converted into a sequence of phonemes.

Paper: UniSpeech: Unified Speech Representation Learning with Labeled and Unlabeled Data

Authors: Chengyi Wang, Yu Wu, Yao Qian, Kenichi Kumatani, Shujie Liu, Furu Wei, Michael Zeng, Xuedong Huang

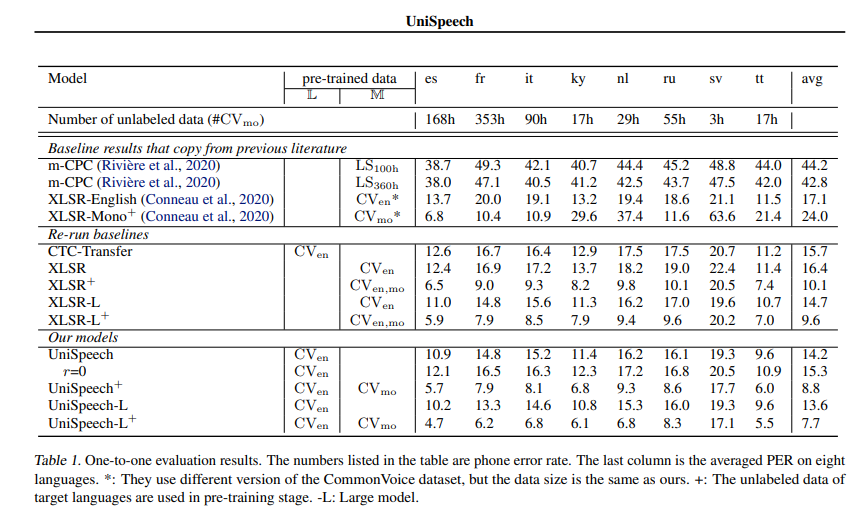
Abstract In this paper, we propose a unified pre-training approach called UniSpeech to learn speech representations with both unlabeled and labeled data, in which supervised phonetic CTC learning and phonetically-aware contrastive self-supervised learning are conducted in a multi-task learning manner. The resultant representations can capture information more correlated with phonetic structures and improve the generalization across languages and domains. We evaluate the effectiveness of UniSpeech for cross-lingual representation learning on public CommonVoice corpus. The results show that UniSpeech outperforms self-supervised pretraining and supervised transfer learning for speech recognition by a maximum of 13.4% and 17.8% relative phone error rate reductions respectively (averaged over all testing languages). The transferability of UniSpeech is also demonstrated on a domain-shift speech recognition task, i.e., a relative word error rate reduction of 6% against the previous approach.

The original model can be found under https://github.com/microsoft/UniSpeech/tree/main/UniSpeech.

Usage

This is an speech model that has been fine-tuned on phoneme classification.

Inference

import torch
from datasets import load_dataset
from transformers import AutoModelForCTC, AutoProcessor
import torchaudio.functional as F

model_id = "microsoft/unispeech-1350-en-17h-ky-ft-1h"

sample = next(iter(load_dataset("common_voice", "ky", split="test", streaming=True)))
resampled_audio = F.resample(torch.tensor(sample["audio"]["array"]), 48_000, 16_000).numpy()

model = AutoModelForCTC.from_pretrained(model_id)
processor = AutoProcessor.from_pretrained(model_id)

input_values = processor(resampled_audio, return_tensors="pt").input_values

with torch.no_grad():
    logits = model(input_values).logits

prediction_ids = torch.argmax(logits, dim=-1)
transcription = processor.batch_decode(prediction_ids)

Contribution

The model was contributed by cywang and patrickvonplaten.

License

The official license can be found here

Official Results

See UniSpeeech-L^{+} - ky:
design

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
UniSpeechForCTC
Ревизия весов
47f2558

0 моделей