/ Модель

Характеристики

Параметры
403 млн
Архитектура
unispeech · dense

unispeech-large-1500h-cv

Языковая модель3 профессии

Англоязычная модель UniSpeech-Large для получения речевых представлений, которую нужно дообучить для распознавания речи или классификации аудио.

17 626скачиваний за 30 дней4лайкавеса обновлены5 ноя 2021

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

UniSpeech-Large — модель предварительного обучения речи, опубликованная Microsoft и представленная авторами Chengyi Wang и соавторами. Она обучена на аудио с частотой дискретизации 16 кГц и фонетических метках; архитектура UniSpeechForPreTraining содержит около 402,7 млн параметров. Модель принимает речь и формирует речевые представления для последующей адаптации к прикладной задаче.

Чекпойнт предназначен для дообучения под распознавание речи или классификацию аудио. Сам по себе он не готов выполнять распознавание: у него нет токенизатора, а для ASR требуется создать токенизатор и дообучить модель на размеченных текстовых данных. Для распознавания входной звук должен быть дискретизирован с частотой 16 кГц, а текстовые метки представлены последовательностью фонем. Модель предварительно обучена на английском языке и, согласно карточке, рассчитана прежде всего на английскую речь.

В статье сообщается об улучшении переноса между языками и доменами относительно использованных авторами подходов, однако эти результаты относятся к оценкам в исследовании и не гарантируют качество на конкретном наборе данных. Репозиторий содержит веса PyTorch. Лицензия в предоставленных данных не указана.

Сценарии применения

  • дообучение для распознавания английской речи
  • адаптация речевой модели к классификации аудио
  • исследование переноса речевых представлений между языками
  • адаптация к распознаванию речи в новом акустическом домене

Ограничения

Модель не готова к распознаванию речи без токенизатора и дообучения на размеченных текстовых данных; для работы требуется аудио с частотой 16 кГц. Предварительное обучение выполнено на английском языке, поэтому качество на других языках может быть ограничено.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

UniSpeech-Large

Microsoft's UniSpeech

The large model pretrained on 16kHz sampled speech audio and phonetic labels. When using the model make sure that your speech input is also sampled at 16kHz and your text in converted into a sequence of phonemes.

Note: This model does not have a tokenizer as it was pretrained on audio alone. In order to use this model speech recognition, a tokenizer should be created and the model should be fine-tuned on labeled text data. Check out this blog for more in-detail explanation of how to fine-tune the model.

Paper: UniSpeech: Unified Speech Representation Learning with Labeled and Unlabeled Data

Authors: Chengyi Wang, Yu Wu, Yao Qian, Kenichi Kumatani, Shujie Liu, Furu Wei, Michael Zeng, Xuedong Huang

Abstract In this paper, we propose a unified pre-training approach called UniSpeech to learn speech representations with both unlabeled and labeled data, in which supervised phonetic CTC learning and phonetically-aware contrastive self-supervised learning are conducted in a multi-task learning manner. The resultant representations can capture information more correlated with phonetic structures and improve the generalization across languages and domains. We evaluate the effectiveness of UniSpeech for cross-lingual representation learning on public CommonVoice corpus. The results show that UniSpeech outperforms self-supervised pretraining and supervised transfer learning for speech recognition by a maximum of 13.4% and 17.8% relative phone error rate reductions respectively (averaged over all testing languages). The transferability of UniSpeech is also demonstrated on a domain-shift speech recognition task, i.e., a relative word error rate reduction of 6% against the previous approach.

The original model can be found under https://github.com/microsoft/UniSpeech/tree/main/UniSpeech.

Usage

This is an English pre-trained speech model that has to be fine-tuned on a downstream task like speech recognition or audio classification before it can be used in inference. The model was pre-trained in English and should therefore perform well only in English.

Note: The model was pre-trained on phonemes rather than characters. This means that one should make sure that the input text is converted to a sequence of phonemes before fine-tuning.

Speech Recognition

To fine-tune the model for speech recognition, see the official speech recognition example.

Speech Classification

To fine-tune the model for speech classification, see the official audio classification example.

Contribution

The model was contributed by cywang and patrickvonplaten.

License

The official license can be found here
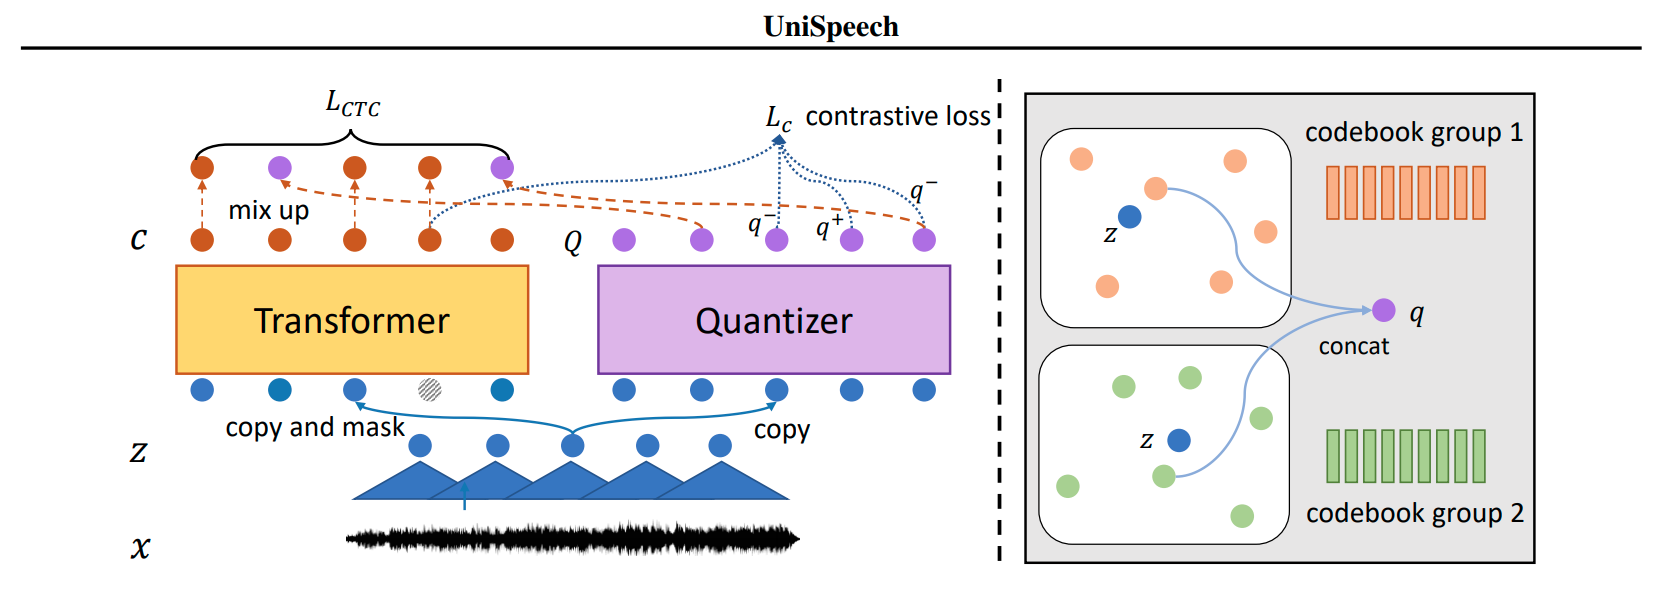
design

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Нельзя запустить

У модели не указана задача.

Класс архитектуры
UniSpeechForPreTraining
Ревизия весов
4e1a2ac

0 моделей