/ Модель

Характеристики

Параметры
113 млн
Лицензия
Apache 2.0
Архитектура
unispeech-sat · dense

unispeech-sat-base-100h-libri-ft

Распознавание речиАудио → текст7 профессий

Англоязычная CTC-модель Microsoft для транскрибирования речи, дообученная на 100 часах LibriSpeech.

11 523скачиваний за 30 дней6лайковвеса обновлены4 ноя 2021

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Распознавание речи» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки14

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

  • SIBFLEURS

    main_score

    Результат

    0,1518

    Общий результат 0,1881Общий результат 0,1877Общий результат 0,1783
    MTEB

    Публичная таблицаревизия совпадает

  • MInDS14

    main_score

    Результат

    0,076

    Общий результат 0,0963Общий результат 0,0864Общий результат 0,081
    MTEB

    Публичная таблицаревизия совпадает

  • VoxPopuliGenderID

    main_score

    Результат

    0,6

    MTEB

    Публичная таблицаревизия совпадает

  • ESC50AudioReranking

    main_score

    Результат

    0,5876

    MTEB

    Публичная таблицаревизия совпадает

  • CREMADPairClassification

    main_score

    Результат

    0,5435

    MTEB

    Публичная таблицаревизия совпадает

  • CommonLanguageAgeDetection

    main_score

    Результат

    0,1589

    MTEB

    Публичная таблицаревизия совпадает

  • MusicGenreClustering

    main_score

    Результат

    0,1417

    MTEB

    Публичная таблицаревизия совпадает

  • CREMA_D

    main_score

    Результат

    0,3343

    MTEB

    Публичная таблицаревизия совпадает

  • IEMOCAPGender

    main_score

    Результат

    0,6045

    MTEB

    Публичная таблицаревизия совпадает

  • UrbanSound8k

    main_score

    Результат

    0,4666

    MTEB

    Публичная таблицаревизия совпадает

  • SpeechCommands

    main_score

    Результат

    0,8186

    MTEB

    Публичная таблицаревизия совпадает

  • MridinghamStroke

    main_score

    Результат

    0,3979

    MTEB

    Публичная таблицаревизия совпадает

  • ESC50Clustering

    main_score

    Результат

    0,3838

    MTEB

    Публичная таблицаревизия совпадает

  • FSDD

    main_score

    Результат

    0,9187

    MTEB

    Публичная таблицаревизия совпадает

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

UniSpeech-SAT-Base-Finetuned-100h-Libri — акустическая модель распознавания речи от Microsoft, дообученная на 100 часах английской части LibriSpeech. Она основана на архитектуре UniSpeech-SAT и использует CTC для преобразования аудиоречи в текст; размер модели — 113,3 млн параметров. Модель принимает речь с частотой дискретизации 16 кГц и рассчитана на транскрибирование английской речи, в том числе аудиокниг и записей с похожими условиями.

Модель можно использовать как акустическую часть конвейера автоматического распознавания речи. Репозиторий содержит веса PyTorch. Лицензия — Apache-2.0. Карточка не приводит оценок качества распознавания или подробных ограничений для аудио, отличающегося от LibriSpeech, поэтому пригодность для таких записей следует проверять отдельно.

Сценарии применения

  • транскрибирование английских аудиокниг
  • распознавание английской речи в аудиозаписях
  • получение текстовой расшифровки речи с частотой 16 кГц

Ограничения

Для входной речи требуется частота дискретизации 16 кГц. Дообучение выполнено на 100 часах LibriSpeech, поэтому качество на других языках, акустических условиях и типах речи не установлено карточкой.

Для каких профессий подходит7

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

UniSpeech-SAT-Base-Finetuned-100h-Libri

Microsoft's UniSpeech

A unispeech-sat-base model that was fine-tuned on 100h hours of Librispeech on 16kHz sampled speech audio. When using the model make sure that your speech input is also sampled at 16Khz.

The model was fine-tuned on:

Paper: UNISPEECH-SAT: UNIVERSAL SPEECH REPRESENTATION LEARNING WITH SPEAKER AWARE PRE-TRAINING

Authors: Sanyuan Chen, Yu Wu, Chengyi Wang, Zhengyang Chen, Zhuo Chen, Shujie Liu, Jian Wu, Yao Qian, Furu Wei, Jinyu Li, Xiangzhan Yu

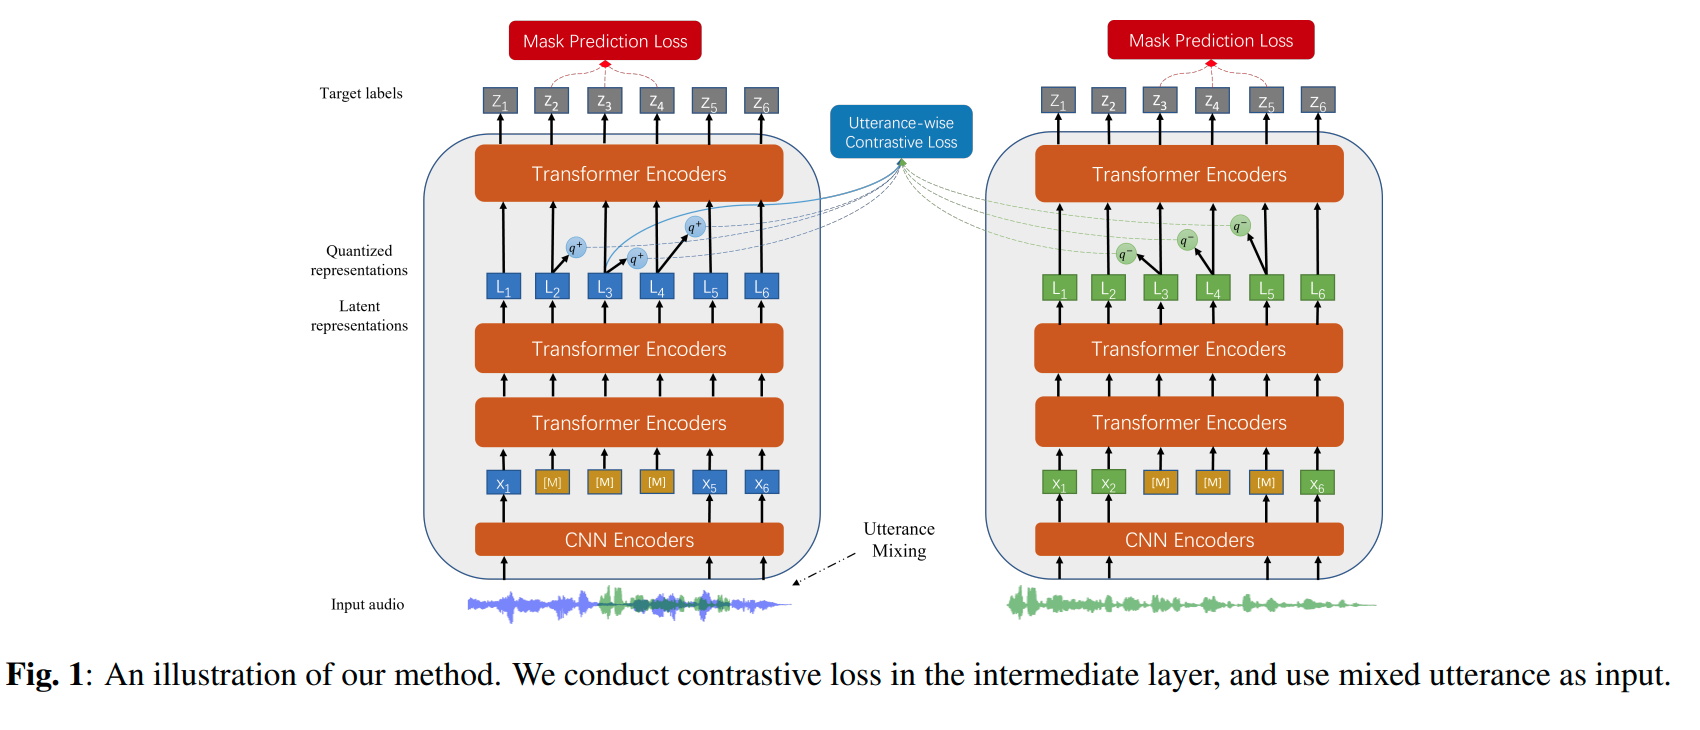
Abstract Self-supervised learning (SSL) is a long-standing goal for speech processing, since it utilizes large-scale unlabeled data and avoids extensive human labeling. Recent years witness great successes in applying self-supervised learning in speech recognition, while limited exploration was attempted in applying SSL for modeling speaker characteristics. In this paper, we aim to improve the existing SSL framework for speaker representation learning. Two methods are introduced for enhancing the unsupervised speaker information extraction. First, we apply the multi-task learning to the current SSL framework, where we integrate the utterance-wise contrastive loss with the SSL objective function. Second, for better speaker discrimination, we propose an utterance mixing strategy for data augmentation, where additional overlapped utterances are created unsupervisely and incorporate during training. We integrate the proposed methods into the HuBERT framework. Experiment results on SUPERB benchmark show that the proposed system achieves state-of-the-art performance in universal representation learning, especially for speaker identification oriented tasks. An ablation study is performed verifying the efficacy of each proposed method. Finally, we scale up training dataset to 94 thousand hours public audio data and achieve further performance improvement in all SUPERB tasks..

The original model can be found under https://github.com/microsoft/UniSpeech/tree/main/UniSpeech-SAT.

Usage

To transcribe audio files the model can be used as a standalone acoustic model as follows:

 from transformers import Wav2Vec2Processor, UniSpeechSatForCTC
 from datasets import load_dataset
 import torch
 
 # load model and tokenizer
 processor = Wav2Vec2Processor.from_pretrained("microsoft/unispeech-sat-base-100h-libri-ft")
 model = UniSpeechSatForCTC.from_pretrained("microsoft/unispeech-sat-base-100h-libri-ft")
     
 # load dummy dataset
 ds = load_dataset("patrickvonplaten/librispeech_asr_dummy", "clean", split="validation")
 
 # tokenize
 input_values = processor(ds[0]["audio"]["array"], return_tensors="pt", padding="longest").input_values  # Batch size 1
 
 # retrieve logits
 logits = model(input_values).logits
 
 # take argmax and decode
 predicted_ids = torch.argmax(logits, dim=-1)
 transcription = processor.batch_decode(predicted_ids)

Contribution

The model was contributed by cywang and patrickvonplaten.

License

The official license can be found here
design

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
UniSpeechSatForCTC
Ревизия весов
b294556

0 моделей