/ Модель

Характеристики

Параметры
113 млн
Архитектура
wavlm · dense
Опубликована
2 мар 2022

wavlm-base-plus-sd

Языковая модель5 профессий

Дообученная версия WavLM-Base-Plus для покадрового определения говорящих в аудиозаписях.

70 245скачиваний за 30 дней15лайковвеса обновлены25 мар 2022

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки21

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

  • SIBFLEURS

    main_score

    Результат

    0,1506

    Общий результат 0,1787Общий результат 0,1696Общий результат 0,1696
    MTEB

    Публичная таблицаревизия совпадает

  • MridinghamStroke

    main_score

    Результат

    0,4225

    MTEB

    Публичная таблицаревизия совпадает

  • VoxCelebClustering

    main_score

    Результат

    0,004

    MTEB

    Публичная таблицаревизия совпадает

  • LibriCount

    main_score

    Результат

    0,5206

    MTEB

    Публичная таблицаревизия совпадает

  • VoiceGenderClustering

    main_score

    Результат

    0,0532

    MTEB

    Публичная таблицаревизия совпадает

  • ESC50PairClassification

    main_score

    Результат

    0,7907

    MTEB

    Публичная таблицаревизия совпадает

  • FSDD

    main_score

    Результат

    0,914

    MTEB

    Публичная таблицаревизия совпадает

  • JamAltArtistA2ARetrieval

    main_score

    Результат

    0,7189

    MTEB

    Публичная таблицаревизия совпадает

  • GTZANGenre

    main_score

    Результат

    0,629

    MTEB

    Публичная таблицаревизия совпадает

  • BirdCLEF

    main_score

    Результат

    0,12

    MTEB

    Публичная таблицаревизия совпадает

  • VoxPopuliLanguageID

    main_score

    Результат

    0,644

    MTEB

    Публичная таблицаревизия совпадает

  • NMSQAPairClassification

    main_score

    Результат

    0,4842

    MTEB

    Публичная таблицаревизия совпадает

  • SpeechCommands

    main_score

    Результат

    0,8306

    MTEB

    Публичная таблицаревизия совпадает

  • MInDS14

    main_score

    Результат

    0,1442

    MTEB

    Публичная таблицаревизия совпадает

  • UrbanSound8KAudioReranking

    main_score

    Результат

    0,4934

    MTEB

    Публичная таблицаревизия совпадает

  • IEMOCAPEmotion

    main_score

    Результат

    0,1842

    MTEB

    Публичная таблицаревизия совпадает

  • VoxLingua107_Top10

    main_score

    Результат

    0,3384

    MTEB

    Публичная таблицаревизия совпадает

  • ESC50

    main_score

    Результат

    0,575

    MTEB

    Публичная таблицаревизия совпадает

  • VoxPopuliAccentPairClassification

    main_score

    Результат

    0,5091

    MTEB

    Публичная таблицаревизия совпадает

  • GunshotTriangulation

    main_score

    Результат

    0,9771

    MTEB

    Публичная таблицаревизия совпадает

  • VoxPopuliGenderID

    main_score

    Результат

    0,572

    MTEB

    Публичная таблицаревизия совпадает

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

microsoft/wavlm-base-plus-sd — модель Microsoft для диаризации речи, дообученная на базе WavLM-Base-Plus. Она принимает речевой сигнал с частотой дискретизации 16 кГц и выдаёт покадровые предсказания для различения говорящих. Модель основана на архитектуре Transformer из семейства WavLM и содержит 113,3 млн параметров.

Базовый WavLM предварительно обучен на Libri-Light, GigaSpeech и VoxPopuli с использованием самообучения, учитывающего содержание речи и идентичность говорящего. Для диаризации эту версию дообучили на LibriMix, добавив линейный классификационный слой. Она предназначена для анализа записей с несколькими говорящими; заявленная задача — классификация аудиокадров.

Модель ориентирована на английскую речь. В описании не приведены метрики качества или подробности о работе с перекрывающейся речью и шумом. Репозиторий содержит веса PyTorch; лицензия в предоставленных данных не указана.

Сценарии применения

  • определение смены говорящих в записи разговора
  • разметка аудиозаписи по говорящим
  • анализ многоголосых записей речи

Ограничения

Для входного аудио требуется частота дискретизации 16 кГц. В предоставленных данных нет метрик качества и сведений о лицензии.

Для каких профессий подходит5

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

WavLM-Base-Plus for Speaker Diarization

Microsoft's WavLM

The model was pretrained on 16kHz sampled speech audio with utterance and speaker contrastive loss. When using the model, make sure that your speech input is also sampled at 16kHz.

The model was pre-trained on:

Paper: WavLM: Large-Scale Self-Supervised Pre-Training for Full Stack Speech Processing

Authors: Sanyuan Chen, Chengyi Wang, Zhengyang Chen, Yu Wu, Shujie Liu, Zhuo Chen, Jinyu Li, Naoyuki Kanda, Takuya Yoshioka, Xiong Xiao, Jian Wu, Long Zhou, Shuo Ren, Yanmin Qian, Yao Qian, Jian Wu, Michael Zeng, Furu Wei

Abstract Self-supervised learning (SSL) achieves great success in speech recognition, while limited exploration has been attempted for other speech processing tasks. As speech signal contains multi-faceted information including speaker identity, paralinguistics, spoken content, etc., learning universal representations for all speech tasks is challenging. In this paper, we propose a new pre-trained model, WavLM, to solve full-stack downstream speech tasks. WavLM is built based on the HuBERT framework, with an emphasis on both spoken content modeling and speaker identity preservation. We first equip the Transformer structure with gated relative position bias to improve its capability on recognition tasks. For better speaker discrimination, we propose an utterance mixing training strategy, where additional overlapped utterances are created unsupervisely and incorporated during model training. Lastly, we scale up the training dataset from 60k hours to 94k hours. WavLM Large achieves state-of-the-art performance on the SUPERB benchmark, and brings significant improvements for various speech processing tasks on their representative benchmarks.

The original model can be found under https://github.com/microsoft/unilm/tree/master/wavlm.

Fine-tuning details

The model is fine-tuned on the LibriMix dataset using just a linear layer for mapping the network outputs.

Usage

Speaker Diarization

from transformers import Wav2Vec2FeatureExtractor, WavLMForAudioFrameClassification
from datasets import load_dataset
import torch

dataset = load_dataset("hf-internal-testing/librispeech_asr_demo", "clean", split="validation")
feature_extractor = Wav2Vec2FeatureExtractor.from_pretrained('microsoft/wavlm-base-plus-sd')
model = WavLMForAudioFrameClassification.from_pretrained('microsoft/wavlm-base-plus-sd')

# audio file is decoded on the fly
inputs = feature_extractor(dataset[0]["audio"]["array"], return_tensors="pt")
logits = model(**inputs).logits
probabilities = torch.sigmoid(logits[0])

# labels is a one-hot array of shape (num_frames, num_speakers)
labels = (probabilities > 0.5).long()

License

The official license can be found here
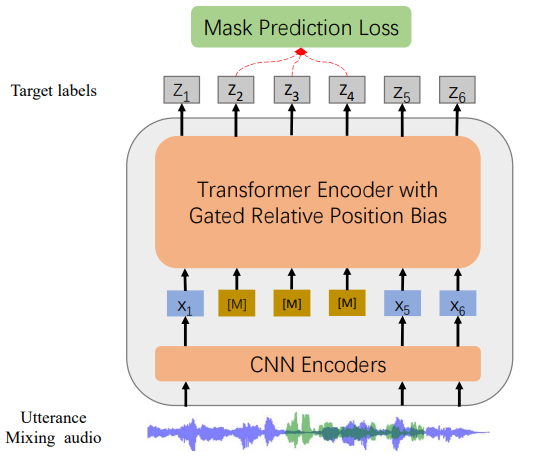
design

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Нельзя запустить

У модели не указана задача.

Класс архитектуры
WavLMForAudioFrameClassification
Ревизия весов
5bd86f0

0 моделей