/ Модель

Характеристики

Параметры
113 млн
Архитектура
wavlm · dense
Опубликована
2 мар 2022

wavlm-base-plus-sv

Языковая модель5 профессий

Дообученная на VoxCeleb1 модель WavLM для извлечения голосовых признаков и проверки личности говорящего по речи.

360 тыс.скачиваний за 30 дней60лайковвеса обновлены25 мар 2022

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки17

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

  • SIBFLEURS

    main_score

    Результат

    0,0893

    Общий результат 0,1968Общий результат 0,1688Общий результат 0,1609
    MTEB

    Публичная таблицаревизия совпадает

  • ESC50AudioReranking

    main_score

    Результат

    0,668

    MTEB

    Публичная таблицаревизия совпадает

  • UrbanSound8k

    main_score

    Результат

    0,5411

    MTEB

    Публичная таблицаревизия совпадает

  • JamAltArtistA2ARetrieval

    main_score

    Результат

    0,7716

    Общий результат 0,7189
    MTEB

    Публичная таблицаревизия совпадает

  • VoxPopuliGenderClustering

    main_score

    Результат

    0,0003

    MTEB

    Публичная таблицаревизия совпадает

  • GunshotTriangulation

    main_score

    Результат

    0,9771

    MTEB

    Публичная таблицаревизия совпадает

  • VoxPopuliAccentClustering

    main_score

    Результат

    0,0284

    MTEB

    Публичная таблицаревизия совпадает

  • AmbientAcousticContext

    main_score

    Результат

    0,272

    MTEB

    Публичная таблицаревизия совпадает

  • UrbanSound8KAudioReranking

    main_score

    Результат

    0,4934

    MTEB

    Публичная таблицаревизия совпадает

  • MInDS14

    main_score

    Результат

    0,1176

    Общий результат 0,1442
    MTEB

    Публичная таблицаревизия совпадает

  • FSD2019Kaggle

    main_score

    Результат

    0,1175

    MTEB

    Публичная таблицаревизия совпадает

  • TUTAcousticScenes

    main_score

    Результат

    0,2715

    MTEB

    Публичная таблицаревизия совпадает

  • BirdSet

    main_score

    Результат

    0,2742

    MTEB

    Публичная таблицаревизия совпадает

  • IEMOCAPEmotion

    main_score

    Результат

    0,1842

    MTEB

    Публичная таблицаревизия совпадает

  • VoxPopuliLanguageID

    main_score

    Результат

    0,644

    MTEB

    Публичная таблицаревизия совпадает

  • ESC50

    main_score

    Результат

    0,575

    MTEB

    Публичная таблицаревизия совпадает

  • CREMADPairClassification

    main_score

    Результат

    0,5486

    MTEB

    Публичная таблицаревизия совпадает

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

WavLM-Base-Plus-SV — модель Microsoft для проверки и сопоставления голосов. Она основана на WavLM и дообучена на наборе VoxCeleb1: к акустической модели добавлена голова X-Vector, обученная с функцией потерь Additive Margin Softmax. В архитектуре используется WavLM с Transformer; модель содержит 113,3 млн параметров.

Модель принимает речевой аудиосигнал, записанный с частотой 16 кГц, и предназначена для получения признаков голоса, пригодных для распознавания и верификации говорящего. Она предварительно обучалась на корпусах Libri-Light, GigaSpeech и VoxPopuli. Модель не предназначена для распознавания речи «из коробки»: у неё нет токенизатора, и для ASR потребуется отдельная донастройка на размеченных текстовых данных. Лицензия в предоставленных данных не указана.

Сценарии применения

  • проверка, принадлежит ли запись заданному человеку
  • сопоставление голосов в двух аудиозаписях
  • извлечение голосовых эмбеддингов для идентификации говорящего
  • поиск совпадений голоса в коллекции речевых записей

Ограничения

Входная речь должна быть дискретизирована с частотой 16 кГц. Модель не выполняет распознавание речи без отдельного токенизатора и дообучения на размеченных текстовых данных.

Для каких профессий подходит5

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

WavLM-Base-Plus for Speaker Verification

Microsoft's WavLM

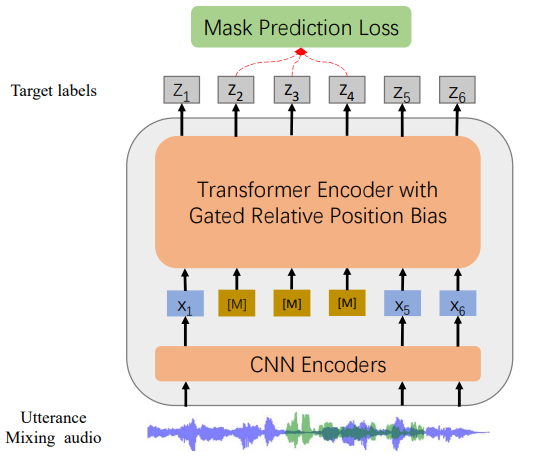
The model was pretrained on 16kHz sampled speech audio with utterance and speaker contrastive loss. When using the model, make sure that your speech input is also sampled at 16kHz.

Note: This model does not have a tokenizer as it was pretrained on audio alone. In order to use this model speech recognition, a tokenizer should be created and the model should be fine-tuned on labeled text data. Check out this blog for more in-detail explanation of how to fine-tune the model.

The model was pre-trained on:

Paper: WavLM: Large-Scale Self-Supervised Pre-Training for Full Stack Speech Processing

Authors: Sanyuan Chen, Chengyi Wang, Zhengyang Chen, Yu Wu, Shujie Liu, Zhuo Chen, Jinyu Li, Naoyuki Kanda, Takuya Yoshioka, Xiong Xiao, Jian Wu, Long Zhou, Shuo Ren, Yanmin Qian, Yao Qian, Jian Wu, Michael Zeng, Furu Wei

Abstract Self-supervised learning (SSL) achieves great success in speech recognition, while limited exploration has been attempted for other speech processing tasks. As speech signal contains multi-faceted information including speaker identity, paralinguistics, spoken content, etc., learning universal representations for all speech tasks is challenging. In this paper, we propose a new pre-trained model, WavLM, to solve full-stack downstream speech tasks. WavLM is built based on the HuBERT framework, with an emphasis on both spoken content modeling and speaker identity preservation. We first equip the Transformer structure with gated relative position bias to improve its capability on recognition tasks. For better speaker discrimination, we propose an utterance mixing training strategy, where additional overlapped utterances are created unsupervisely and incorporated during model training. Lastly, we scale up the training dataset from 60k hours to 94k hours. WavLM Large achieves state-of-the-art performance on the SUPERB benchmark, and brings significant improvements for various speech processing tasks on their representative benchmarks.

The original model can be found under https://github.com/microsoft/unilm/tree/master/wavlm.

Fine-tuning details

The model is fine-tuned on the VoxCeleb1 dataset using an X-Vector head with an Additive Margin Softmax loss X-Vectors: Robust DNN Embeddings for Speaker Recognition

Usage

Speaker Verification

from transformers import Wav2Vec2FeatureExtractor, WavLMForXVector
from datasets import load_dataset
import torch

dataset = load_dataset("hf-internal-testing/librispeech_asr_demo", "clean", split="validation")

feature_extractor = Wav2Vec2FeatureExtractor.from_pretrained('microsoft/wavlm-base-plus-sv')
model = WavLMForXVector.from_pretrained('microsoft/wavlm-base-plus-sv')

# audio files are decoded on the fly
audio = [x["array"] for x in dataset[:2]["audio"]]
inputs = feature_extractor(audio, padding=True, return_tensors="pt")
embeddings = model(**inputs).embeddings
embeddings = torch.nn.functional.normalize(embeddings, dim=-1).cpu()

# the resulting embeddings can be used for cosine similarity-based retrieval
cosine_sim = torch.nn.CosineSimilarity(dim=-1)
similarity = cosine_sim(embeddings[0], embeddings[1])
threshold = 0.86  # the optimal threshold is dataset-dependent
if similarity < threshold:
    print("Speakers are not the same!")

License

The official license can be found here
design

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Нельзя запустить

У модели не указана задача.

Класс архитектуры
WavLMForXVector
Ревизия весов
feb593a

0 моделей