/ Модель

Характеристики

Параметры
403 млн
Архитектура
wavlm · dense

wavlm-large

ЭмбеддингиТекст → embedding3 профессии

Предварительно обученная модель Microsoft извлекает представления из английской речи для последующей настройки под распознавание и другие задачи обработки аудио.

683 тыс.скачиваний за 30 дней117лайковвеса обновлены2 фев 2022

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Эмбеддинги» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки25

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

  • ESC50AudioReranking

    main_score

    Результат

    0,6389

    MTEB

    Публичная таблицаревизия совпадает

  • AudioSetMini

    main_score

    Результат

    0,2971

    MTEB

    Публичная таблицаревизия совпадает

  • NSynth

    main_score

    Результат

    0,4714

    MTEB

    Публичная таблицаревизия совпадает

  • MInDS14

    main_score

    Результат

    0,1456

    Общий результат 0,1235Общий результат 0,1211Общий результат 0,1151
    MTEB

    Публичная таблицаревизия совпадает

  • SIBFLEURS

    main_score

    Результат

    0,0625

    Общий результат 0,2055Общий результат 0,1538Общий результат 0,1506
    MTEB

    Публичная таблицаревизия совпадает

  • AmbientAcousticContext

    main_score

    Результат

    0,2961

    MTEB

    Публичная таблицаревизия совпадает

  • GTZANGenre

    main_score

    Результат

    0,677

    MTEB

    Публичная таблицаревизия совпадает

  • VoxCelebSA

    main_score

    Результат

    0,3344

    MTEB

    Публичная таблицаревизия совпадает

  • VoiceGenderClustering

    main_score

    Результат

    0,1526

    MTEB

    Публичная таблицаревизия совпадает

  • ESC50Clustering

    main_score

    Результат

    0,441

    MTEB

    Публичная таблицаревизия совпадает

  • FSDD

    main_score

    Результат

    0,9147

    MTEB

    Публичная таблицаревизия совпадает

  • VoxPopuliAccentClustering

    main_score

    Результат

    0,0335

    MTEB

    Публичная таблицаревизия совпадает

  • GTZANAudioReranking

    main_score

    Результат

    0,6879

    MTEB

    Публичная таблицаревизия совпадает

  • VoxLingua107_Top10

    main_score

    Результат

    0,538

    MTEB

    Публичная таблицаревизия совпадает

  • CREMA_DClustering

    main_score

    Результат

    0,071

    MTEB

    Публичная таблицаревизия совпадает

  • VoxPopuliAccentID

    main_score

    Результат

    0,4982

    MTEB

    Публичная таблицаревизия совпадает

  • UrbanSound8k

    main_score

    Результат

    0,5545

    MTEB

    Публичная таблицаревизия совпадает

  • VoxPopuliLanguageID

    main_score

    Результат

    0,89

    MTEB

    Публичная таблицаревизия совпадает

  • MusicGenreClustering

    main_score

    Результат

    0,217

    MTEB

    Публичная таблицаревизия совпадает

  • FSD50K

    main_score

    Результат

    0,3568

    MTEB

    Публичная таблицаревизия совпадает

  • JamAltArtistA2ARetrieval

    main_score

    Результат

    0,8284

    Общий результат 0,8076
    MTEB

    Публичная таблицаревизия совпадает

  • VehicleSoundClustering

    main_score

    Результат

    0,0018

    MTEB

    Публичная таблицаревизия совпадает

  • ESC50

    main_score

    Результат

    0,642

    MTEB

    Публичная таблицаревизия совпадает

  • GTZANGenreClustering

    main_score

    Результат

    0,3694

    MTEB

    Публичная таблицаревизия совпадает

  • TUTAcousticScenes

    main_score

    Результат

    0,2415

    MTEB

    Публичная таблицаревизия совпадает

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

WavLM-Large — предварительно обученная Microsoft модель для извлечения речевых представлений из аудио. Она содержит 402,7 млн параметров и построена на архитектуре Transformer в рамках подхода HuBERT. Модель обучалась на 94 тысячах часов английской речи из Libri-Light, GigaSpeech и VoxPopuli, с акцентом на сохранение информации о произнесённом содержании и личности говорящего.

Модель принимает речевое аудио с частотой дискретизации 16 кГц и выдаёт аудиопризнаки, пригодные для последующей настройки под задачи распознавания речи, классификации аудио и других задач обработки речи. Для распознавания речи нужны токенизатор и дообучение на размеченных текстовых данных; сама модель не генерирует транскрипцию. В README заявлена хорошая работа на английском языке и результаты на бенчмарке SUPERB. Лицензия в предоставленных данных не указана.

Сценарии применения

  • извлечение признаков из английской речи для обучения downstream-моделей
  • подготовка аудиопредставлений для распознавания речи после дообучения
  • классификация речевых аудиозаписей после настройки
  • анализ характеристик и идентичности говорящего в исследовательских системах

Ограничения

Принимает речь, дискретизированную с частотой 16 кГц; для распознавания речи требуется токенизатор и дообучение на размеченных текстовых данных. Модель предварительно обучена на английском языке, поэтому, согласно README, лучше всего должна работать на английском.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

WavLM-Large

Microsoft's WavLM

The large model pretrained on 16kHz sampled speech audio. When using the model, make sure that your speech input is also sampled at 16kHz.

Note: This model does not have a tokenizer as it was pretrained on audio alone. In order to use this model speech recognition, a tokenizer should be created and the model should be fine-tuned on labeled text data. Check out this blog for more in-detail explanation of how to fine-tune the model.

The model was pre-trained on:

Paper: WavLM: Large-Scale Self-Supervised Pre-Training for Full Stack Speech Processing

Authors: Sanyuan Chen, Chengyi Wang, Zhengyang Chen, Yu Wu, Shujie Liu, Zhuo Chen, Jinyu Li, Naoyuki Kanda, Takuya Yoshioka, Xiong Xiao, Jian Wu, Long Zhou, Shuo Ren, Yanmin Qian, Yao Qian, Jian Wu, Michael Zeng, Furu Wei

Abstract Self-supervised learning (SSL) achieves great success in speech recognition, while limited exploration has been attempted for other speech processing tasks. As speech signal contains multi-faceted information including speaker identity, paralinguistics, spoken content, etc., learning universal representations for all speech tasks is challenging. In this paper, we propose a new pre-trained model, WavLM, to solve full-stack downstream speech tasks. WavLM is built based on the HuBERT framework, with an emphasis on both spoken content modeling and speaker identity preservation. We first equip the Transformer structure with gated relative position bias to improve its capability on recognition tasks. For better speaker discrimination, we propose an utterance mixing training strategy, where additional overlapped utterances are created unsupervisely and incorporated during model training. Lastly, we scale up the training dataset from 60k hours to 94k hours. WavLM Large achieves state-of-the-art performance on the SUPERB benchmark, and brings significant improvements for various speech processing tasks on their representative benchmarks.

The original model can be found under https://github.com/microsoft/unilm/tree/master/wavlm.

Usage

This is an English pre-trained speech model that has to be fine-tuned on a downstream task like speech recognition or audio classification before it can be used in inference. The model was pre-trained in English and should therefore perform well only in English. The model has been shown to work well on the SUPERB benchmark.

Note: The model was pre-trained on phonemes rather than characters. This means that one should make sure that the input text is converted to a sequence of phonemes before fine-tuning.

Speech Recognition

To fine-tune the model for speech recognition, see the official speech recognition example.

Speech Classification

To fine-tune the model for speech classification, see the official audio classification example.

Speaker Verification

TODO

Speaker Diarization

TODO

Contribution

The model was contributed by cywang and patrickvonplaten.

License

The official license can be found here
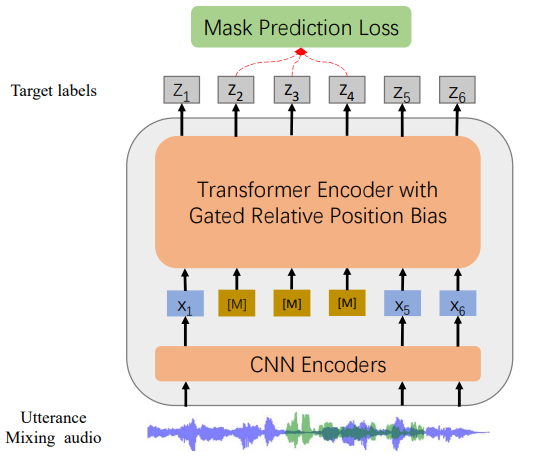
design

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
WavLMModel
Ревизия весов
c1423ed

0 моделей