/ Модель

Характеристики

Контекст
77 токенов
Лицензия
MIT
Архитектура
xclip · dense
Опубликована
8 сен 2022

xclip-large-patch14-kinetics-600

Классификация видеоВидео → label6 профессий

X-CLIP сопоставляет видео с текстом и подходит для классификации видео и поиска роликов по описанию.

90скачиваний за 30 дней7лайковвеса обновлены8 сен 2022

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

X-CLIP — видеоязыковая модель Microsoft на архитектуре XCLIP, основанная на CLIP и обученная с учителем на наборе Kinetics-600. Она сопоставляет видео и текст и предназначена для классификации видео без дополнительного обучения, с небольшим числом примеров или в полностью контролируемом режиме, а также для поиска видео по текстовому описанию. Модель обрабатывает 8 кадров размером 224×224; обучение построено на контрастивном сопоставлении пар «видео — текст». Для оценки на Kinetics-600 указаны точность top-1 88,3% и top-5 97,7%. Репозиторий содержит веса PyTorch, лицензия — MIT.

Сценарии применения

  • классификация действий в видео по заданным категориям
  • классификация видео по текстовым меткам без дообучения
  • поиск роликов по текстовому описанию
  • сопоставление видео с подписью или запросом
  • классификация видео с небольшим числом размеченных примеров

Ограничения

В описании заявлена обработка 8 кадров размером 224×224, поэтому возможности при других настройках могут отличаться. Указанные метрики относятся к Kinetics-600 и не гарантируют аналогичного качества на других типах видео.

Для каких профессий подходит6

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

X-CLIP (large-sized model)

X-CLIP model (large-sized, patch resolution of 14) trained fully-supervised on Kinetics-600. It was introduced in the paper Expanding Language-Image Pretrained Models for General Video Recognition by Ni et al. and first released in this repository.

This model was trained using 8 frames per video, at a resolution of 224x224.

Disclaimer: The team releasing X-CLIP did not write a model card for this model so this model card has been written by the Hugging Face team.

Model description

X-CLIP is a minimal extension of CLIP for general video-language understanding. The model is trained in a contrastive way on (video, text) pairs.
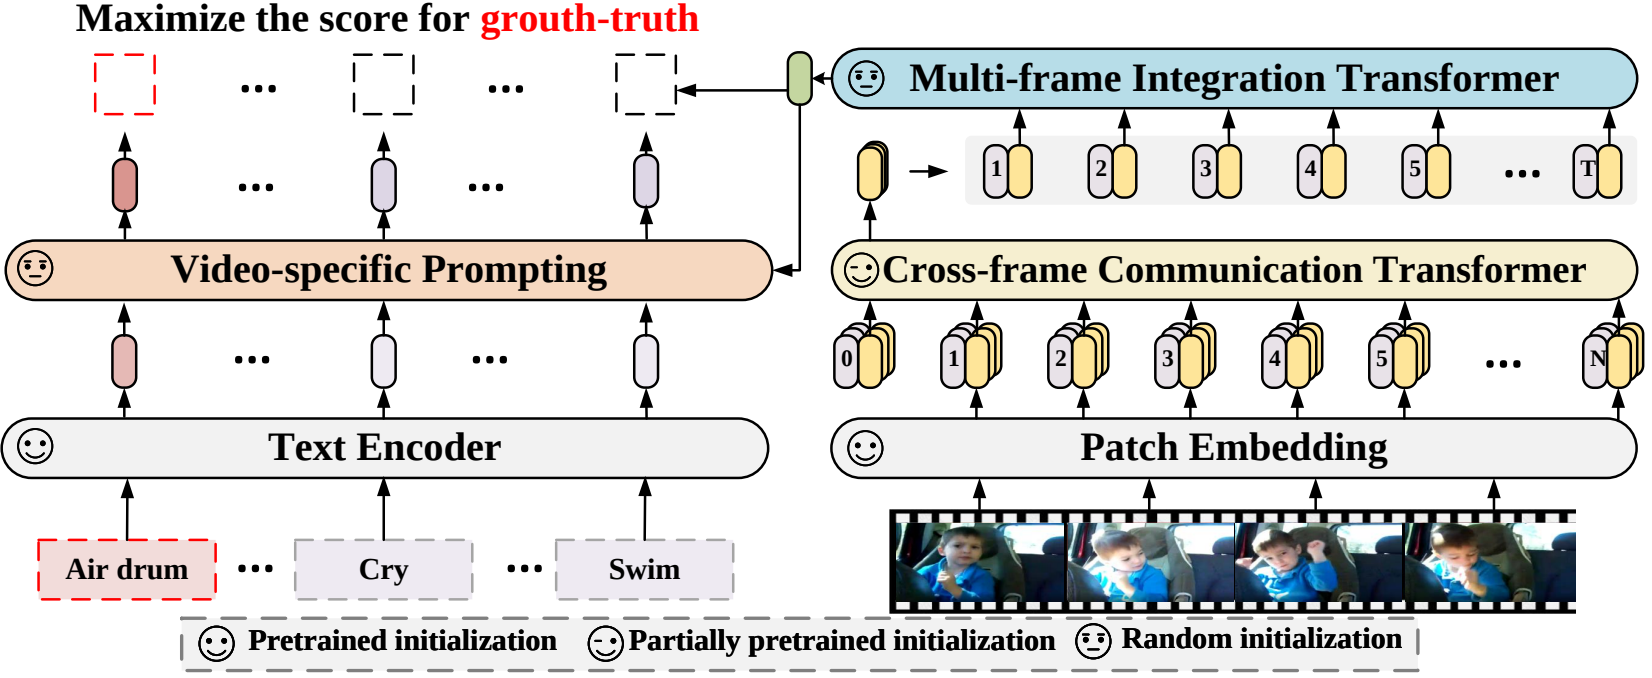
X-CLIP architecture

This allows the model to be used for tasks like zero-shot, few-shot or fully supervised video classification and video-text retrieval.

Intended uses & limitations

You can use the raw model for determining how well text goes with a given video. See the model hub to look for fine-tuned versions on a task that interests you.

How to use

For code examples, we refer to the documentation.

Training data

This model was trained on Kinetics-600.

Preprocessing

The exact details of preprocessing during training can be found here.

The exact details of preprocessing during validation can be found here.

During validation, one resizes the shorter edge of each frame, after which center cropping is performed to a fixed-size resolution (like 224x224). Next, frames are normalized across the RGB channels with the ImageNet mean and standard deviation.

Evaluation results

This model achieves a top-1 accuracy of 88.3% and a top-5 accuracy of 97.7%.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · video-classification

Нельзя запустить

Для архитектуры xclip нет загрузчика под задачу video-classification.

Класс архитектуры
XCLIPModel
Ревизия весов
0fed349

0 моделей