/ Модель

Характеристики

Контекст
512 токенов
Параметры
137 млн
Архитектура
bert · dense
Опубликована
2 мар 2022

bert-spanish-cased-finetuned-pos

Разметка токеновТекст → label3 профессии

Дообученная испанская BERT-модель для разметки частей речи и других категорий каждого токена в тексте.

63скачиваний за 30 дней6лайковвеса обновлены19 мар 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Модель mrm8488/bert-spanish-cased-finetuned-pos — дообученная Manuel Romero (@mrm8488) версия испанского BERT BETO для определения частей речи и другой токенной разметки в испанском тексте. Она обучена на испанских корпусах CONLL с аугментацией данных; в карточке указаны 340 тысяч примеров для обучения, 50 тысяч для проверки и 60 меток. На наборе оценки достигнута F1-мера 90,06.

Модель принимает текст и назначает метку каждому токену. Архитектура — BertForTokenClassification, размер — 137,1 млн параметров, максимальный контекст — 512 токенов. Доступны веса PyTorch, Flax и Safetensors. Лицензия в предоставленных данных не указана.

Сценарии применения

  • разметка частей речи в испанских предложениях
  • анализ грамматической структуры испанского текста
  • подготовка испанских текстовых корпусов для лингвистического анализа

Ограничения

Модель предназначена для испанского языка и обучена на корпусах CONLL; качество на других языках и доменах не описано. Контекст ограничен 512 токенами.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Spanish BERT (BETO) + POS

This model is a fine-tuned on Spanish CONLL CORPORA version of the Spanish BERT cased (BETO) for POS (Part of Speech tagging) downstream task.

Details of the downstream task (POS) - Dataset

I preprocessed the dataset and split it as train / dev (80/20)

Dataset# Examples
Train340 K
Dev50 K
AO, AQ, CC, CS, DA, DD, DE, DI, DN, DP, DT, Faa, Fat, Fc, Fd, Fe, Fg, Fh, Fia, Fit, Fp, Fpa, Fpt, Fs, Ft, Fx, Fz, I, NC, NP, P0, PD, PI, PN, PP, PR, PT, PX, RG, RN, SP, VAI, VAM, VAN, VAP, VAS, VMG, VMI, VMM, VMN, VMP, VMS, VSG, VSI, VSM, VSN, VSP, VSS, Y and Z

Metrics on evaluation set:

Metric# score
F190.06
Precision89.46
Recall90.67

Model in action

Fast usage with pipelines:

from transformers import pipeline

nlp_pos = pipeline(
    "ner",
    model="mrm8488/bert-spanish-cased-finetuned-pos",
    tokenizer=(
        'mrm8488/bert-spanish-cased-finetuned-pos',  
        {"use_fast": False}
))


text = 'Mis amigos están pensando en viajar a Londres este verano'

nlp_pos(text)

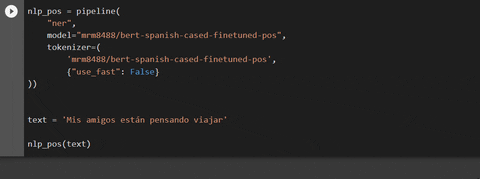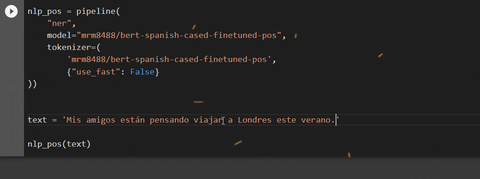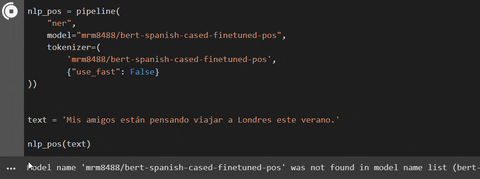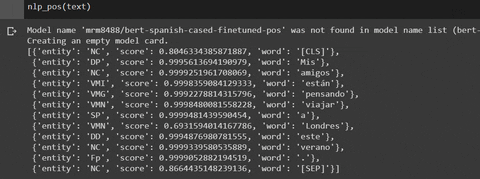
#Output:
'''
[{'entity': 'NC', 'score': 0.7792173624038696, 'word': '[CLS]'},
 {'entity': 'DP', 'score': 0.9996283650398254, 'word': 'Mis'},
 {'entity': 'NC', 'score': 0.9999253749847412, 'word': 'amigos'},
 {'entity': 'VMI', 'score': 0.9998560547828674, 'word': 'están'},
 {'entity': 'VMG', 'score': 0.9992249011993408, 'word': 'pensando'},
 {'entity': 'SP', 'score': 0.9999602437019348, 'word': 'en'},
 {'entity': 'VMN', 'score': 0.9998666048049927, 'word': 'viajar'},
 {'entity': 'SP', 'score': 0.9999545216560364, 'word': 'a'},
 {'entity': 'VMN', 'score': 0.8722310662269592, 'word': 'Londres'},
 {'entity': 'DD', 'score': 0.9995203614234924, 'word': 'este'},
 {'entity': 'NC', 'score': 0.9999248385429382, 'word': 'verano'},
 {'entity': 'NC', 'score': 0.8802427649497986, 'word': '[SEP]'}]
 '''
model in action

16 POS tags version also available here

Created by Manuel Romero/@mrm8488

Made with ♥ in Spain

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · token-classification

Можно запустить

Подбираем GPU…

Класс архитектуры
BertForTokenClassification
Ревизия весов
a5ade48

0 моделей