BETO (Spanish BERT) + Spanish SQuAD2.0 + distillation using 'bert-base-multilingual-cased' as teacher
This model is a fine-tuned on SQuAD-es-v2.0 and distilled version of BETO for Q&A.
Distillation makes the model smaller, faster, cheaper and lighter than bert-base-spanish-wwm-cased-finetuned-spa-squad2-es
This model was fine-tuned on the same dataset but using distillation during the process as mentioned above (and one more train epoch).
The teacher model for the distillation was bert-base-multilingual-cased. It is the same teacher used for distilbert-base-multilingual-cased AKA DistilmBERT (on average is twice as fast as mBERT-base).
Details of the downstream task (Q&A) - Dataset
| Dataset | # Q&A |
|---|---|
| SQuAD2.0 Train | 130 K |
| SQuAD2.0-es-v2.0 | 111 K |
| SQuAD2.0 Dev | 12 K |
| SQuAD-es-v2.0-small Dev | 69 K |
Model training
The model was trained on a Tesla P100 GPU and 25GB of RAM with the following command:
!export SQUAD_DIR=/path/to/squad-v2_spanish \
&& python transformers/examples/distillation/run_squad_w_distillation.py \
  --model_type bert \
  --model_name_or_path dccuchile/bert-base-spanish-wwm-cased \
  --teacher_type bert \
  --teacher_name_or_path bert-base-multilingual-cased \
  --do_train \
  --do_eval \
  --do_lower_case \
  --train_file $SQUAD_DIR/train-v2.json \
  --predict_file $SQUAD_DIR/dev-v2.json \
  --per_gpu_train_batch_size 12 \
  --learning_rate 3e-5 \
  --num_train_epochs 5.0 \
  --max_seq_length 384 \
  --doc_stride 128 \
  --output_dir /content/model_output \
  --save_steps 5000 \
  --threads 4 \
  --version_2_with_negative
Results:
TBA
Model in action
Fast usage with pipelines:
from transformers import *

# Important!: By now the QA pipeline is not compatible with fast tokenizer, but they are working on it. So that pass the object to the tokenizer {"use_fast": False} as in the following example:

nlp = pipeline(
    'question-answering',
    model='mrm8488/distill-bert-base-spanish-wwm-cased-finetuned-spa-squad2-es',
    tokenizer=(
        'mrm8488/distill-bert-base-spanish-wwm-cased-finetuned-spa-squad2-es',
        {"use_fast": False}
    )
)

nlp(
    {
        'question': '¿Para qué lenguaje está trabajando?',
        'context': 'Manuel Romero está colaborando activamente con huggingface/transformers ' +
                    'para traer el poder de las últimas técnicas de procesamiento de lenguaje natural al idioma español'
    }
)
# Output: {'answer': 'español', 'end': 169, 'score': 0.67530957344621, 'start': 163}
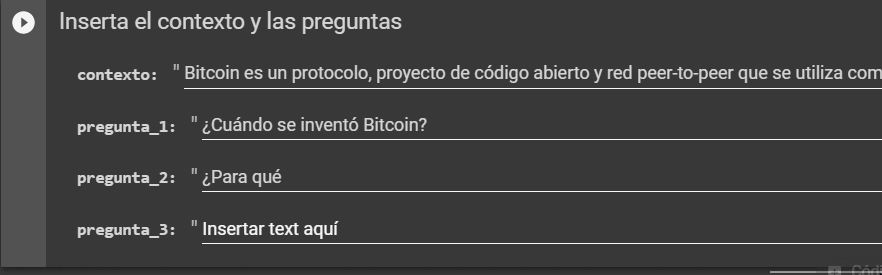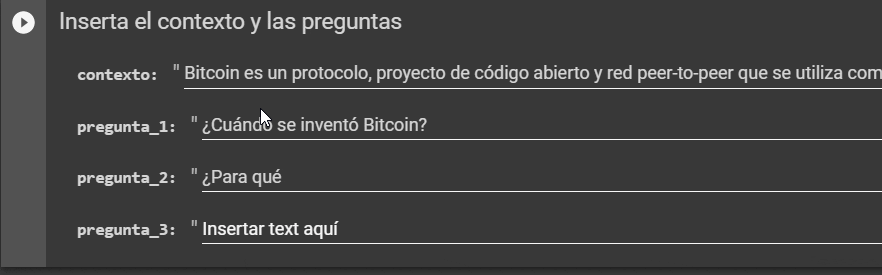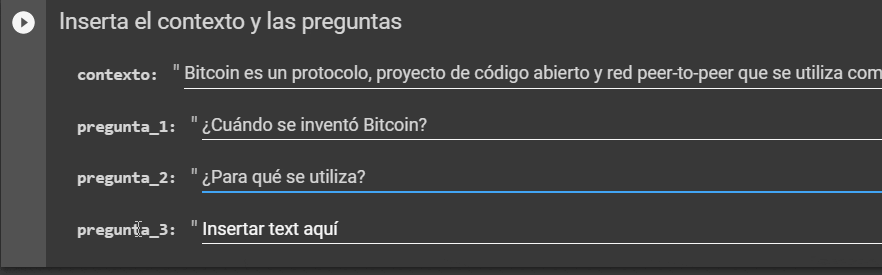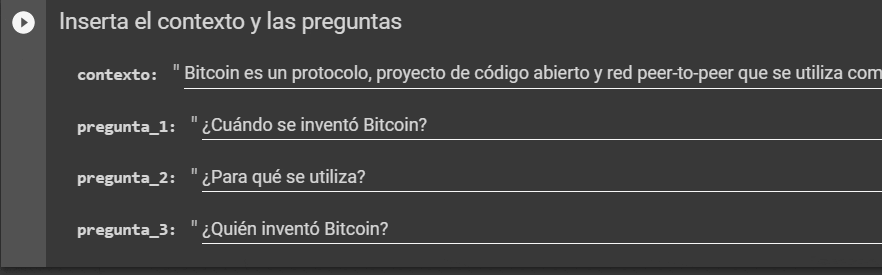
Play with this model and pipelines in a Colab:
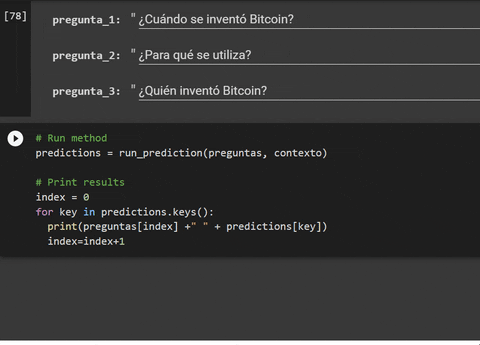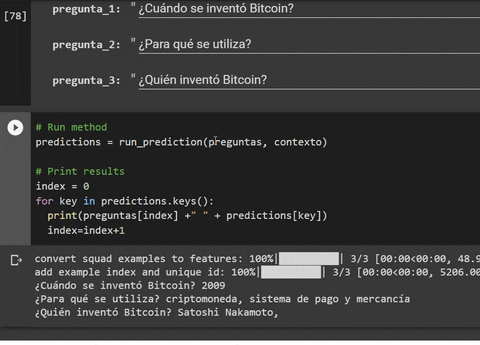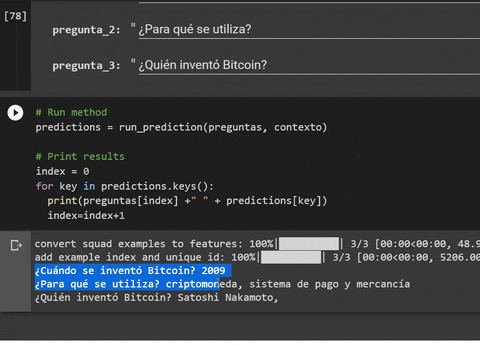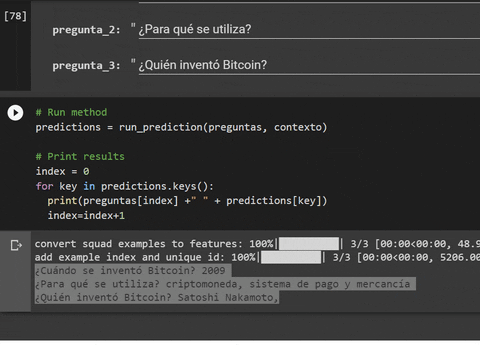
- Set the context and ask some questions:
- Run predictions:
More about Huggingface pipelines? check this Colab out:
Created by Manuel Romero/@mrm8488
Made with ♥ in Spain