Please Note!
This model is NOT the 19.2M images Characters Model on TrinArt, but an improved version of the original Trin-sama Twitter bot model. This model is intended to retain the original SD's aesthetics as much as possible while nudging the model to anime/manga style.
Other TrinArt models can be found at:
https://huggingface.co/naclbit/trinart_derrida_characters_v2_stable_diffusion
https://huggingface.co/naclbit/trinart_characters_19.2m_stable_diffusion_v1
Diffusers
The model has been ported to diffusers by ayan4m1
and can easily be run from one of the branches:
revision="diffusers-60k"for the checkpoint trained on 60,000 steps,revision="diffusers-95k"for the checkpoint trained on 95,000 steps,revision="diffusers-115k"for the checkpoint trained on 115,000 steps.
For more information, please have a look at the "Three flavors" section.
Gradio
We also support a Gradio web ui with diffusers to run inside a colab notebook: 
Example Text2Image
# !pip install diffusers==0.3.0
from diffusers import StableDiffusionPipeline

# using the 60,000 steps checkpoint
pipe = StableDiffusionPipeline.from_pretrained("naclbit/trinart_stable_diffusion_v2", revision="diffusers-60k")
pipe.to("cuda")

image = pipe("A magical dragon flying in front of the Himalaya in manga style").images[0]
image

If you want to run the pipeline faster or on a different hardware, please have a look at the optimization docs.
Example Image2Image
# !pip install diffusers==0.3.0
from diffusers import StableDiffusionImg2ImgPipeline
import requests
from PIL import Image
from io import BytesIO

url = "https://scitechdaily.com/images/Dog-Park.jpg"

response = requests.get(url)
init_image = Image.open(BytesIO(response.content)).convert("RGB")
init_image = init_image.resize((768, 512))

# using the 115,000 steps checkpoint
pipe = StableDiffusionImg2ImgPipeline.from_pretrained("naclbit/trinart_stable_diffusion_v2", revision="diffusers-115k")
pipe.to("cuda")

images = pipe(prompt="Manga drawing of Brad Pitt", init_image=init_image, strength=0.75, guidance_scale=7.5).images
image
If you want to run the pipeline faster or on a different hardware, please have a look at the optimization docs.
Stable Diffusion TrinArt/Trin-sama AI finetune v2
trinart_stable_diffusion is a SD model finetuned by about 40,000 assorted high resolution manga/anime-style pictures for 8 epochs. This is the same model running on Twitter bot @trinsama (https://twitter.com/trinsama)
Twitterボット「とりんさまAI」@trinsama (https://twitter.com/trinsama) で使用しているSDのファインチューン済モデルです。一定のルールで選別された約4万枚のアニメ・マンガスタイルの高解像度画像を用いて約8エポックの訓練を行いました。
Version 2
V2 checkpoint uses dropouts, 10,000 more images and a new tagging strategy and trained longer to improve results while retaining the original aesthetics.
バージョン2は画像を1万枚追加したほか、ドロップアウトの適用、タグ付けの改善とより長いトレーニング時間により、SDのスタイルを保ったまま出力内容の改善を目指しています。
Three flavors
Step 115000/95000 checkpoints were trained further, but you may use step 60000 checkpoint instead if style nudging is too much.
ステップ115000/95000のチェックポイントでスタイルが変わりすぎると感じる場合は、ステップ60000のチェックポイントを使用してみてください。
img2img
If you want to run latent-diffusion's stock ddim img2img script with this model, use_ema must be set to False.
latent-diffusion のscriptsフォルダに入っているddim img2imgをこのモデルで動かす場合、use_emaはFalseにする必要があります。
Hardware
- 8xNVIDIA A100 40GB
Training Info
- Custom dataset loader with augmentations: XFlip, center crop and aspect-ratio locked scaling
- LR: 1.0e-5
- 10% dropouts
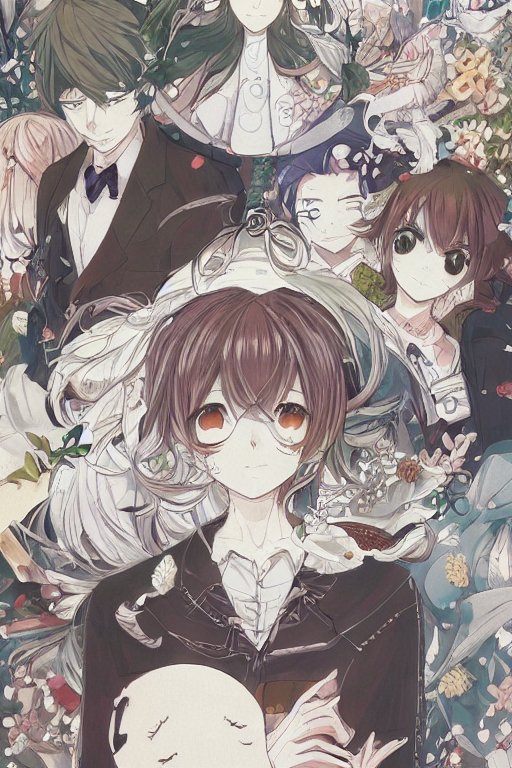
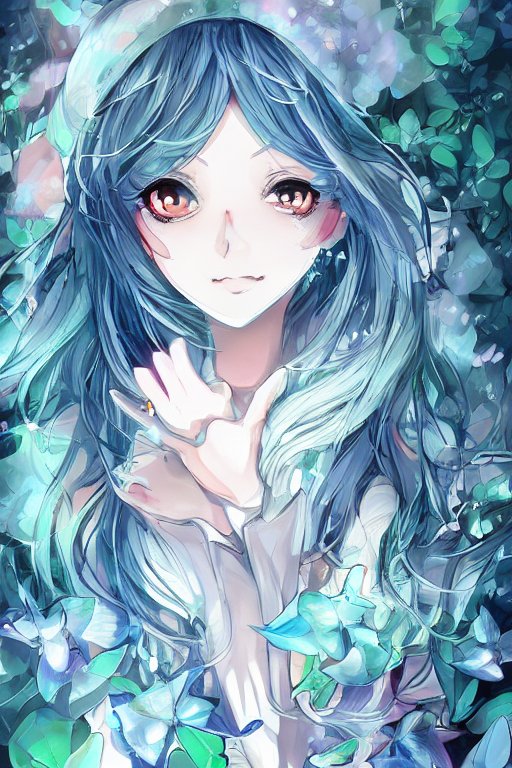
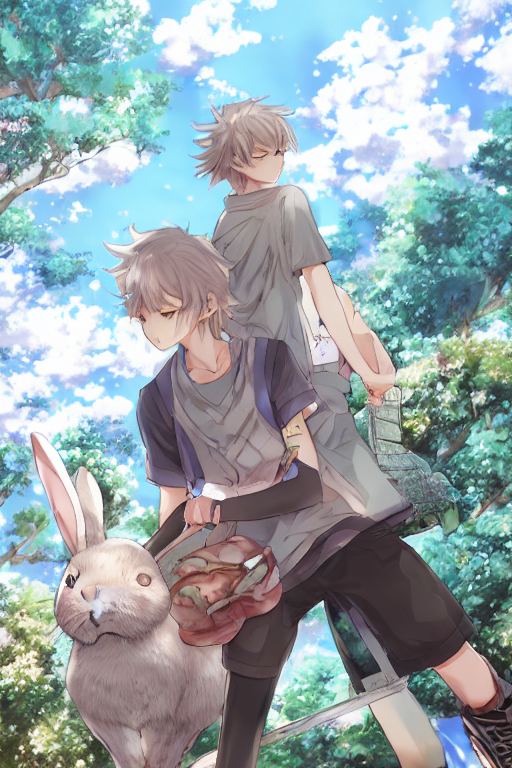
Examples
Each images were diffused using K. Crowson's k-lms (from k-diffusion repo) method for 50 steps.
Credits
- Sta, AI Novelist Dev (https://ai-novel.com/) @ Bit192, Inc.
- Stable Diffusion - Rombach, Robin and Blattmann, Andreas and Lorenz, Dominik and Esser, Patrick and Ommer, Bjorn
License
CreativeML OpenRAIL-M