PathummaLLM-text-1.0.0-7B: Thai & China & English Large Language Model Instruct
PathummaLLM-text-1.0.0-7B is a Thai 🇹🇭 & China 🇨🇳 & English 🇬🇧 large language model with 7 billion parameters, and it is Instruction finetune based on OpenThaiLLM-Prebuilt. It demonstrates competitive performance with Openthaigpt1.5-7b-instruct, and its optimized for application use cases, Retrieval-Augmented Generation (RAG), constrained generation, and reasoning tasks.
Model Detail
For release notes, please see our blog. The detail about Text LLM part in this blog.
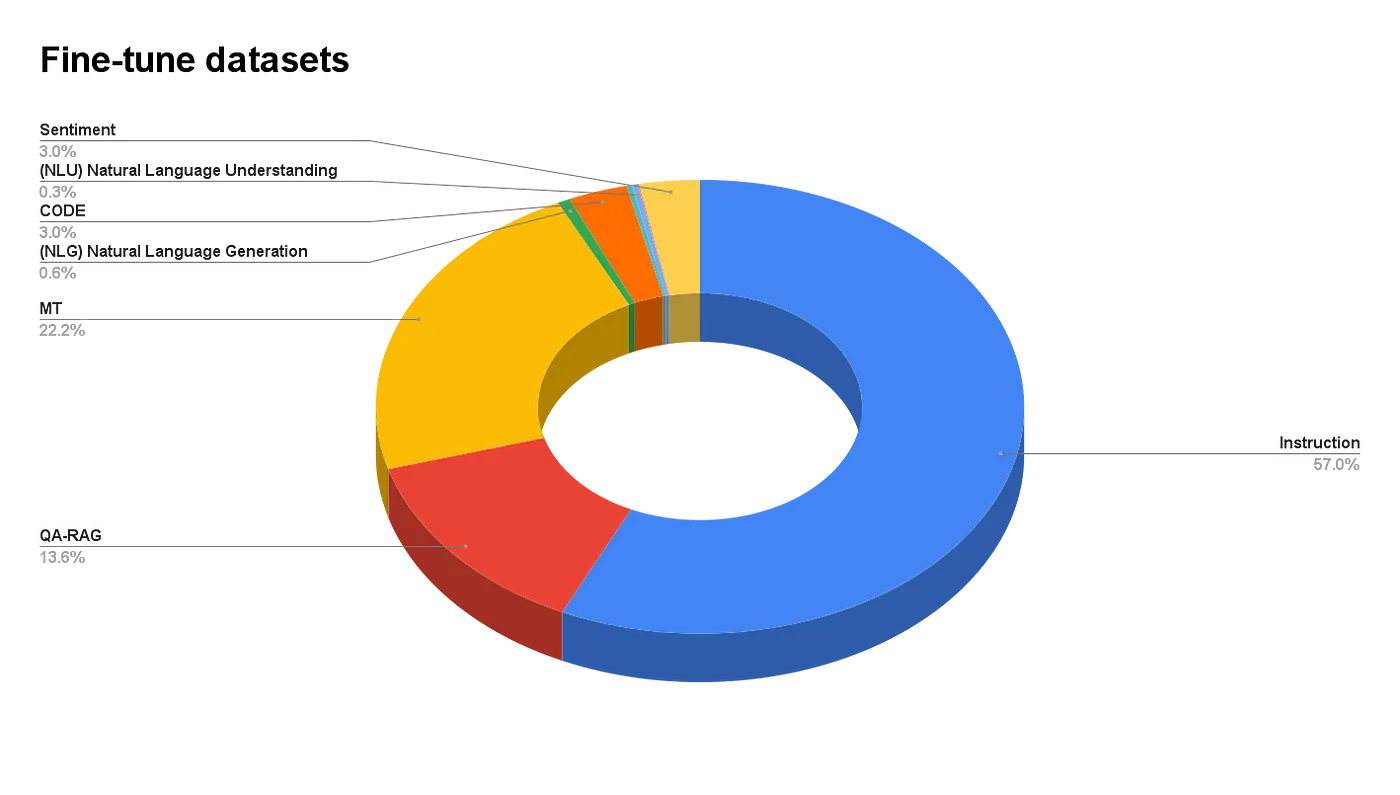
Datasets ratio
Requirements
The code of Qwen2.5 has been in the latest Hugging face transformers and we advise you to use the latest version of transformers.
With transformers<4.37.0, you will encounter the following error:
KeyError: 'qwen2'
Support Community
Implementation
Here is a code snippet with apply_chat_template to show you how to load the tokenizer and model and how to generate content.
from transformers import AutoModelForCausalLM, AutoTokenizer
device = "cuda" # the device to load the model onto

model = AutoModelForCausalLM.from_pretrained(
    "nectec/Pathumma-llm-text-1.0.0",
    torch_dtype="auto",
    device_map="auto"
)
tokenizer = AutoTokenizer.from_pretrained("nectec/Pathumma-llm-text-1.0.0")

prompt = "บริษัท A มีต้นทุนคงที่ 100,000 บาท และต้นทุนผันแปรต่อหน่วย 50 บาท ขายสินค้าได้ในราคา 150 บาทต่อหน่วย ต้องขายสินค้าอย่างน้อยกี่หน่วยเพื่อให้ถึงจุดคุ้มทุน?"
messages = [
    {"role": "system", "content": "You are Pathumma LLM, created by NECTEC. Your are a helpful assistant."},
    {"role": "user", "content": prompt}
]
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True
)
model_inputs = tokenizer([text], return_tensors="pt").to(model.device)

generated_ids = model.generate(
    model_inputs.input_ids,
    max_new_tokens=4096,
    repetition_penalty=1.1,
    temperature = 0.4
)
response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]
print(response)
Implementation for GGUF
%pip install --quiet https://github.com/abetlen/llama-cpp-python/releases/download/v0.2.90-cu124/llama_cpp_python-0.2.90-cp310-cp310-linux_x86_64.whl
import transformers
import torch
from llama_cpp import Llama
import os
import requests

local_dir = "your local dir"
directory_path = r'{local_dir}/Pathumma-llm-text-1.0.0'
if not os.path.exists(directory_path):
    os.mkdir(directory_path)

if not os.path.exists(f'{local_dir}/Pathumma-llm-text-1.0.0/Pathumma-llm-it-7b-Q4_K_M.gguf'):
    !wget -O f'{local_dir}/Pathumma-llm-text-1.0.0/Pathumma-llm-it-7b-Q4_K_M.gguf' "https://huggingface.co/nectec/Pathumma-llm-text-1.0.0/resolve/main/Pathumma-llm-it-7b-Q4_K_M.gguf?download=true"

# Initialize the Llama model
llm = Llama(model_path=f'{local_dir}/Pathumma-llm-text-1.0.0/Pathumma-llm-it-7b-Q4_K_M.gguf', n_gpu_layers=-1, n_ctx=8192,verbose=False)
tokenizer = transformers.AutoTokenizer.from_pretrained("nectec/Pathumma-llm-text-1.0.0")

memory = [{'content': 'You are Pathumma LLM, created by NECTEC (National Electronics and Computer Technology Center). Your are a helpful assistant.', 'role': 'system'},]

def generate(instuction,memory=memory):
    memory.append({'content': instuction, 'role': 'user'})
    p = tokenizer.apply_chat_template(
        memory,
        tokenize=False,
        add_generation_prompt=True
    )
    response = llm(
        p,
        max_tokens=2048,
        temperature=0.2,
        top_p=0.95,
        repeat_penalty=1.1,
        top_k=40,
        min_p=0.05,
        stop=["<|im_end|>"]
    )
    output = response['choices'][0]['text']
    memory.append({'content': output, 'role': 'assistant'})
    return output

print(generate("คุณคือใคร"))
Evaluation Performance
| Model | m3exam | thaiexam | xcopa | belebele | xnli | thaisentiment | XL sum | flores200 eng > th | flores200 th > eng | iapp | AVG(NLU) | AVG(MC) | AVG(NLG) |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Pathumma-llm-text-1.0.0 | 55.02 | 51.32 | 83 | 77.77 | 40.11 | 41.29 | 16.9286253 | 26.54 | 51.88 | 41.28 | 60.54 | 53.17 | 34.16 |
| Openthaigpt1.5-7b-instruct | 54.01 | 52.04 | 85.4 | 79.44 | 39.7 | 50.24 | 18.11 | 29.09 | 29.58 | 32.49 | 63.70 | 53.03 | 27.32 |
| SeaLLMs-v3-7B-Chat | 51.43 | 51.33 | 83.4 | 78.22 | 34.05 | 39.57 | 20.27 | 32.91 | 28.8 | 48.12 | 58.81 | 51.38 | 32.53 |
| llama-3-typhoon-v1.5-8B | 43.82 | 41.95 | 81.6 | 71.89 | 33.35 | 38.45 | 16.66 | 31.94 | 28.86 | 54.78 | 56.32 | 42.89 | 33.06 |
| Meta-Llama-3.1-8B-Instruct | 45.11 | 43.89 | 73.4 | 74.89 | 33.49 | 45.45 | 21.61 | 30.45 | 32.28 | 68.57 | 56.81 | 44.50 | 38.23 |
Contributor Contract
LLM Team
Pakawat Phasook (pakawat.phas@kmutt.ac.th)
Jessada Pranee (jessada.pran@kmutt.ac.th)
Arnon Saeoung (anon.saeoueng@gmail.com)
Kun Kerdthaisong (kun.ker@dome.tu.ac.th)
Kittisak Sukhantharat (kittisak.suk@stu.nida.ac.th)
Piyawat Chuangkrud (piyawat@it.kmitl.ac.th)
Chaianun Damrongrat (chaianun.damrongrat@nectec.or.th)
Sarawoot Kongyoung (sarawoot.kongyoung@nectec.or.th)
Audio Team
Pattara Tipaksorn (pattara.tip@ncr.nstda.or.th)
Wayupuk Sommuang (wayupuk.som@dome.tu.ac.th)
Oatsada Chatthong (atsada.cha@dome.tu.ac.th)
Kwanchiva Thangthai (kwanchiva.thangthai@nectec.or.th)
Vision Team
Thirawarit Pitiphiphat (60010474@kmitl.ac.th)
Peerapas Ngokpon (jamesselmon78169@gmail.com)
Theerasit Issaranon (theerasit.issaranon@nectec.or.th)
Citation
If you find our work helpful, feel free to give us a cite.
@misc{qwen2.5,
    title = {Qwen2.5: A Party of Foundation Models},
    url = {https://qwenlm.github.io/blog/qwen2.5/},
    author = {Qwen Team},
    month = {September},
    year = {2024}
}

@article{qwen2,
      title={Qwen2 Technical Report},
      author={An Yang and Baosong Yang and Binyuan Hui and Bo Zheng and Bowen Yu and Chang Zhou and Chengpeng Li and Chengyuan Li and Dayiheng Liu and Fei Huang and Guanting Dong and Haoran Wei and Huan Lin and Jialong Tang and Jialin Wang and Jian Yang and Jianhong Tu and Jianwei Zhang and Jianxin Ma and Jin Xu and Jingren Zhou and Jinze Bai and Jinzheng He and Junyang Lin and Kai Dang and Keming Lu and Keqin Chen and Kexin Yang and Mei Li and Mingfeng Xue and Na Ni and Pei Zhang and Peng Wang and Ru Peng and Rui Men and Ruize Gao and Runji Lin and Shijie Wang and Shuai Bai and Sinan Tan and Tianhang Zhu and Tianhao Li and Tianyu Liu and Wenbin Ge and Xiaodong Deng and Xiaohuan Zhou and Xingzhang Ren and Xinyu Zhang and Xipin Wei and Xuancheng Ren and Yang Fan and Yang Yao and Yichang Zhang and Yu Wan and Yunfei Chu and Yuqiong Liu and Zeyu Cui and Zhenru Zhang and Zhihao Fan},
      journal={arXiv preprint arXiv:2407.10671},
      year={2024}
}