/ Модель

Характеристики

Лицензия
CreativeML OpenRAIL-M
Опубликована
20 окт 2022

archer-diffusion

Генерация изображенийТекст → изображение3 профессии

Дообученная на кадрах мультсериала «Арчер» модель Stable Diffusion для генерации изображений в его визуальной стилистике по текстовым запросам.

162скачиваний за 30 дней215лайковвеса обновлены16 мая 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Изображения» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели сгенерируют результат по каждой задаче. Опубликованный тест появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Archer Diffusion — модель генерации изображений от nitrosocke, полученная дообучением Stable Diffusion на кадрах мультсериала «Арчер». Для стилистического эффекта в запрос рекомендуется добавлять токен «archer style». Модель предназначена для создания портретов, пейзажей, животных и других изображений с визуальной стилистикой сериала; она работает как конвейер StableDiffusionPipeline из библиотеки Diffusers и выдаёт изображения по текстовому описанию.

Модель обучена методом DreamBooth с сохранением исходного распределения и дообучением текстового энкодера в течение 4000 шагов. Репозиторий содержит веса в форматах Diffusers и PyTorch. Лицензия — CreativeML OpenRAIL-M; ограничения лицензии следует учитывать при использовании и распространении сгенерированных материалов.

Сценарии применения

  • создание портретов в стилистике мультсериала «Арчер»
  • генерация пейзажей в стиле «Арчера»
  • создание изображений животных в мультяшной стилистике сериала
  • иллюстрирование персонажей и сцен по текстовому описанию

Ограничения

Модель специализируется на визуальной стилистике «Арчера», а для её включения рекомендуется использовать токен «archer style». README не приводит количественных оценок качества или подробных ограничений генерации.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Archer Diffusion

This is the fine-tuned Stable Diffusion model trained on screenshots from the TV-show Archer. Use the tokens archer style in your prompts for the effect.

If you enjoy my work, please consider supporting me Become A Patreon

🧨 Diffusers

This model can be used just like any other Stable Diffusion model. For more information, please have a look at the Stable Diffusion.

You can also export the model to ONNX, MPS and/or FLAX/JAX.

#!pip install diffusers transformers scipy torch
from diffusers import StableDiffusionPipeline
import torch

model_id = "nitrosocke/archer-diffusion"
pipe = StableDiffusionPipeline.from_pretrained(model_id, torch_dtype=torch.float16)
pipe = pipe.to("cuda")

prompt = "a magical princess with golden hair, archer style"
image = pipe(prompt).images[0]

image.save("./magical_princess.png")

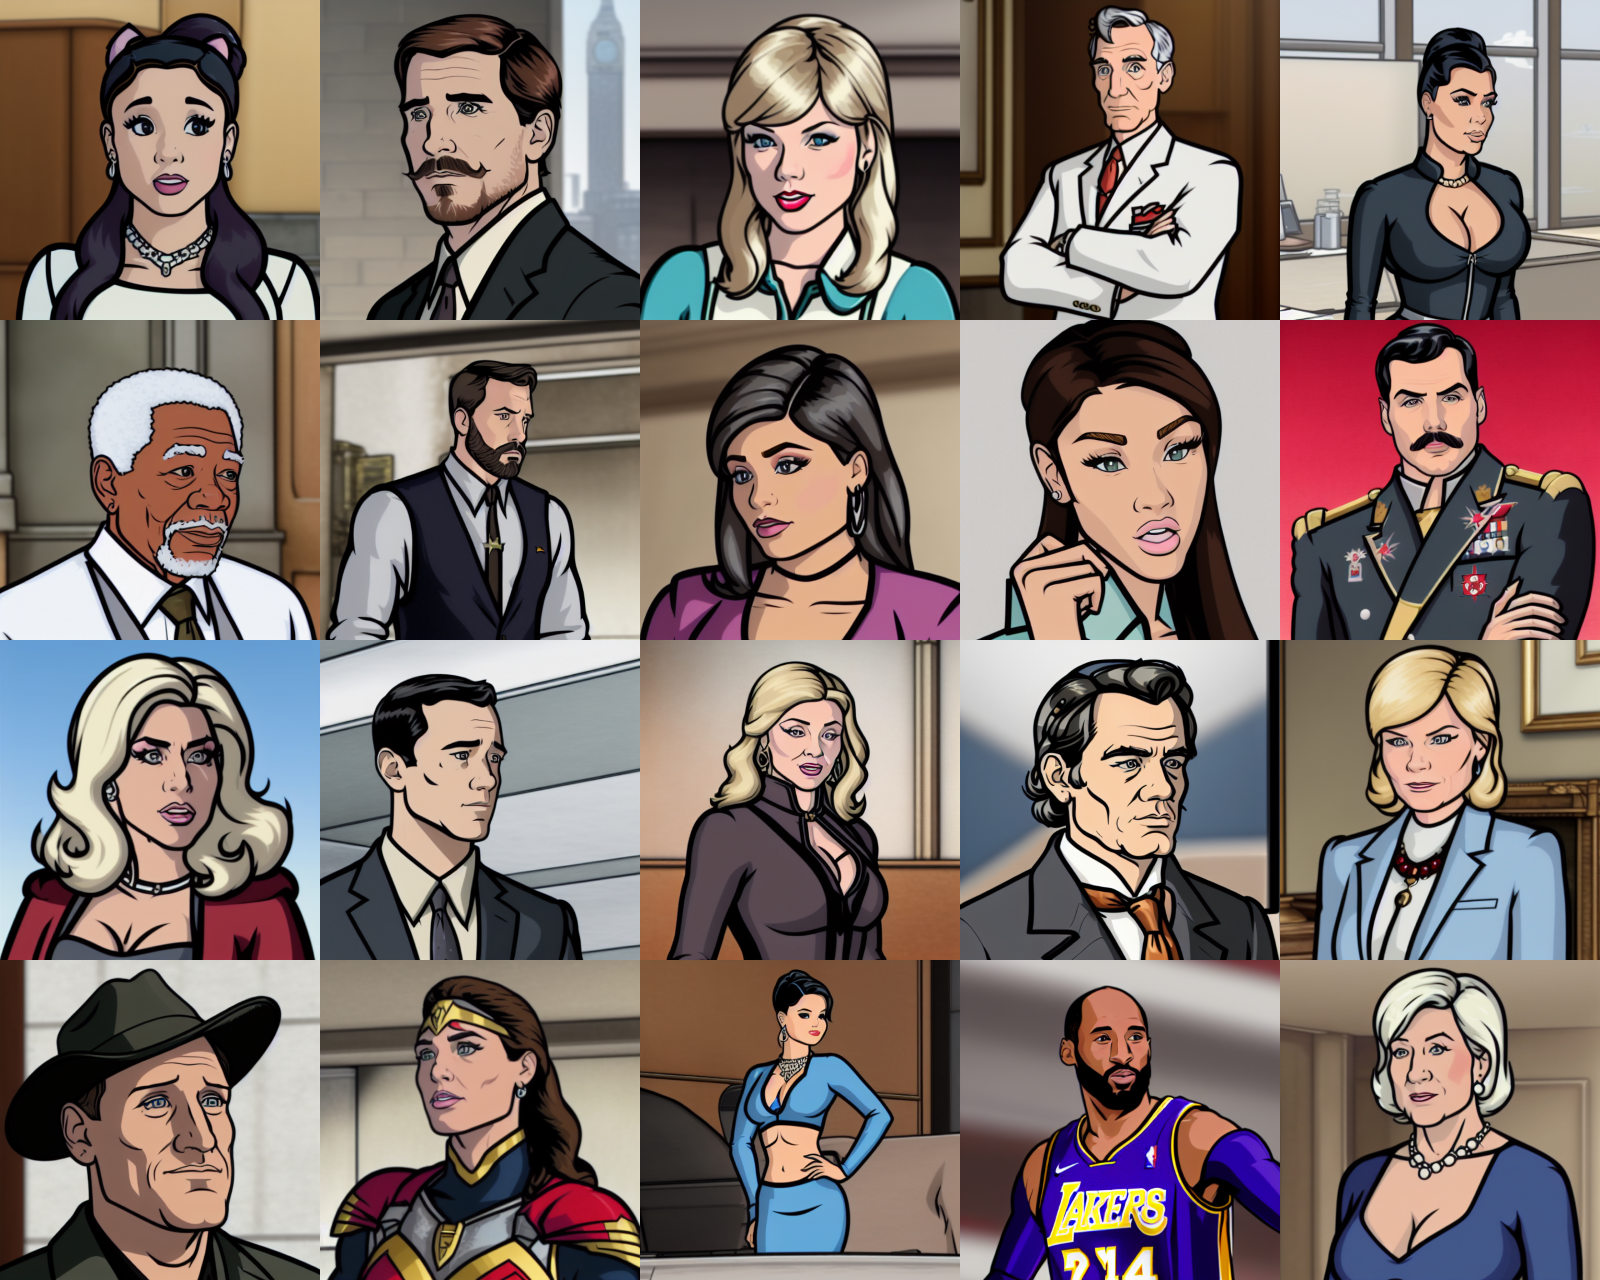
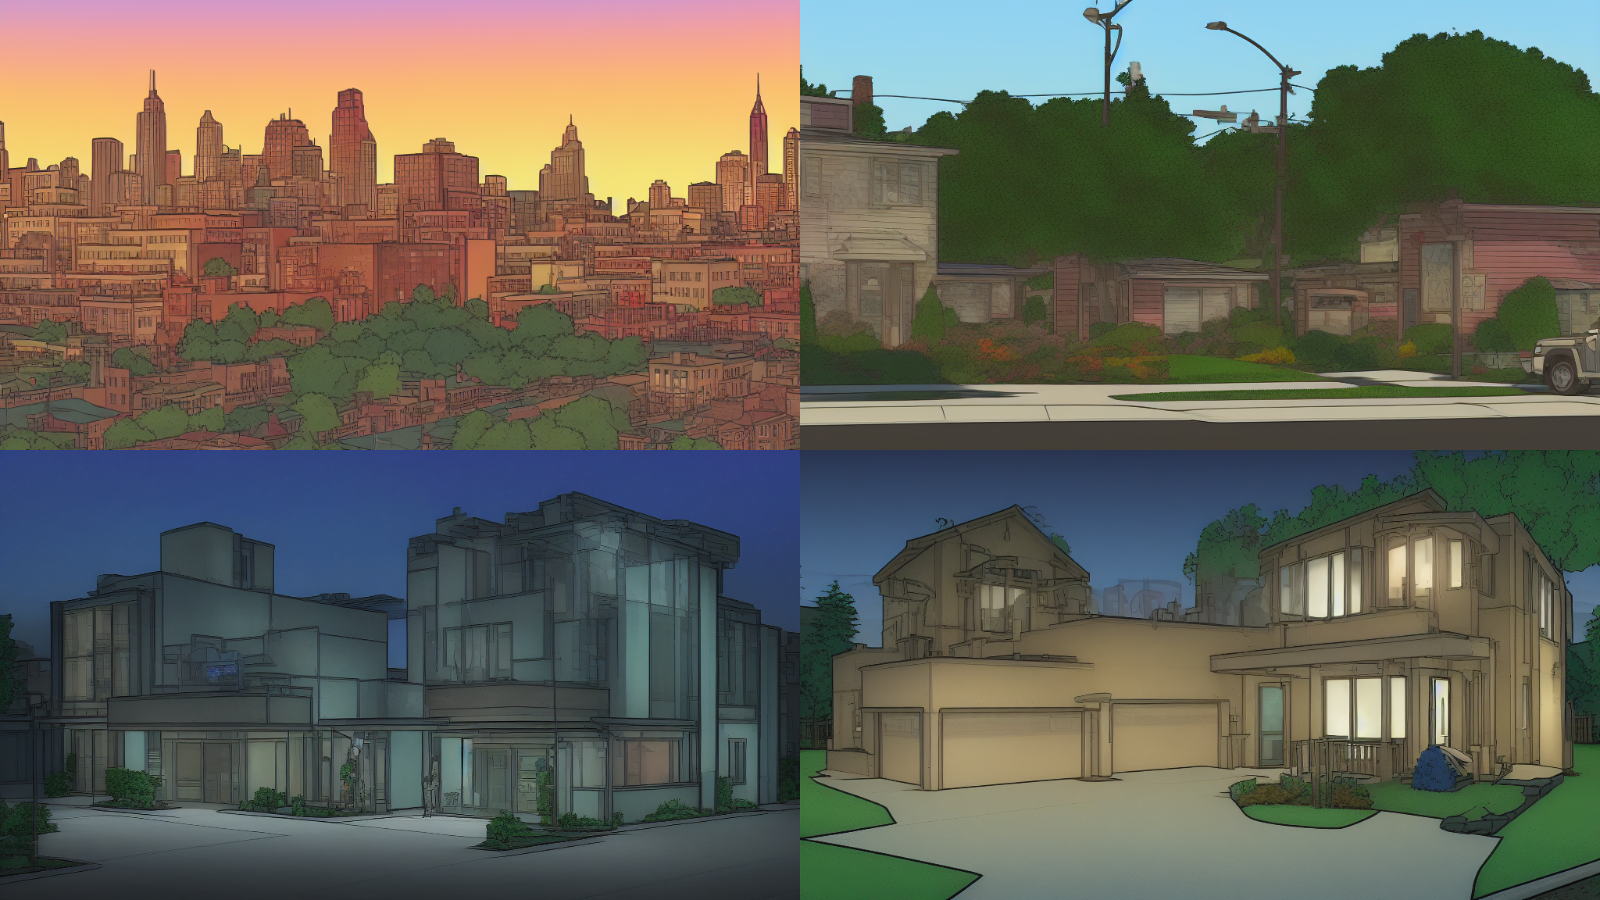
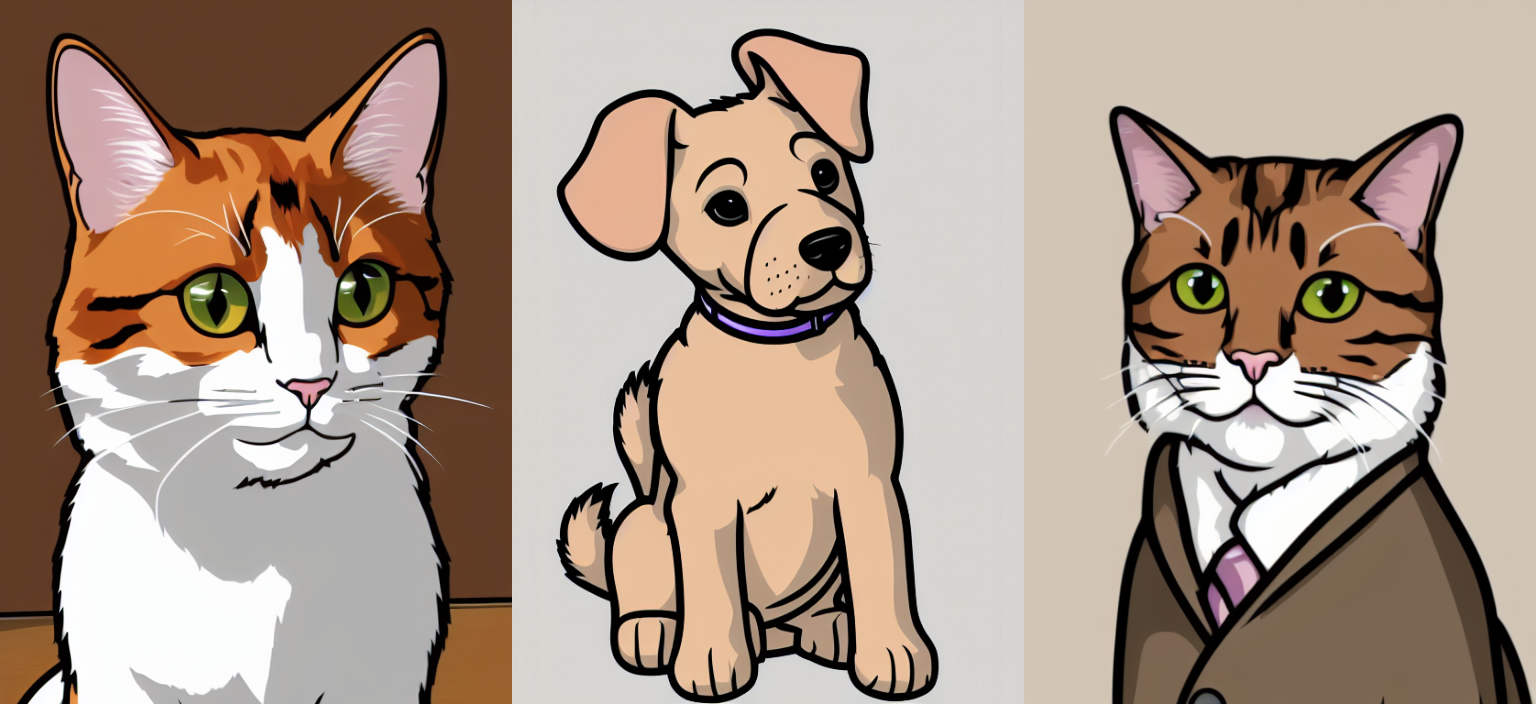
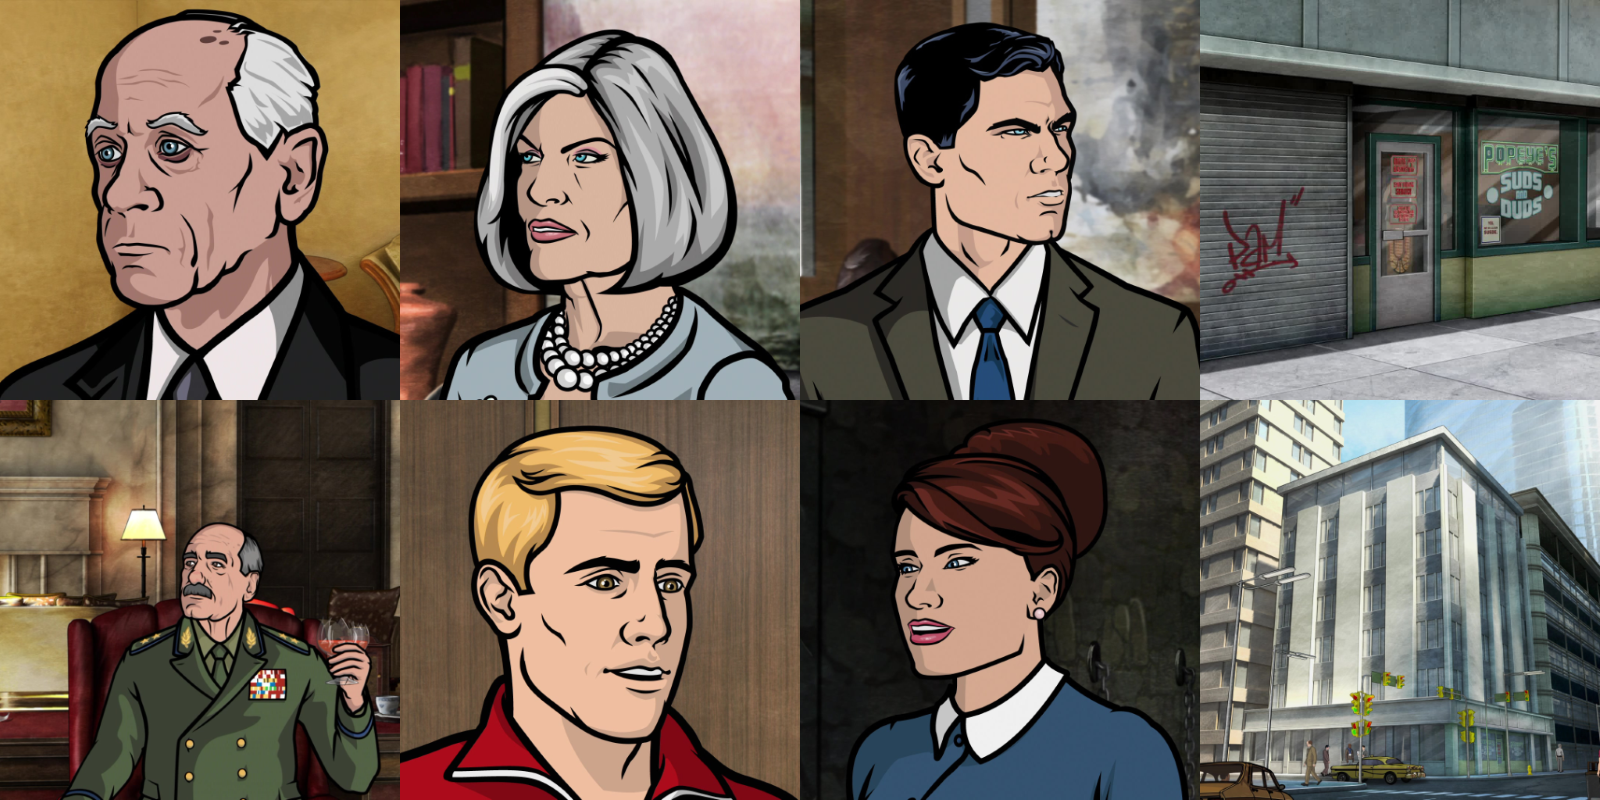
Portraits rendered with the model: Portrait Samples Celebrities rendered with the model: Celebrities Samples Landscapes rendered with the model: Landscape Samples Animals rendered with the model: Animal Samples Sample images used for training: Training Samples
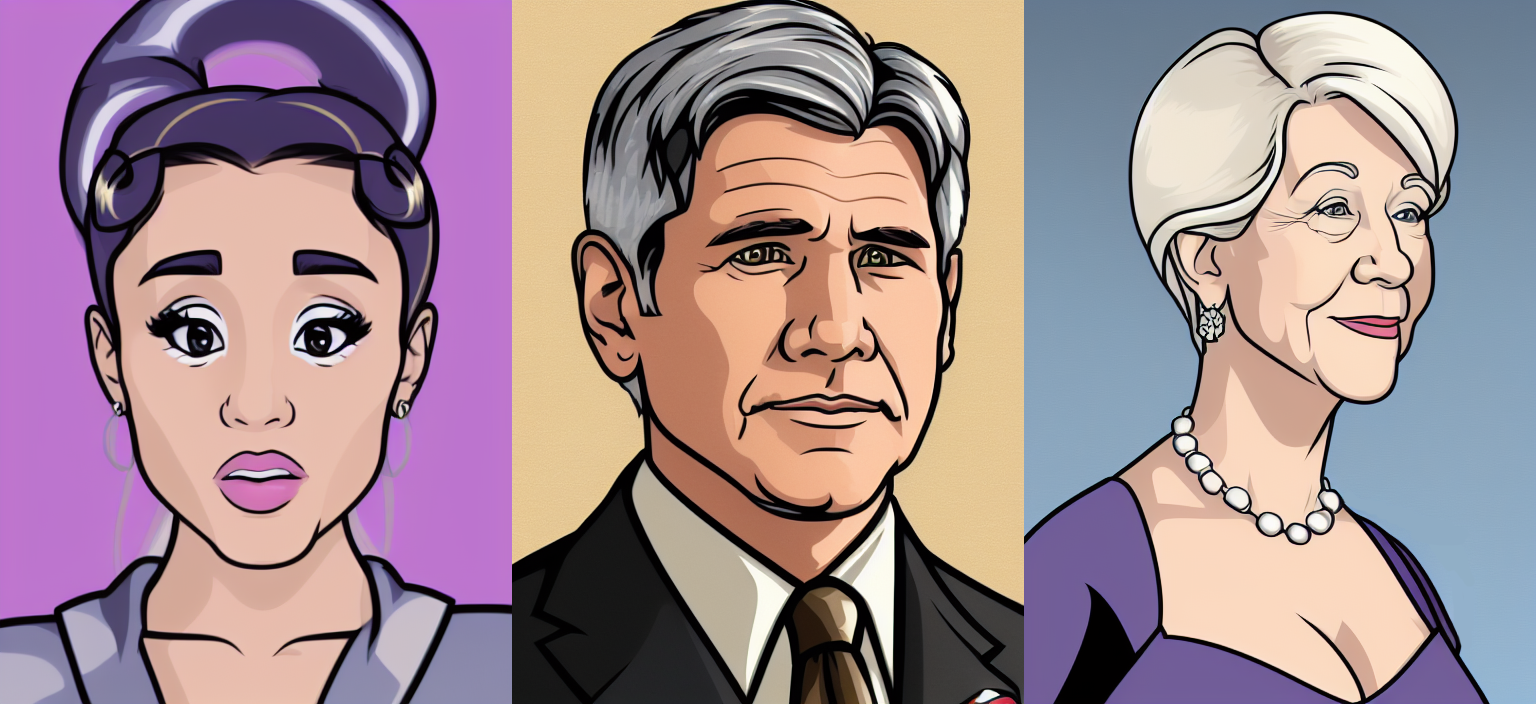
Prompt and settings for portraits:

archer style beautiful portrait of ariana grande Steps: 20, Sampler: Euler a, CFG scale: 7, Seed: 946707299, Size: 512x704

Prompt and settings for landscapes:

archer style suburban street night blue indoor lighting Negative prompt: grey cars Steps: 20, Sampler: Euler a, CFG scale: 7, Seed: 2915669764, Size: 1024x576

This model was trained using the diffusers based dreambooth training and prior-preservation loss in 4.000 steps and using the train-text-encoder feature.

License

This model is open access and available to all, with a CreativeML OpenRAIL-M license further specifying rights and usage. The CreativeML OpenRAIL License specifies:

  1. You can't use the model to deliberately produce nor share illegal or harmful outputs or content
  2. The authors claims no rights on the outputs you generate, you are free to use them and are accountable for their use which must not go against the provisions set in the license
  3. You may re-distribute the weights and use the model commercially and/or as a service. If you do, please be aware you have to include the same use restrictions as the ones in the license and share a copy of the CreativeML OpenRAIL-M to all your users (please read the license entirely and carefully) Please read the full license here

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Ревизия весов
e8c782c

0 моделей