/ Модель

Характеристики

Лицензия
CreativeML OpenRAIL-M
Опубликована
27 окт 2022

mo-di-diffusion

Генерация изображенийТекст → изображение3 профессии

Дообученная версия Stable Diffusion 1.5 для генерации изображений в современном диснеевском анимационном стиле по текстовым запросам.

3 947скачиваний за 30 дней960лайковвеса обновлены16 мая 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Изображения» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели сгенерируют результат по каждой задаче. Опубликованный тест появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Mo Di Diffusion — дообученная на базе Stable Diffusion 1.5 модель генерации изображений в современном диснеевском анимационном стиле. Её разработал автор nitrosocke; для выраженного стиля в запрос рекомендуется включать фразу «modern disney style». Модель обучали методом DreamBooth с сохранением prior и дообучением текстового энкодера в течение 9 000 шагов на скриншотах анимационной студии.

Модель предназначена для создания изображений персонажей видеоигр, животных, автомобилей и пейзажей по текстовым описаниям. Она использует конвейер Stable Diffusion и доступна в форматах Diffusers и PyTorch; пример в карточке генерирует изображение размером 512 × 512 или 512 × 768. Для запуска подходит библиотека Diffusers. Лицензия — CreativeML OpenRAIL-M, условия которой следует учитывать при использовании и распространении модели.

Сценарии применения

  • создание персонажей видеоигр в диснеевском стиле
  • генерация мультяшных животных по описанию
  • создание изображений автомобилей и пейзажей
  • иллюстрации сказочных персонажей и сцен
  • стилизация текстовых концептов под современную анимацию

Ограничения

Для получения характерного стиля карточка рекомендует добавлять в запрос «modern disney style». Качество зависит от формулировки запроса; карточка не приводит систематических оценок качества или ограничений.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Mo Di Diffusion

This is the fine-tuned Stable Diffusion 1.5 model trained on screenshots from a popular animation studio. Use the tokens modern disney style in your prompts for the effect.

If you enjoy my work, please consider supporting me Become A Patreon

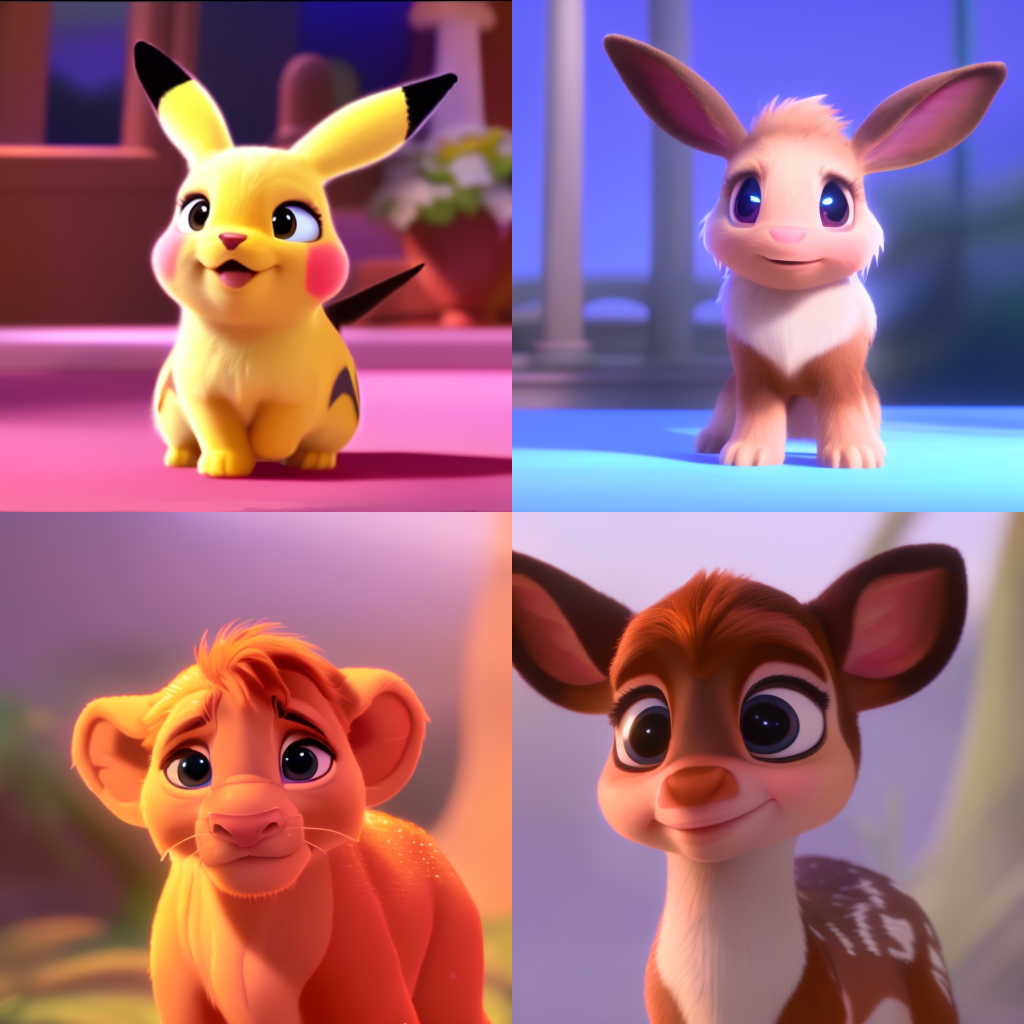
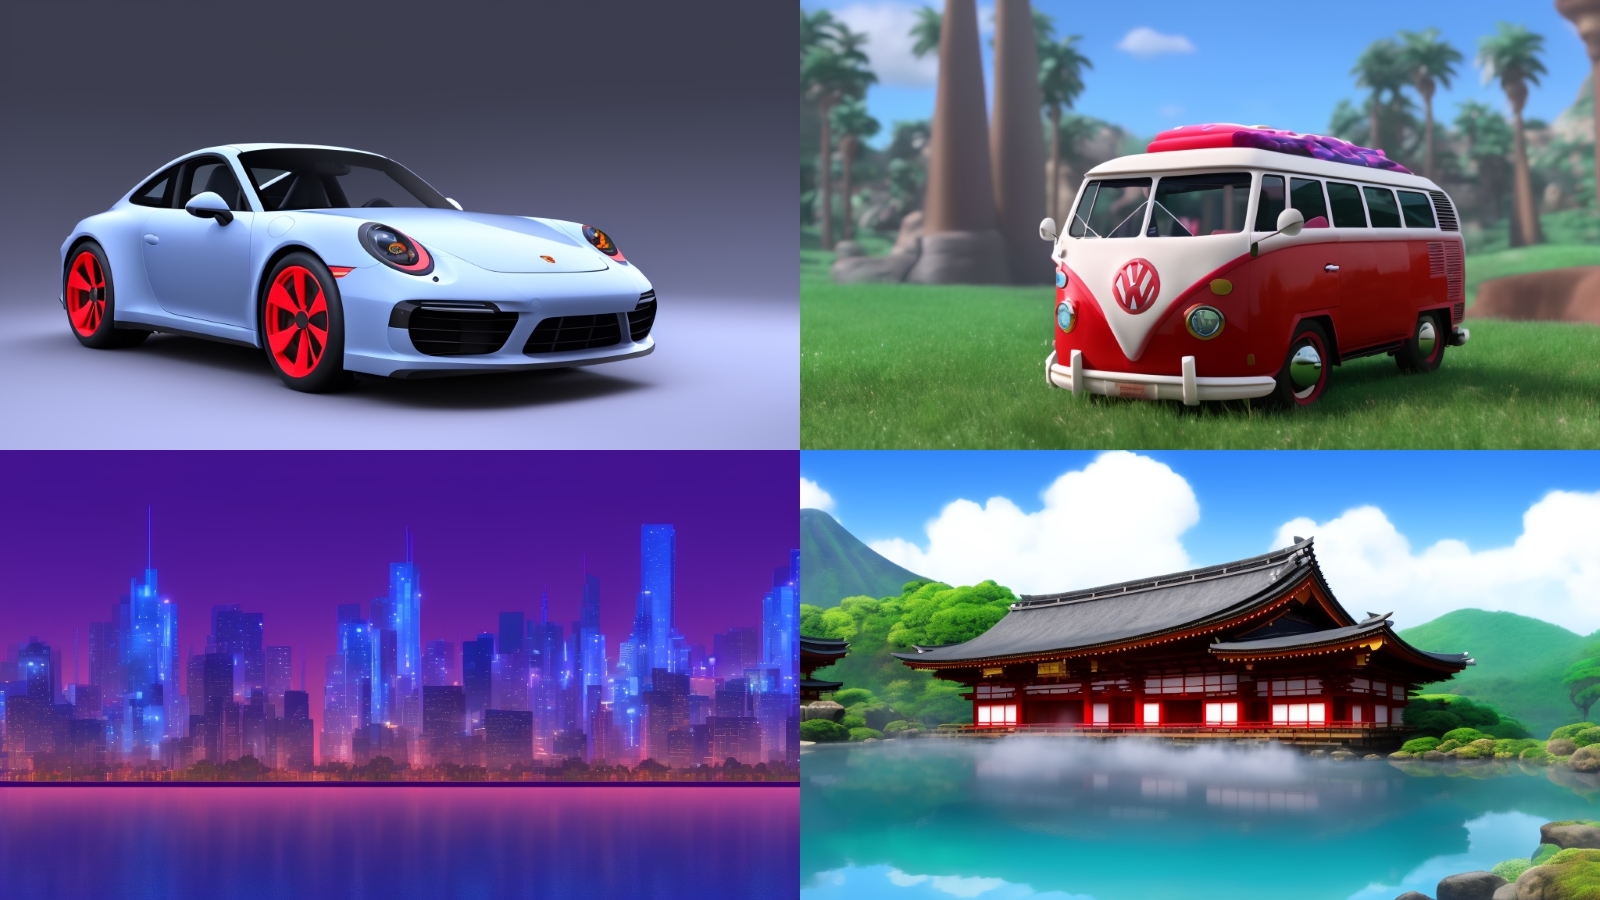
Videogame Characters rendered with the model: Videogame Samples Animal Characters rendered with the model: Animal Samples Cars and Landscapes rendered with the model: Misc. Samples
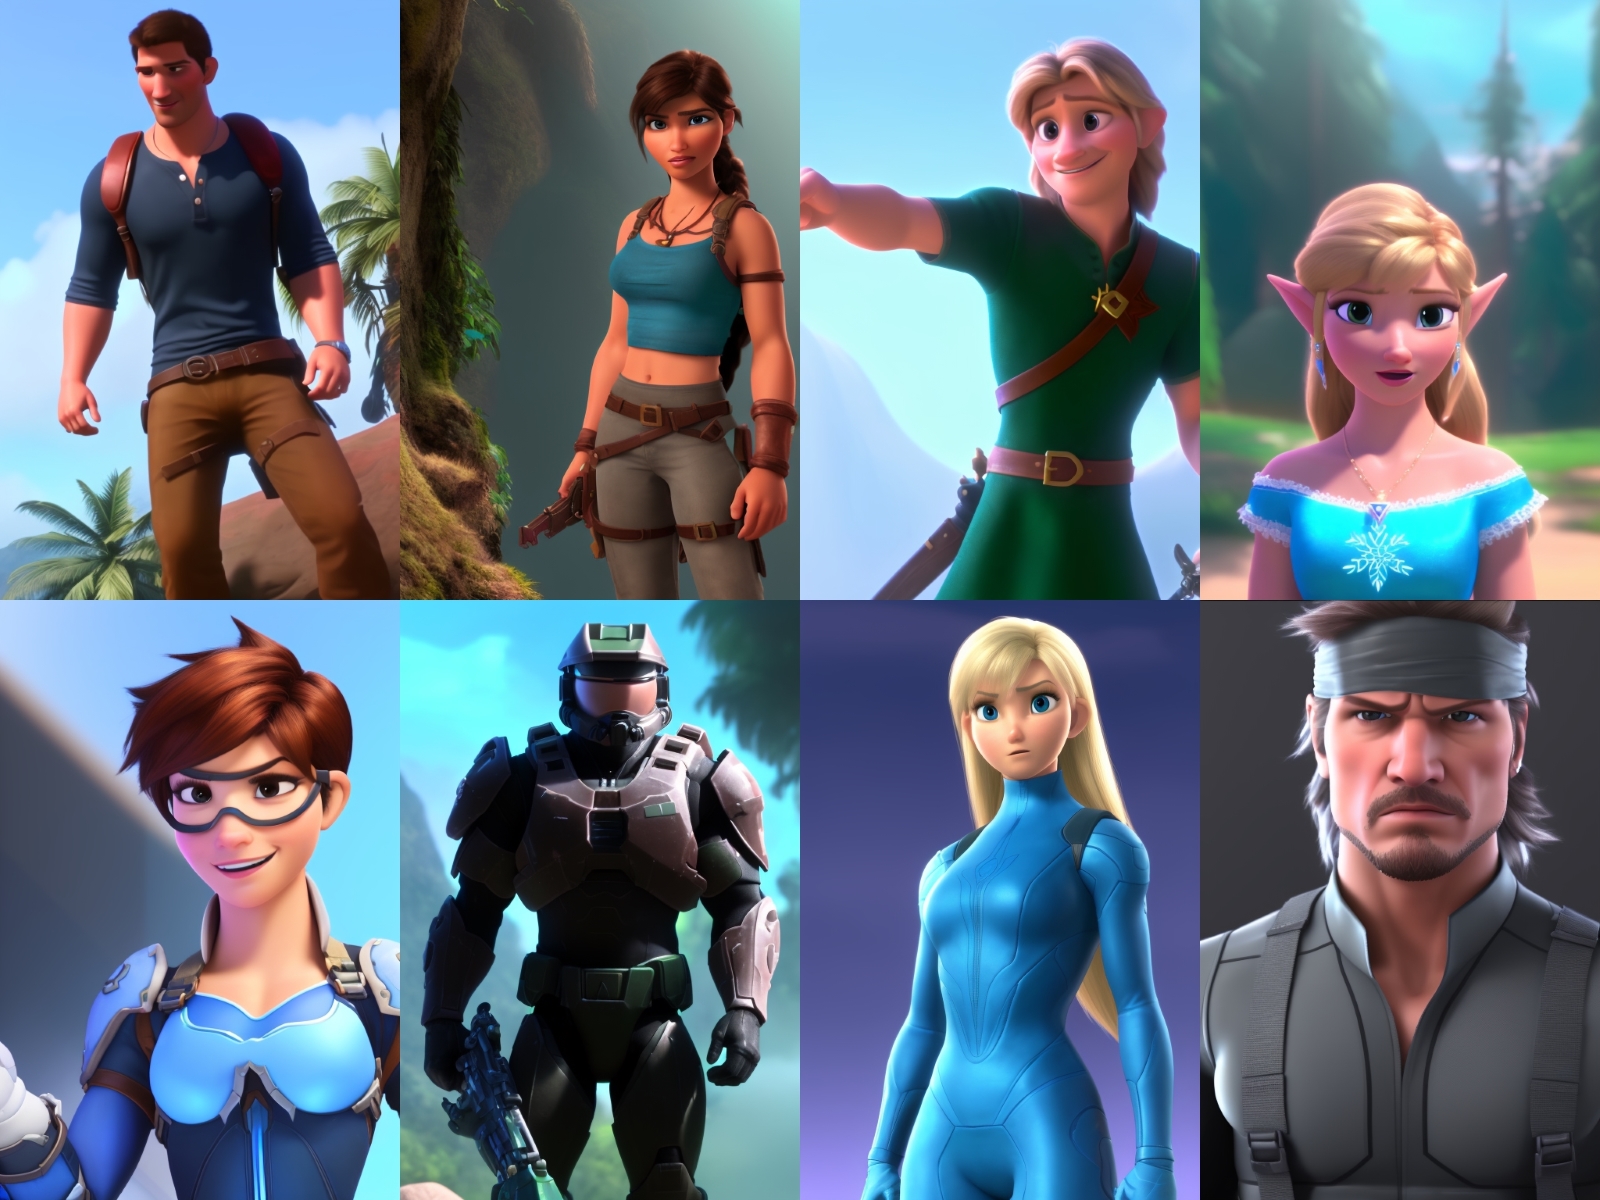
Prompt and settings for Lara Croft:

modern disney lara croft Steps: 50, Sampler: Euler a, CFG scale: 7, Seed: 3940025417, Size: 512x768

Prompt and settings for the Lion:

modern disney (baby lion) Negative prompt: person human Steps: 50, Sampler: Euler a, CFG scale: 7, Seed: 1355059992, Size: 512x512

This model was trained using the diffusers based dreambooth training by ShivamShrirao using prior-preservation loss and the train-text-encoder flag in 9.000 steps.

🧨 Diffusers

This model can be used just like any other Stable Diffusion model. For more information, please have a look at the Stable Diffusion.

You can also export the model to ONNX, MPS and/or FLAX/JAX.

from diffusers import StableDiffusionPipeline
import torch

model_id = "nitrosocke/mo-di-diffusion"
pipe = StableDiffusionPipeline.from_pretrained(model_id, torch_dtype=torch.float16)
pipe = pipe.to("cuda")

prompt = "a magical princess with golden hair, modern disney style"
image = pipe(prompt).images[0]

image.save("./magical_princess.png")

Gradio & Colab

We also support a Gradio Web UI and Colab with Diffusers to run fine-tuned Stable Diffusion models: Open In Spaces Open In Colab

License

This model is open access and available to all, with a CreativeML OpenRAIL-M license further specifying rights and usage. The CreativeML OpenRAIL License specifies:

  1. You can't use the model to deliberately produce nor share illegal or harmful outputs or content
  2. The authors claims no rights on the outputs you generate, you are free to use them and are accountable for their use which must not go against the provisions set in the license
  3. You may re-distribute the weights and use the model commercially and/or as a service. If you do, please be aware you have to include the same use restrictions as the ones in the license and share a copy of the CreativeML OpenRAIL-M to all your users (please read the license entirely and carefully) Please read the full license here

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Ревизия весов
e3106d2

0 моделей