/ Модель

Характеристики

Контекст
1 024 токена
Лицензия
Apache 2.0
Архитектура
vision-encoder-decoder · dense
Опубликована
2 мар 2022

vit-gpt2-image-captioning

Описание изображенийИзображение → текст7 профессий

Модель анализирует изображение и генерирует его текстовое описание с помощью архитектуры VisionEncoderDecoder с GPT-2.

86 691скачиваний за 30 дней940лайковвеса обновлены27 фев 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Распознавание текста» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

nlpconnect/vit-gpt2-image-captioning — модель для автоматического создания текстовых описаний изображений. Она разработана на основе VisionEncoderDecoderModel: визуальный энкодер анализирует изображение, а декодер GPT-2 формирует подпись. Репозиторий содержит версию PyTorch модели, первоначально обученной ydshieh во Flax.

Модель предназначена для генерации кратких описаний содержимого изображения. Её можно использовать в конвейере Transformers image-to-text для автоматического добавления подписей к изображениям и их текстовой индексации. В карточке не приведены сведения о поддерживаемых естественных языках, размере модели и длине контекста.

Модель распространяется по лицензии Apache-2.0. Карточка не сообщает об оценках качества или специальных ограничениях применимости; качество описаний может зависеть от изображения и обучающих данных.

Сценарии применения

  • автоматическое создание подписей к изображениям
  • генерация краткого описания фотографии
  • добавление текстовых описаний к архиву изображений
  • индексация изображений по сгенерированным подписям

Ограничения

В карточке не приведены оценки качества и сведения о поддерживаемых языках; точность описаний зависит от изображения и обучающих данных.

Для каких профессий подходит7

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

nlpconnect/vit-gpt2-image-captioning

This is an image captioning model trained by @ydshieh in flax this is pytorch version of this.

The Illustrated Image Captioning using transformers
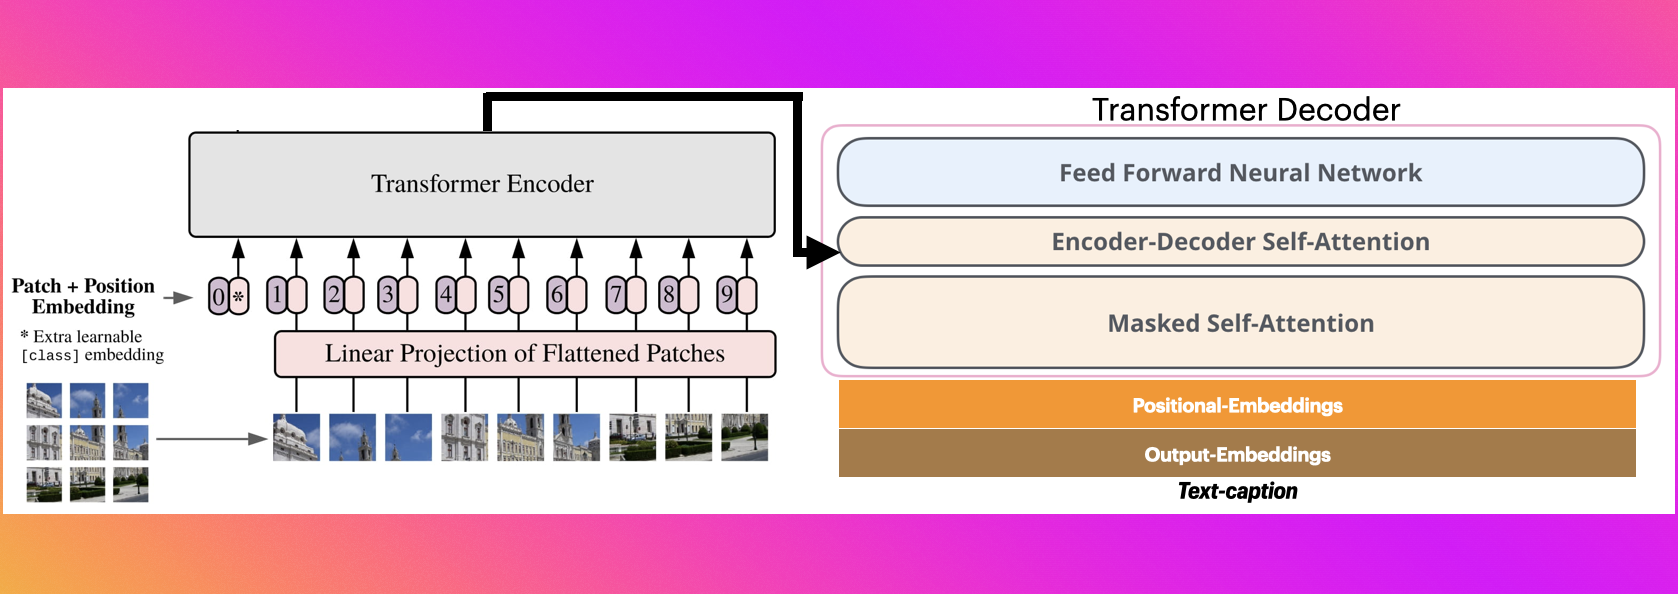
Sample running code


from transformers import VisionEncoderDecoderModel, ViTImageProcessor, AutoTokenizer
import torch
from PIL import Image

model = VisionEncoderDecoderModel.from_pretrained("nlpconnect/vit-gpt2-image-captioning")
feature_extractor = ViTImageProcessor.from_pretrained("nlpconnect/vit-gpt2-image-captioning")
tokenizer = AutoTokenizer.from_pretrained("nlpconnect/vit-gpt2-image-captioning")

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model.to(device)


max_length = 16
num_beams = 4
gen_kwargs = {"max_length": max_length, "num_beams": num_beams}
def predict_step(image_paths):
  images = []
  for image_path in image_paths:
    i_image = Image.open(image_path)
    if i_image.mode != "RGB":
      i_image = i_image.convert(mode="RGB")

    images.append(i_image)

  pixel_values = feature_extractor(images=images, return_tensors="pt").pixel_values
  pixel_values = pixel_values.to(device)

  output_ids = model.generate(pixel_values, **gen_kwargs)

  preds = tokenizer.batch_decode(output_ids, skip_special_tokens=True)
  preds = [pred.strip() for pred in preds]
  return preds


predict_step(['doctor.e16ba4e4.jpg']) # ['a woman in a hospital bed with a woman in a hospital bed']

Sample running code using transformers pipeline


from transformers import pipeline

image_to_text = pipeline("image-to-text", model="nlpconnect/vit-gpt2-image-captioning")

image_to_text("https://ankur3107.github.io/assets/images/image-captioning-example.png")

# [{'generated_text': 'a soccer game with a player jumping to catch the ball '}]


Contact for any help

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
VisionEncoderDecoderModel
Ревизия весов
dc68f91

0 моделей