/ Модель

Характеристики

Контекст
8 192 токена
Параметры
137 млн
Лицензия
Apache 2.0
Архитектура
nomic_bert · dense
Библиотека
sentence-transformers
Опубликована
31 янв 2024

nomic-embed-text-v1

ЭмбеддингиТекст → embedding11 профессий

Текстовый энкодер Nomic AI, который строит векторные представления английских текстов для семантического поиска, RAG, кластеризации и классификации.

2,5 млнскачиваний за 30 дней590лайковвеса обновлены7 апр 2026

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Эмбеддинги» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки36

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

  • LongMemEval

    main_score

    Результат

    0,7293

    MTEB

    Публичная таблицадругая ревизия

  • NusaXBitextMining

    main_score

    Результат

    0,3179

    MTEB

    Публичная таблицадругая ревизия

  • XNLI

    main_score

    Результат

    0,504

    Общий результат 0,612Общий результат 0,5883
    MTEB

    Публичная таблицадругая ревизия

  • SemRel24STS

    main_score

    Результат

    0,2936

    MTEB

    Публичная таблицадругая ревизия

  • KorSarcasmClassification

    main_score

    Результат

    0,5483

    MTEB

    Публичная таблицадругая ревизия

  • PawsXPairClassification

    main_score

    Результат

    0,5181

    MTEB

    Публичная таблицадругая ревизия

  • XQuADRetrieval

    main_score

    Результат

    0,6052

    MTEB

    Публичная таблицадругая ревизия

  • KnowMeBench

    main_score

    Результат

    0,364

    Общий результат 0,531Общий результат 0,2177
    MTEB

    Публичная таблицадругая ревизия

  • MasakhaNEWSClassification

    main_score

    Результат

    0,7022

    MTEB

    Публичная таблицадругая ревизия

  • MassiveIntentClassification

    main_score

    Результат

    0,4442

    MTEB

    Публичная таблицадругая ревизия

  • MLQARetrieval

    main_score

    Результат

    0,0499

    Общий результат 0,1722
    MTEB

    Публичная таблицадругая ревизия

  • MemBench

    main_score

    Результат

    0,8336

    MTEB

    Публичная таблицадругая ревизия

  • EPBench

    main_score

    Результат

    0,6097

    Общий результат 0,8011
    MTEB

    Публичная таблицадругая ревизия

  • OpusparcusPC

    main_score

    Результат

    0,8876

    MTEB

    Публичная таблицадругая ревизия

  • MassiveScenarioClassification

    main_score

    Результат

    0,4309

    Общий результат 0,1747
    MTEB

    Публичная таблицадругая ревизия

  • SIB200ClusteringS2S

    main_score

    Результат

    0,0324

    Общий результат 0,1208Общий результат 0,1098Общий результат 0,096
    MTEB

    Публичная таблицадругая ревизия

  • MLSUMClusteringS2S

    main_score

    Результат

    0,4302

    MTEB

    Публичная таблицадругая ревизия

  • MintakaRetrieval

    main_score

    Результат

    0,1543

    MTEB

    Публичная таблицадругая ревизия

  • SummEvalFr

    main_score

    Результат

    0,3111

    MTEB

    Публичная таблицадругая ревизия

  • EstonianValenceClassification

    main_score

    Результат

    0,2991

    MTEB

    Публичная таблицадругая ревизия

  • IndicGenBenchFloresBitextMining

    main_score

    Результат

    0,0236

    Общий результат 0,0623
    MTEB

    Публичная таблицадругая ревизия

  • SlovakMovieReviewSentimentClassification

    main_score

    Результат

    0,5654

    MTEB

    Публичная таблицадругая ревизия

  • MIRACLRetrievalHardNegatives

    main_score

    Результат

    0,0141

    Общий результат 0,2118
    MTEB

    Публичная таблицадругая ревизия

  • WikiClusteringP2P.v2

    main_score

    Результат

    0,1708

    MTEB

    Публичная таблицадругая ревизия

  • CodeTransOceanDL

    main_score

    Результат

    0,2066

    MTEB

    Публичная таблицадругая ревизия

  • STS22

    main_score

    Результат

    0,4619

    MTEB

    Публичная таблицадругая ревизия

  • WikipediaRetrievalMultilingual

    main_score

    Результат

    0,7032

    MTEB

    Публичная таблицадругая ревизия

  • CUREv1

    main_score

    Результат

    0,2519

    MTEB

    Публичная таблицадругая ревизия

  • MultiHateClassification

    main_score

    Результат

    0,6371

    MTEB

    Публичная таблицадругая ревизия

  • CQADupstackPhysicsRetrieval

    main_score

    Результат

    0,4588

    MTEB

    Публичная таблицадругая ревизия

  • MIRACLRetrieval

    main_score

    Результат

    0,0135

    MTEB

    Публичная таблицадругая ревизия

  • AlloprofReranking

    main_score

    Результат

    0,6247

    MTEB

    Публичная таблицадругая ревизия

  • LccSentimentClassification

    main_score

    Результат

    0,3853

    MTEB

    Публичная таблицадругая ревизия

  • ReMe

    main_score

    Результат

    0,5729

    MTEB

    Публичная таблицадругая ревизия

  • InappropriatenessClassification

    main_score

    Результат

    0,5192

    MTEB

    Публичная таблицадругая ревизия

  • PubChemWikiPairClassification

    main_score

    Результат

    0,9097

    MTEB

    Публичная таблицадругая ревизия

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

nomic-embed-text-v1 — текстовый энкодер эмбеддингов, разработанный Nomic AI на архитектуре NomicBert. Модель содержит 136,7 млн параметров, принимает до 8192 токенов и предназначена для преобразования текстов в векторы для поиска и сравнения по смыслу.

Модель используют для построения RAG-индексов, поиска по запросам, группировки текстов, выявления тем и семантических дубликатов, а также получения признаков для классификации. Для разных задач в начале текста требуется соответствующий префикс-инструкция. В README заявлены результаты на MTEB, LoCo и тесте Jina Long Context; доступность открытых весов и кода обучения также отмечена в карточке.

Модель работает с английским языком. Доступны форматы PyTorch, Safetensors и ONNX; библиотека карточки — Sentence Transformers. Лицензия — Apache-2.0. Несмотря на упоминание мультимодального пространства эмбеддингов в README, сама модель принимает текст; для изображений указан отдельный согласованный энкодер nomic-embed-vision-v1.

Сценарии применения

  • создание эмбеддингов документов для RAG-индекса
  • поиск документов по текстовому запросу
  • группировка текстов по смыслу и темам
  • поиск семантических дубликатов
  • подготовка векторных признаков для классификации

Ограничения

Для корректной работы перед текстом требуется префикс-инструкция, соответствующий задаче. Англоязычная модель; для обработки изображений README указывает отдельный энкодер nomic-embed-vision-v1.

Для каких профессий подходит11

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

nomic-embed-text-v1: A Reproducible Long Context (8192) Text Embedder

Blog | Technical Report | AWS SageMaker | Atlas Embedding and Unstructured Data Analytics Platform

nomic-embed-text-v1 is 8192 context length text encoder that surpasses OpenAI text-embedding-ada-002 and text-embedding-3-small performance on short and long context tasks.

Performance Benchmarks

NameSeqLenMTEBLoCoJina Long ContextOpen WeightsOpen Training CodeOpen Data
nomic-embed-text-v1819262.3985.5354.16✅✅✅
jina-embeddings-v2-base-en819260.3985.4551.90✅❌❌
text-embedding-3-small819162.2682.4058.20❌❌❌
text-embedding-ada-002819160.9952.755.25❌❌❌

Exciting Update!: nomic-embed-text-v1 is now multimodal! nomic-embed-vision-v1 is aligned to the embedding space of nomic-embed-text-v1, meaning any text embedding is multimodal!

Usage

Important: the text prompt must include a task instruction prefix, instructing the model which task is being performed.

For example, if you are implementing a RAG application, you embed your documents as search_document: <text here> and embed your user queries as search_query: <text here>.

Notice: From transformers v5.5.0 and sentence transformers v5.3.0, trust_remote_code=True will no longer be necessary. This will only be possible with the text-only series as of now.

Task instruction prefixes

search_document

Purpose: embed texts as documents from a dataset

This prefix is used for embedding texts as documents, for example as documents for a RAG index.

from sentence_transformers import SentenceTransformer

model = SentenceTransformer("nomic-ai/nomic-embed-text-v1")
sentences = ['search_document: TSNE is a dimensionality reduction algorithm created by Laurens van Der Maaten']
embeddings = model.encode(sentences)
print(embeddings)

search_query

Purpose: embed texts as questions to answer

This prefix is used for embedding texts as questions that documents from a dataset could resolve, for example as queries to be answered by a RAG application.

from sentence_transformers import SentenceTransformer

model = SentenceTransformer("nomic-ai/nomic-embed-text-v1")
sentences = ['search_query: Who is Laurens van Der Maaten?']
embeddings = model.encode(sentences)
print(embeddings)

clustering

Purpose: embed texts to group them into clusters

This prefix is used for embedding texts in order to group them into clusters, discover common topics, or remove semantic duplicates.

from sentence_transformers import SentenceTransformer

model = SentenceTransformer("nomic-ai/nomic-embed-text-v1")
sentences = ['clustering: the quick brown fox']
embeddings = model.encode(sentences)
print(embeddings)

classification

Purpose: embed texts to classify them

This prefix is used for embedding texts into vectors that will be used as features for a classification model

from sentence_transformers import SentenceTransformer

model = SentenceTransformer("nomic-ai/nomic-embed-text-v1")
sentences = ['classification: the quick brown fox']
embeddings = model.encode(sentences)
print(embeddings)

Sentence Transformers

from sentence_transformers import SentenceTransformer

model = SentenceTransformer("nomic-ai/nomic-embed-text-v1")
sentences = ['search_query: What is TSNE?', 'search_query: Who is Laurens van der Maaten?']
embeddings = model.encode(sentences)
print(embeddings)

Transformers

import torch
import torch.nn.functional as F
from transformers import AutoTokenizer, AutoModel

def mean_pooling(model_output, attention_mask):
    token_embeddings = model_output[0]
    input_mask_expanded = attention_mask.unsqueeze(-1).expand(token_embeddings.size()).float()
    return torch.sum(token_embeddings * input_mask_expanded, 1) / torch.clamp(input_mask_expanded.sum(1), min=1e-9)

sentences = ['search_query: What is TSNE?', 'search_query: Who is Laurens van der Maaten?']

tokenizer = AutoTokenizer.from_pretrained('bert-base-uncased')
model = AutoModel.from_pretrained('nomic-ai/nomic-embed-text-v1')
model.eval()

encoded_input = tokenizer(sentences, padding=True, truncation=True, return_tensors='pt')

with torch.no_grad():
    model_output = model(**encoded_input)

embeddings = mean_pooling(model_output, encoded_input['attention_mask'])
embeddings = F.normalize(embeddings, p=2, dim=1)
print(embeddings)

The model natively supports scaling of the sequence length past 2048 tokens. To do so,

- tokenizer = AutoTokenizer.from_pretrained('bert-base-uncased')
+ tokenizer = AutoTokenizer.from_pretrained('bert-base-uncased', model_max_length=8192)


- model = AutoModel.from_pretrained('nomic-ai/nomic-embed-text-v1')
+ rope_parameters = {"rope_theta": 1000.0, "rope_type": "dynamic", "factor": 2.0}
+ model = AutoModel.from_pretrained('nomic-ai/nomic-embed-text-v1', rope_parameters=rope_parameters)

Transformers.js

import { pipeline } from '@xenova/transformers';

// Create a feature extraction pipeline
const extractor = await pipeline('feature-extraction', 'nomic-ai/nomic-embed-text-v1', {
    quantized: false, // Comment out this line to use the quantized version
});

// Compute sentence embeddings
const texts = ['search_query: What is TSNE?', 'search_query: Who is Laurens van der Maaten?'];
const embeddings = await extractor(texts, { pooling: 'mean', normalize: true });
console.log(embeddings);

Nomic API

The easiest way to get started with Nomic Embed is through the Nomic Embedding API.

Generating embeddings with the nomic Python client is as easy as

from nomic import embed

output = embed.text(
    texts=['Nomic Embedding API', '#keepAIOpen'],
    model='nomic-embed-text-v1',
    task_type='search_document'
)

print(output)

For more information, see the API reference

Training

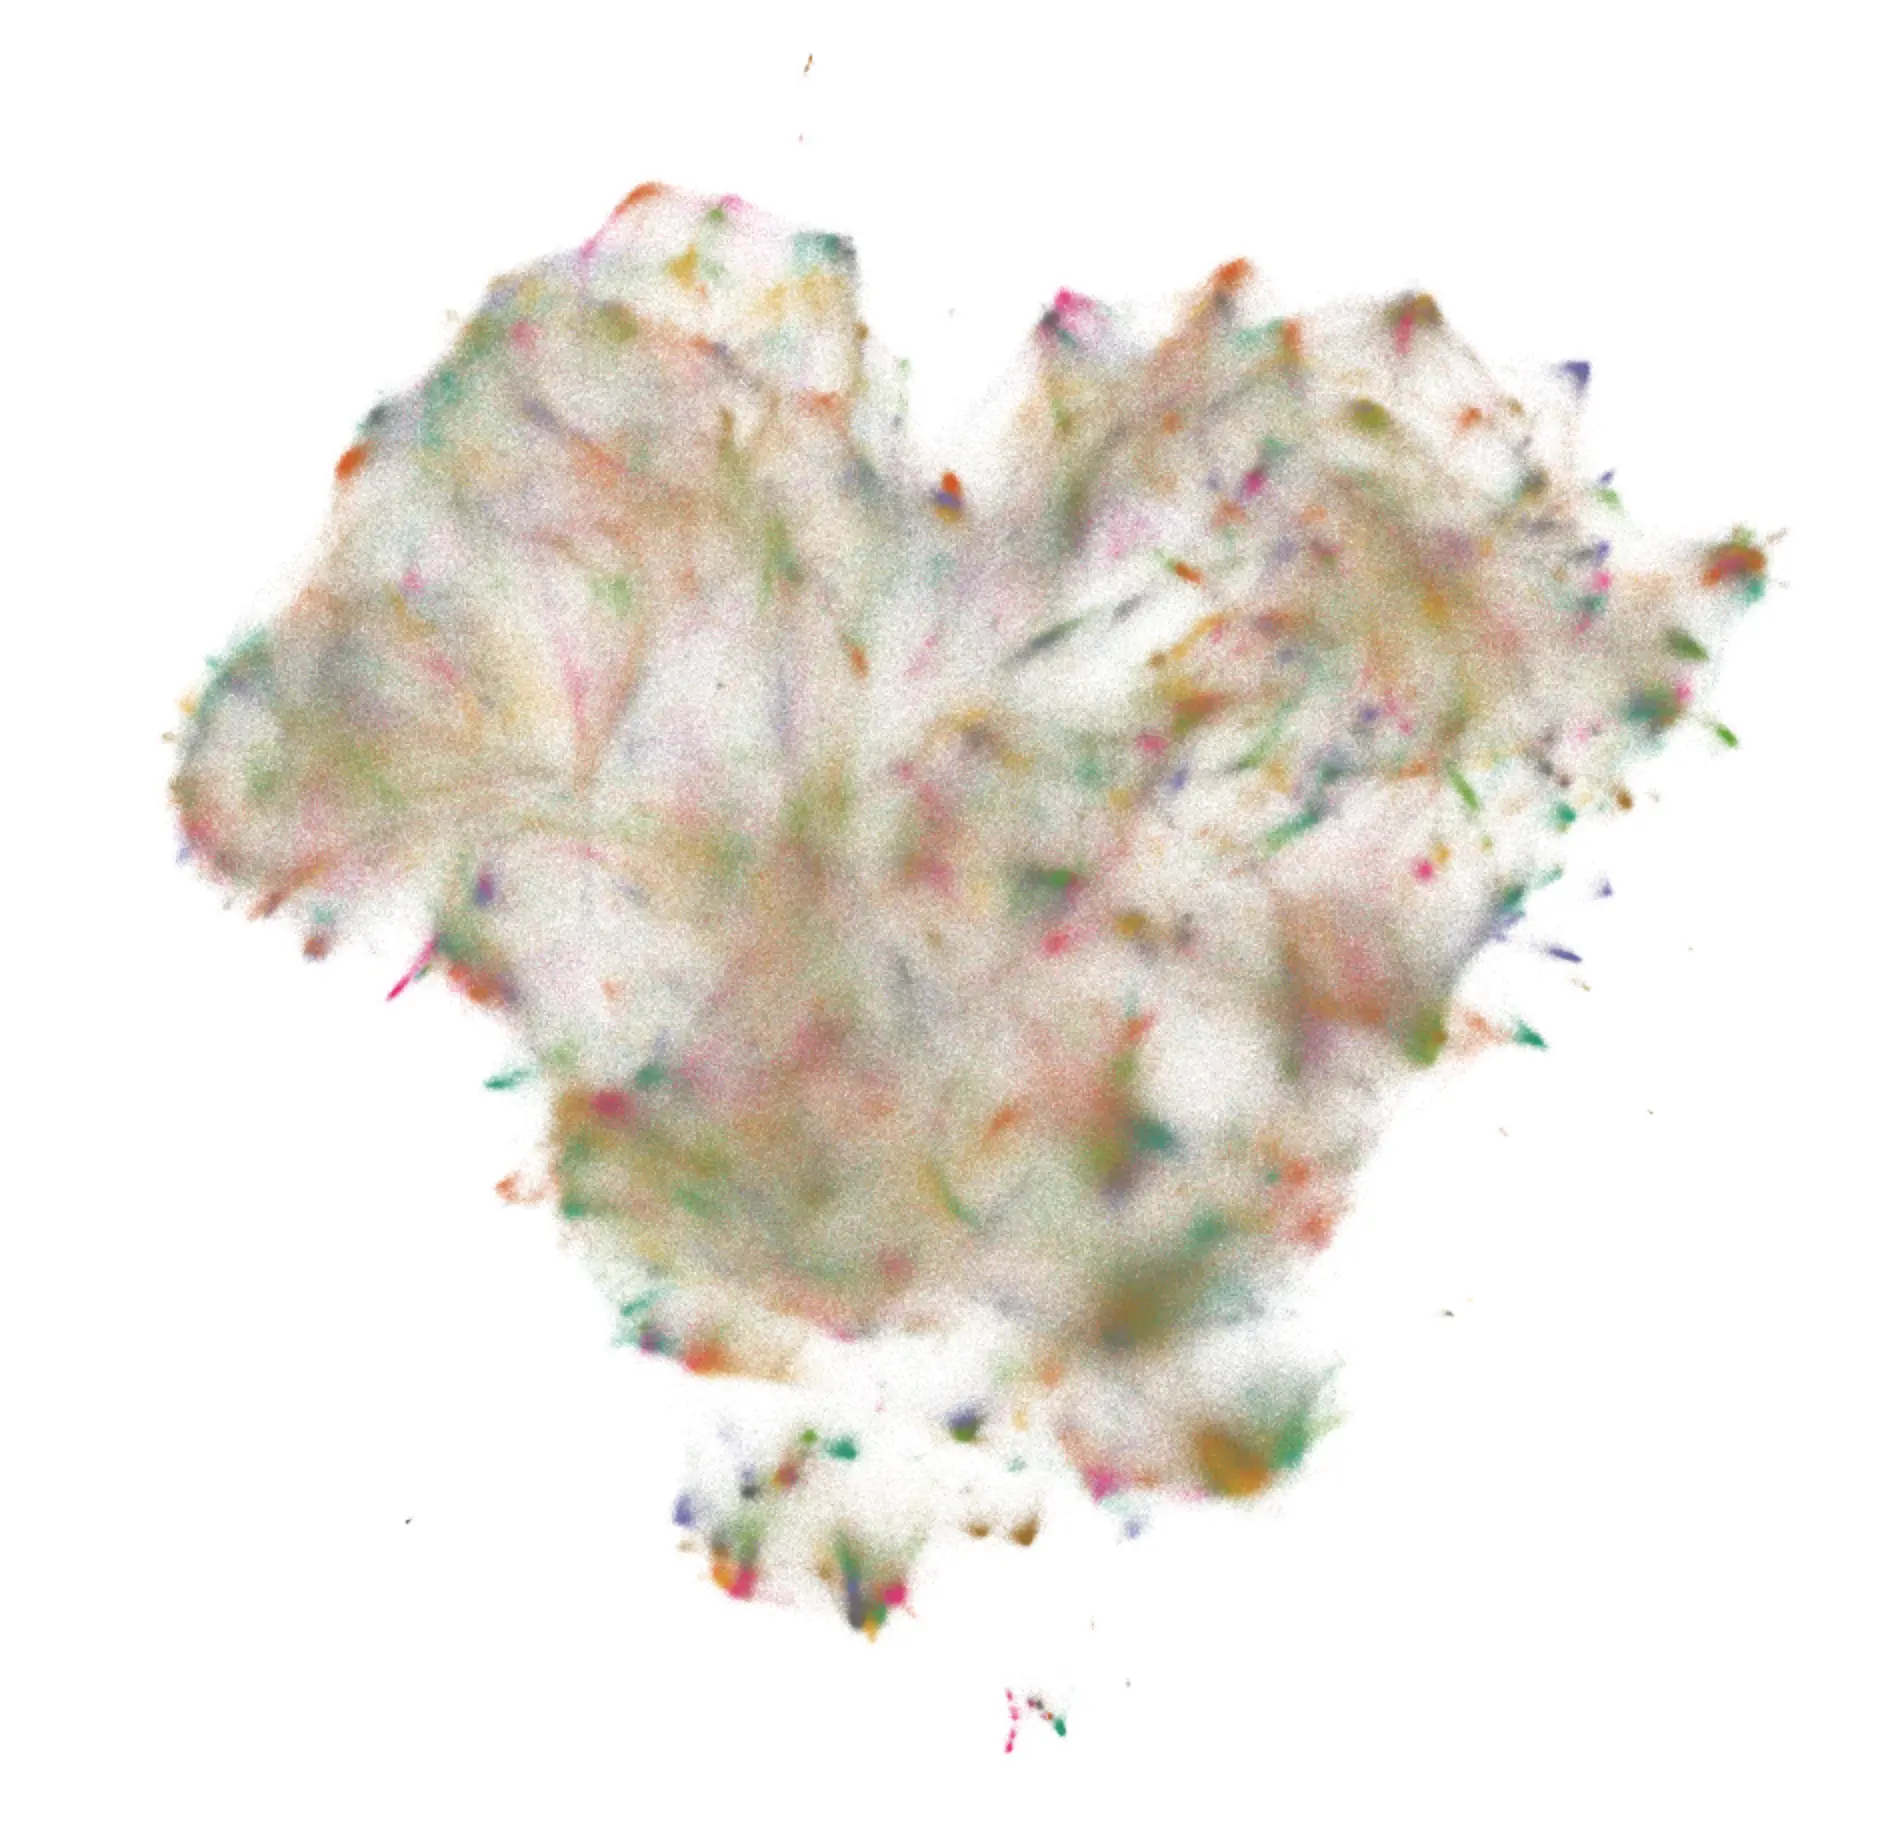
Click the Nomic Atlas map below to visualize a 5M sample of our contrastive pretraining data!
image/webp

We train our embedder using a multi-stage training pipeline. Starting from a long-context BERT model, the first unsupervised contrastive stage trains on a dataset generated from weakly related text pairs, such as question-answer pairs from forums like StackExchange and Quora, title-body pairs from Amazon reviews, and summarizations from news articles.

In the second finetuning stage, higher quality labeled datasets such as search queries and answers from web searches are leveraged. Data curation and hard-example mining is crucial in this stage.

For more details, see the Nomic Embed Technical Report and corresponding blog post.

Training data to train the models is released in its entirety. For more details, see the contrastors repository

Join the Nomic Community

Citation

If you find the model, dataset, or training code useful, please cite our work

@misc{nussbaum2024nomic,
      title={Nomic Embed: Training a Reproducible Long Context Text Embedder}, 
      author={Zach Nussbaum and John X. Morris and Brandon Duderstadt and Andriy Mulyar},
      year={2024},
      eprint={2402.01613},
      archivePrefix={arXiv},
      primaryClass={cs.CL}
}

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · sentence-transformers

Можно запустить

Подбираем GPU…

Класс архитектуры
NomicBertModel
Ревизия весов
3ac47f1

0 моделей