/ Модель

Характеристики

Контекст
128 000 токенов
Параметры
7,1 млрд
Размер весов
16,6 ГБ
Лицензия
Apache 2.0
Архитектура
qwen2_5_vl · dense
Базовая модель
Qwen2.5-VL-7B-Instruct
Библиотека
transformers
Опубликована
2 окт 2025

ERGO-7B

Изображение и текст → текст4 профессии

ERGO-7B — дообученная мультимодальная модель для эффективного анализа изображений и ответов на вопросы о них.

110скачиваний за 30 дней15лайковвеса обновлены25 фев 2026

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Изображение → текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

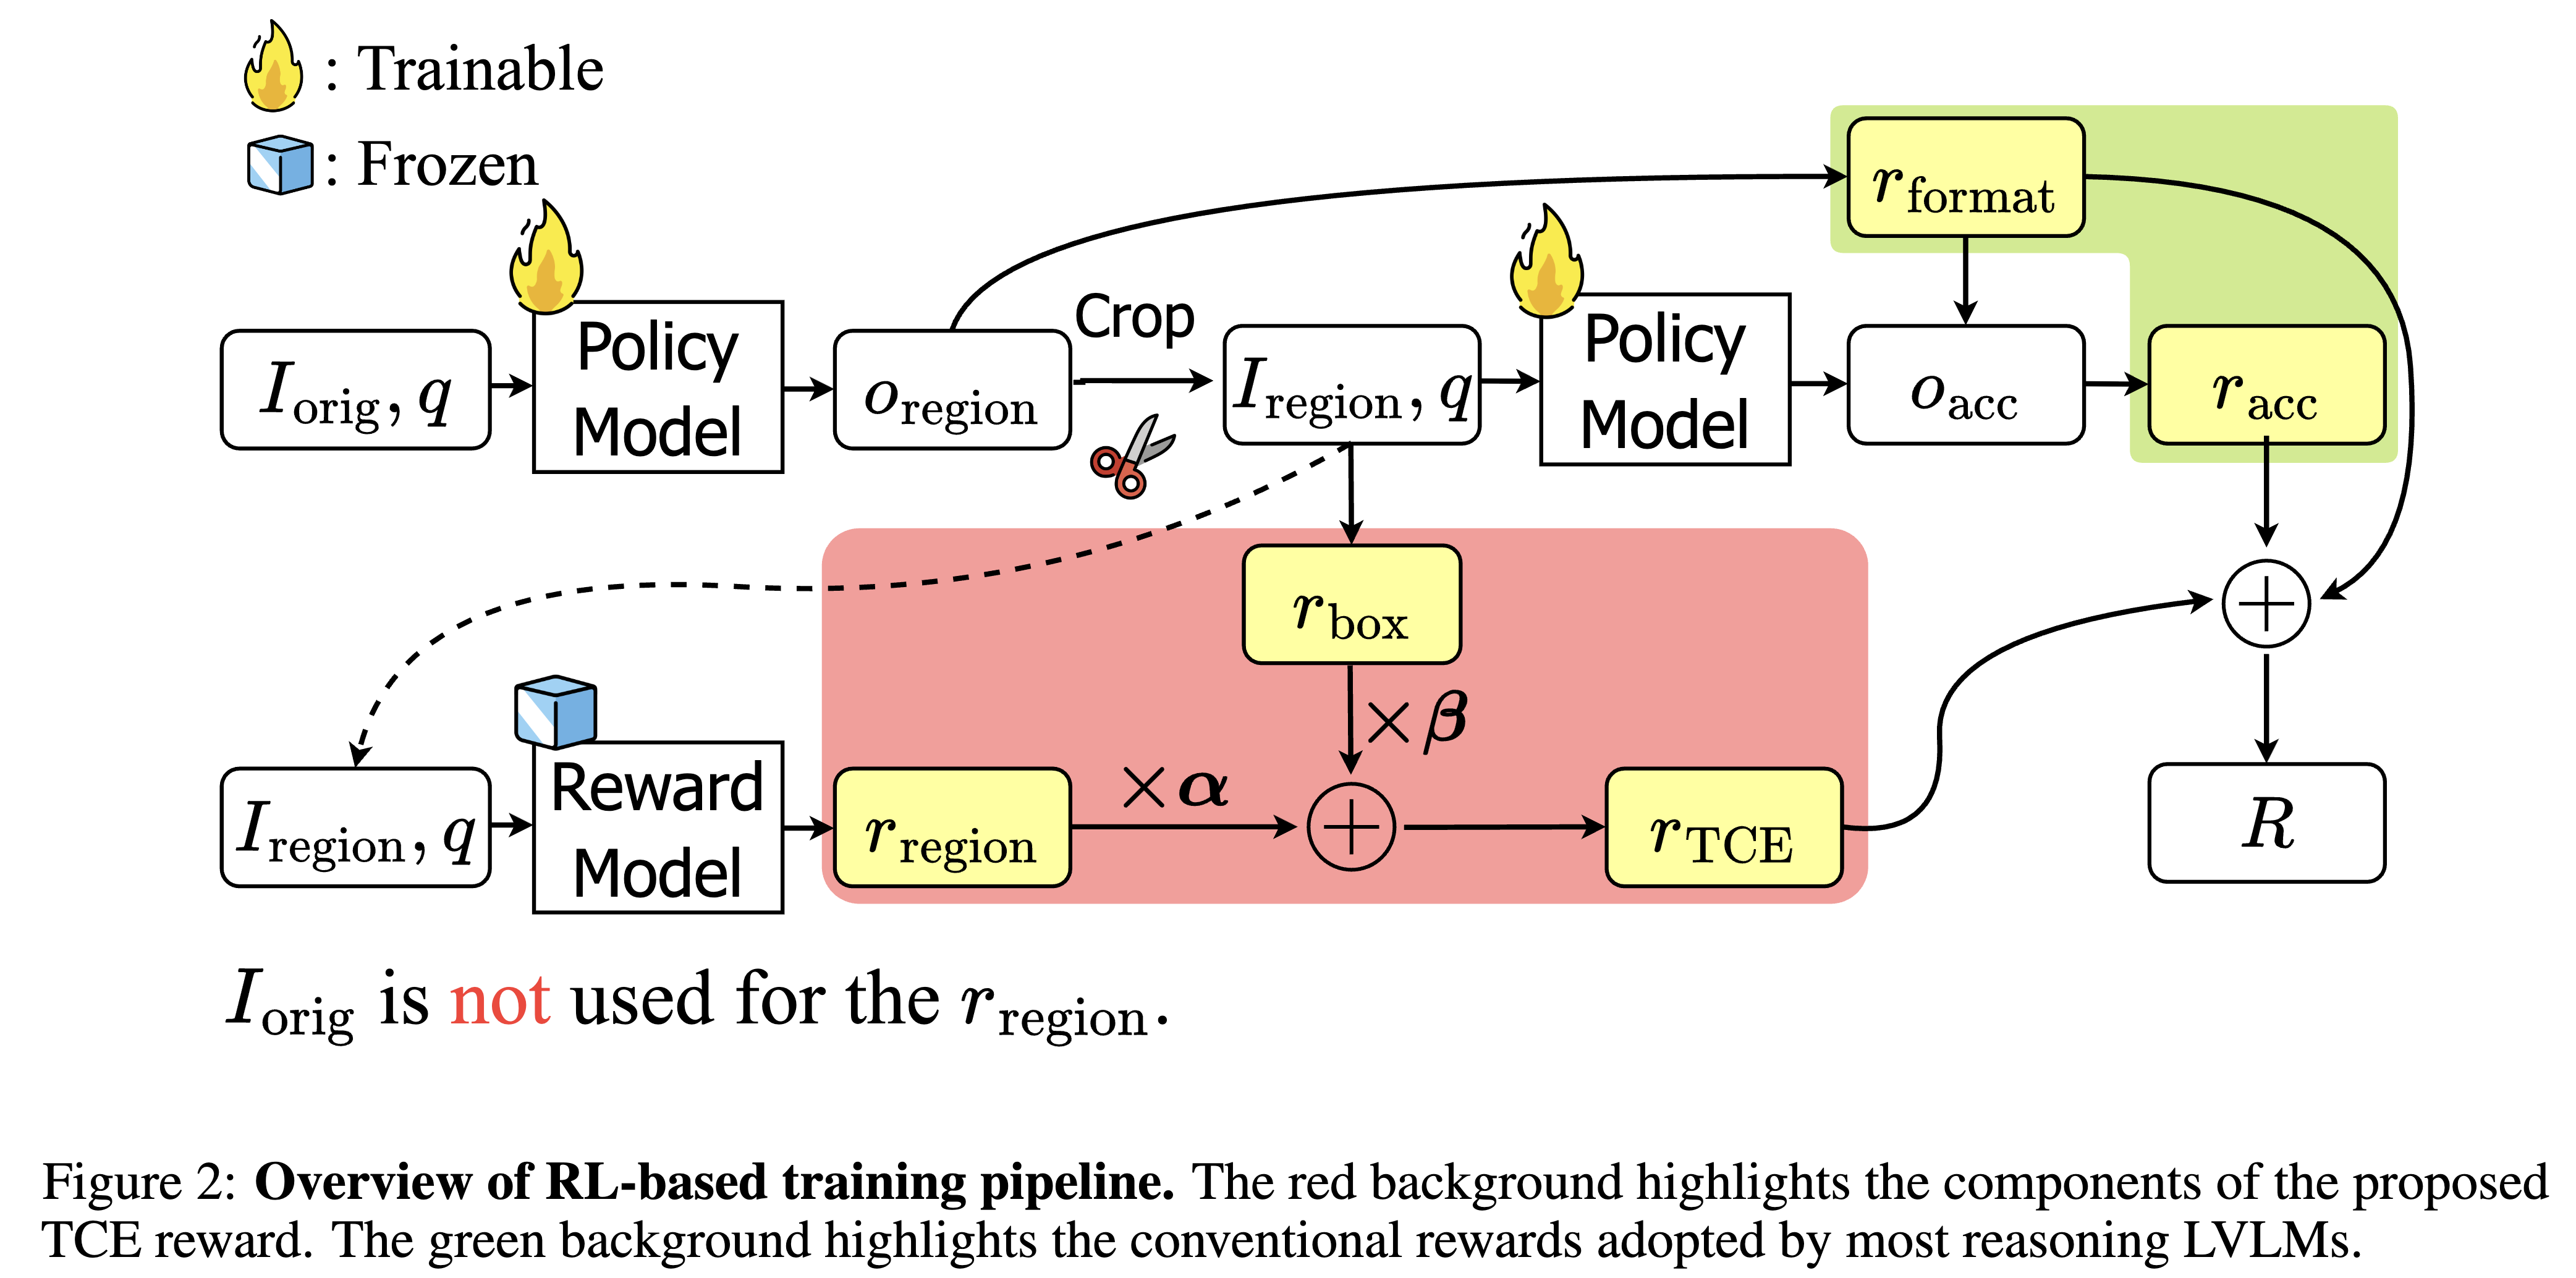
ERGO-7B — мультимодальная модель «зрение—язык» от nota-ai, дообученная на базе Qwen2.5-VL-7B-Instruct с помощью обучения с подкреплением, ориентированного на эффективность. Она анализирует изображения и отвечает на вопросы о визуальном содержимом, направляя внимание на области, важные для задачи; разработчики заявляют об ускорении инференса до 3 раз при сохранении или повышении точности.

Модель имеет плотную архитектуру Qwen2.5-VL с 7,1 млрд параметров, принимает текст и изображения и генерирует текст. Заявленный контекст — до 128 000 токенов. Карточка рекомендует использовать vLLM; конкретные языки применения не описаны. Модель распространяется по лицензии Apache-2.0.

Сценарии применения

  • ответы на вопросы по изображениям
  • визуальный анализ содержимого изображений
  • поиск значимых областей изображения для решения задачи
  • ускоренный инференс задач компьютерного зрения с текстовыми ответами

Ограничения

В README не приведены подробные результаты оценки качества или перечень поддерживаемых языков. Ускорение до 3 раз заявлено разработчиками и может зависеть от сценария и настроек инференса.

Для каких профессий подходит4

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

ERGO: Efficient High-Resolution Visual Understanding for Vision-Language Models

ERGO (Efficient Reasoning & Guided Observation) is a large vision–language model trained with reinforcement learning on efficiency objectives, focusing on task-relevant regions to enhance accuracy and achieve up to a 3× speedup in inference.
Installation

Python >= 3.10 is required.

curl -LsSf https://astral.sh/uv/install.sh | sh
git clone https://github.com/nota-github/ERGO.git
cd ERGO
uv venv
uv sync
source .venv/bin/activate
uv pip install -e .

Usage

We recommend using vLLM, as its Automatic Prefix Caching can significantly improve inference speed.

This repository provides evaluation scripts for the following benchmarks:

See data/README.md for how to prepare datasets

Evaluation with vLLM

  1. Serving with vLLM
bash ./scripts/run_vllm.sh
  1. Run eval.py
export MAX_VISION_TOKEN_NUM=1280
export VLLM_ENDPOINT=http://127.0.0.1:8008/v1
export DATA_ROOT=./data

python ./src/ergo/eval.py \
    --dataset {choose from [vstar, mmerwl, hrbench]} \
    --data_root $DATA_ROOT\
    --api_url $VLLM_ENDPOINT \
    --max_vision_token_num $MAX_VISION_TOKEN_NUM

Inference with Hugging Face

python ./src/ergo/infer.py \
    --input_path {default = "./data/demo/demo.jpg"} \
    --question {default = "Is the orange luggage on the left or right side of the purple umbrella?"} \
    {--save_output} # optional

License

This project is released under Apache 2.0 licence.

Acknowledgements

  • We would like to express our sincere appreciation to the following projects:

    • Qwen2.5-VL: The base model we utilized. They are originally licensed under Apache 2.0 License.
    • VLM-R1: The RL codebase we utilized. It is originally licensed under Apache 2.0 License.
    • V*, HR-Bench, MME-RealWorld-lite : The evaluation benchmark dataset we utilized.
  • We also deeply appreciate the generous GPU resource support from Gwangju AICA.

Citation

@misc{lee2025ergoefficienthighresolutionvisual,
      title={ERGO: Efficient High-Resolution Visual Understanding for Vision-Language Models}, 
      author={Jewon Lee and Wooksu Shin and Seungmin Yang and Ki-Ung Song and DongUk Lim and Jaeyeon Kim and Tae-Ho Kim and Bo-Kyeong Kim},
      year={2025},
      eprint={2509.21991},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2509.21991}, 
}

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · transformers

Можно запустить

Подбираем GPU…

Класс архитектуры
Qwen2_5_VLForConditionalGeneration
Ревизия весов
c8234d4

0 моделей