/ Модель

Характеристики

Контекст
2 048 токенов
Параметры
12,9 млрд
Размер весов
54,5 ГБ
Лицензия
Apache 2.0
Архитектура
beit3_llava · dense
Библиотека
transformers
Опубликована
27 ноя 2023

RLHF-V

Генерация текстаТекст → текст3 профессии

Мультимодальная модель на базе Vicuna-13B отвечает на вопросы об изображениях и инструкции, уделяя особое внимание снижению галлюцинаций.

231скачиваний за 30 дней21лайквеса обновлены28 мая 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

RLHF-V — мультимодальная большая языковая модель, разработанная авторами проекта RLHF-V и дообученная на базе Vicuna-13B. Она предназначена для ответов на вопросы по изображениям и выполнения коротких и развернутых инструкций с пониженным риском галлюцинаций. При обучении использованы наборы UniMM-Chat и RLHF-V-Dataset с детальными пользовательскими исправлениями отдельных фрагментов ответов; авторы применили метод Dense Direct Preference Optimization (DDPO). Модель содержит 12,9 млрд параметров, использует архитектуру BEiT-3/LLaVA с языковой частью на основе LLaMA и опубликована в формате PyTorch для Transformers.

Модель рассчитана на англоязычные мультимодальные диалоги: принимает текстовые инструкции и изображения, а генерирует текстовые ответы. Авторы заявляют о низкой частоте галлюцинаций и устойчивости к чрезмерным обобщениям, но численные результаты в карточке не приведены. Лицензия — Apache-2.0.

Сценарии применения

  • ответы на вопросы по изображению
  • описание содержимого изображения по инструкции
  • диалог с опорой на изображение
  • выполнение развернутых текстовых инструкций
  • снижение галлюцинаций в мультимодальных ответах

Ограничения

Заявления о низкой частоте галлюцинаций приведены авторами, но карточка не содержит численных результатов. В карточке не описаны поддерживаемые форматы изображений и ограничения на их размер.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Model Card for RLHF-V

Project Page | GitHub | Demo | Paper

News

  • [2024.05.28] 📃 Our RLAIF-V paper is accesible at arxiv now!
  • [2024.05.20] 🎉 We introduce RLAIF-V, our new alignment framework that utilize open-source models for feedback generation and reach super GPT-4V trustworthiness. You can download the corresponding dataset and models (7B, 12B) now!
  • [2024.04.11] 🔥 Our data is used in MiniCPM-V 2.0, an end-side multimodal large language model that exhibits comparable trustworthiness with GPT-4V!

Brief Introduction

RLHF-V is an open-source multimodal large language model with the lowest hallucination rate on both long-form instructions and short-form questions.

RLHF-V is trained on RLHF-V-Dataset, which contains fine-grained segment-level human corrections on diverse instructions. The base model is trained on UniMM-Chat, which is a high-quality knowledge-intensive SFT dataset. We introduce a new method Dense Direct Preference Optimization (DDPO) that can make better use of the fine-grained annotations.

For more details, please refer to our paper.
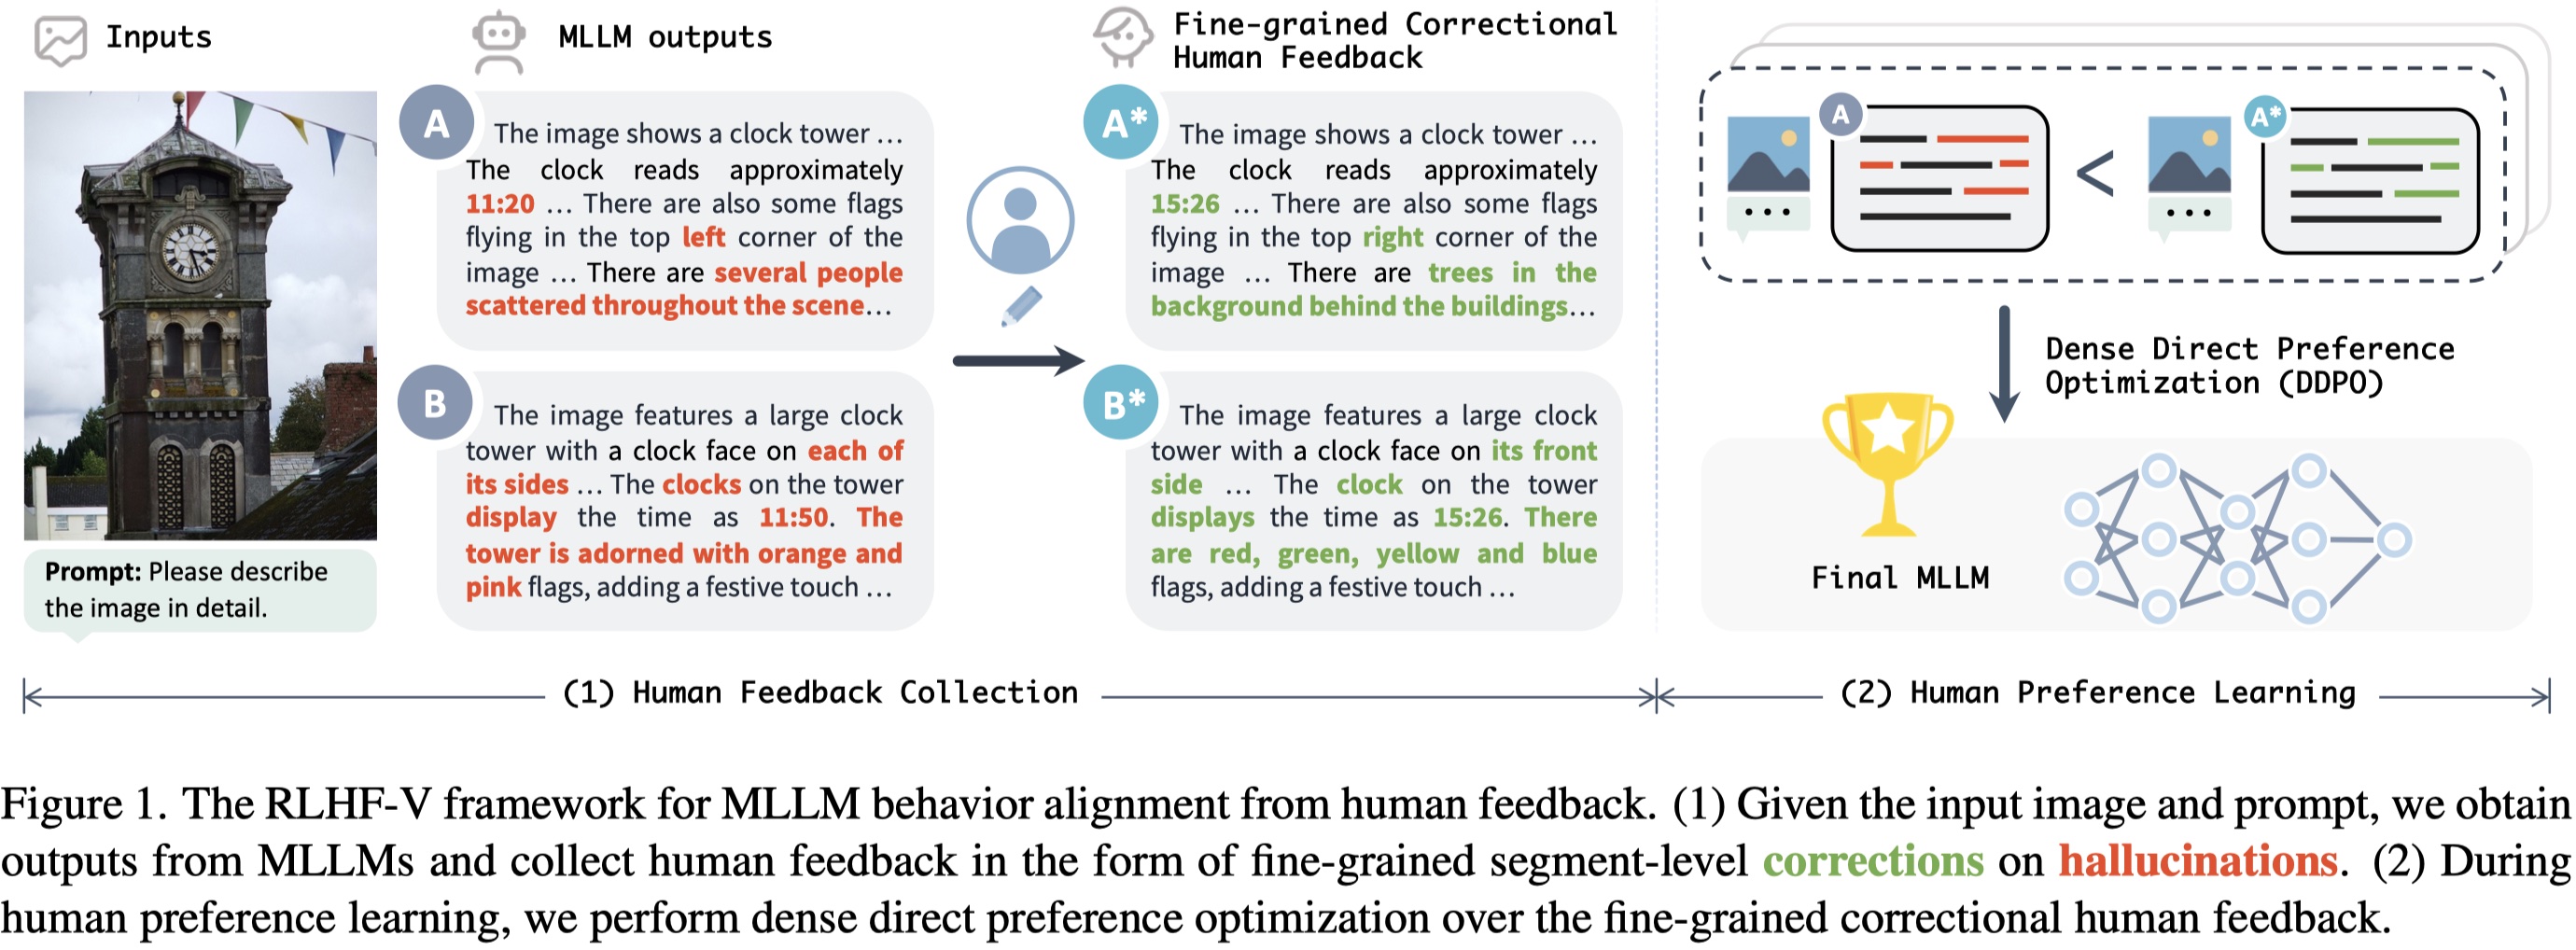
Illustration of the RLHF-V framework

Model Details

Model Description

Model Sources

Performance

Low hallucination rate while being informative:

fig2

More resistant to over-generalization, even compared to GPT-4V:
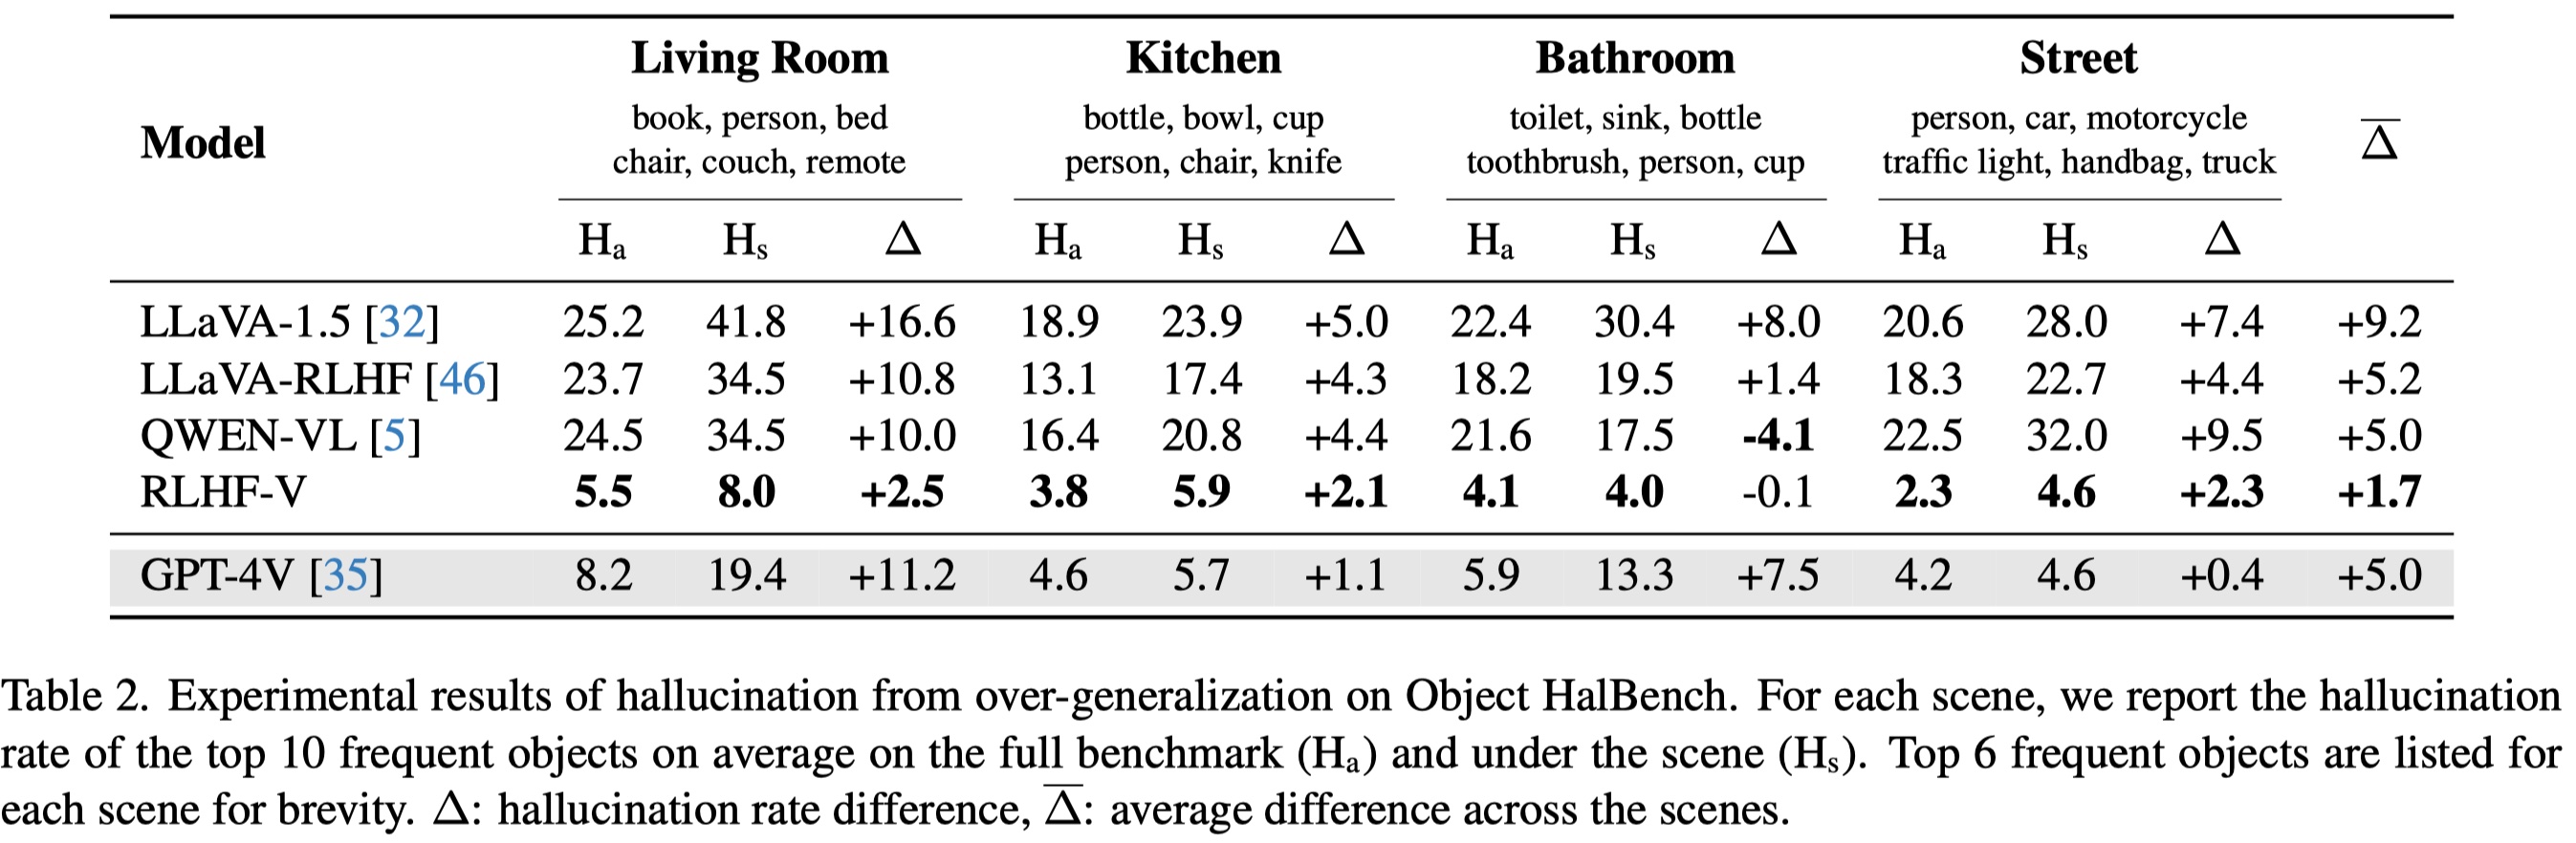
img

Citation

If you find this work helpful, please consider cite our papers 📝:

@article{yu2023rlhf,
  title={Rlhf-v: Towards trustworthy mllms via behavior alignment from fine-grained correctional human feedback},
  author={Yu, Tianyu and Yao, Yuan and Zhang, Haoye and He, Taiwen and Han, Yifeng and Cui, Ganqu and Hu, Jinyi and Liu, Zhiyuan and Zheng, Hai-Tao and Sun, Maosong and others},
  journal={arXiv preprint arXiv:2312.00849},
  year={2023}
}

@article{yu2024rlaifv,
  title={RLAIF-V: Aligning MLLMs through Open-Source AI Feedback for Super GPT-4V Trustworthiness}, 
  author={Yu, Tianyu and Zhang, Haoye and Yao, Yuan and Dang, Yunkai and Chen, Da and Lu, Xiaoman and Cui, Ganqu and He, Taiwen and Liu, Zhiyuan and Chua, Tat-Seng and Sun, Maosong},
  journal={arXiv preprint arXiv:2405.17220},
  year={2024},
}

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · transformers

Нельзя запустить

Архитектура beit3_llava неизвестна transformers в образе рантайма.

Класс архитектуры
Beit3LlavaLlamaForCausalLM
Ревизия весов
ba209b1

0 моделей