/ Модель

Характеристики

Лицензия
MIT
Архитектура
upernet · dense
Опубликована
13 янв 2023

upernet-convnext-tiny

Сегментация изображенийИзображение → mask3 профессии

Модель UPerNet с backbone ConvNeXt Tiny для семантической сегментации изображений с предсказанием класса каждого пикселя.

20 112скачиваний за 30 дней3лайкавеса обновлены24 апр 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

OpenMMLab upernet-convnext-tiny — модель для семантической сегментации изображений на основе архитектуры UPerNet и визуального backbone ConvNeXt Tiny. UPerNet объединяет backbone с Feature Pyramid Network и Pyramid Pooling Module и предсказывает семантическую метку для каждого пикселя. Модель доступна в форматах PyTorch и safetensors.

Модель предназначена для разметки изображений по классам и понимания сцен на уровне пикселей. Метаданные указывают английский язык карточки, но сама задача сегментации изображений не требует языкового ввода. Репозиторий распространяется по лицензии MIT. Карточка рекомендует применять базовую модель для сегментации и подбирать дообученные версии под конкретные наборы классов.

Сценарии применения

  • семантическая сегментация изображений
  • разметка объектов и областей по пикселям
  • понимание визуальных сцен
  • подготовка масок сегментации для компьютерного зрения

Ограничения

Для конкретного набора классов может потребоваться подходящая дообученная версия; карточка модели не приводит метрик качества или сведений о наборе классов.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

UperNet, ConvNeXt tiny-sized backbone

UperNet framework for semantic segmentation, leveraging a ConvNeXt backbone. UperNet was introduced in the paper Unified Perceptual Parsing for Scene Understanding by Xiao et al.

Combining UperNet with a ConvNeXt backbone was introduced in the paper A ConvNet for the 2020s.

Disclaimer: The team releasing UperNet + ConvNeXt did not write a model card for this model so this model card has been written by the Hugging Face team.

Model description

UperNet is a framework for semantic segmentation. It consists of several components, including a backbone, a Feature Pyramid Network (FPN) and a Pyramid Pooling Module (PPM).

Any visual backbone can be plugged into the UperNet framework. The framework predicts a semantic label per pixel.
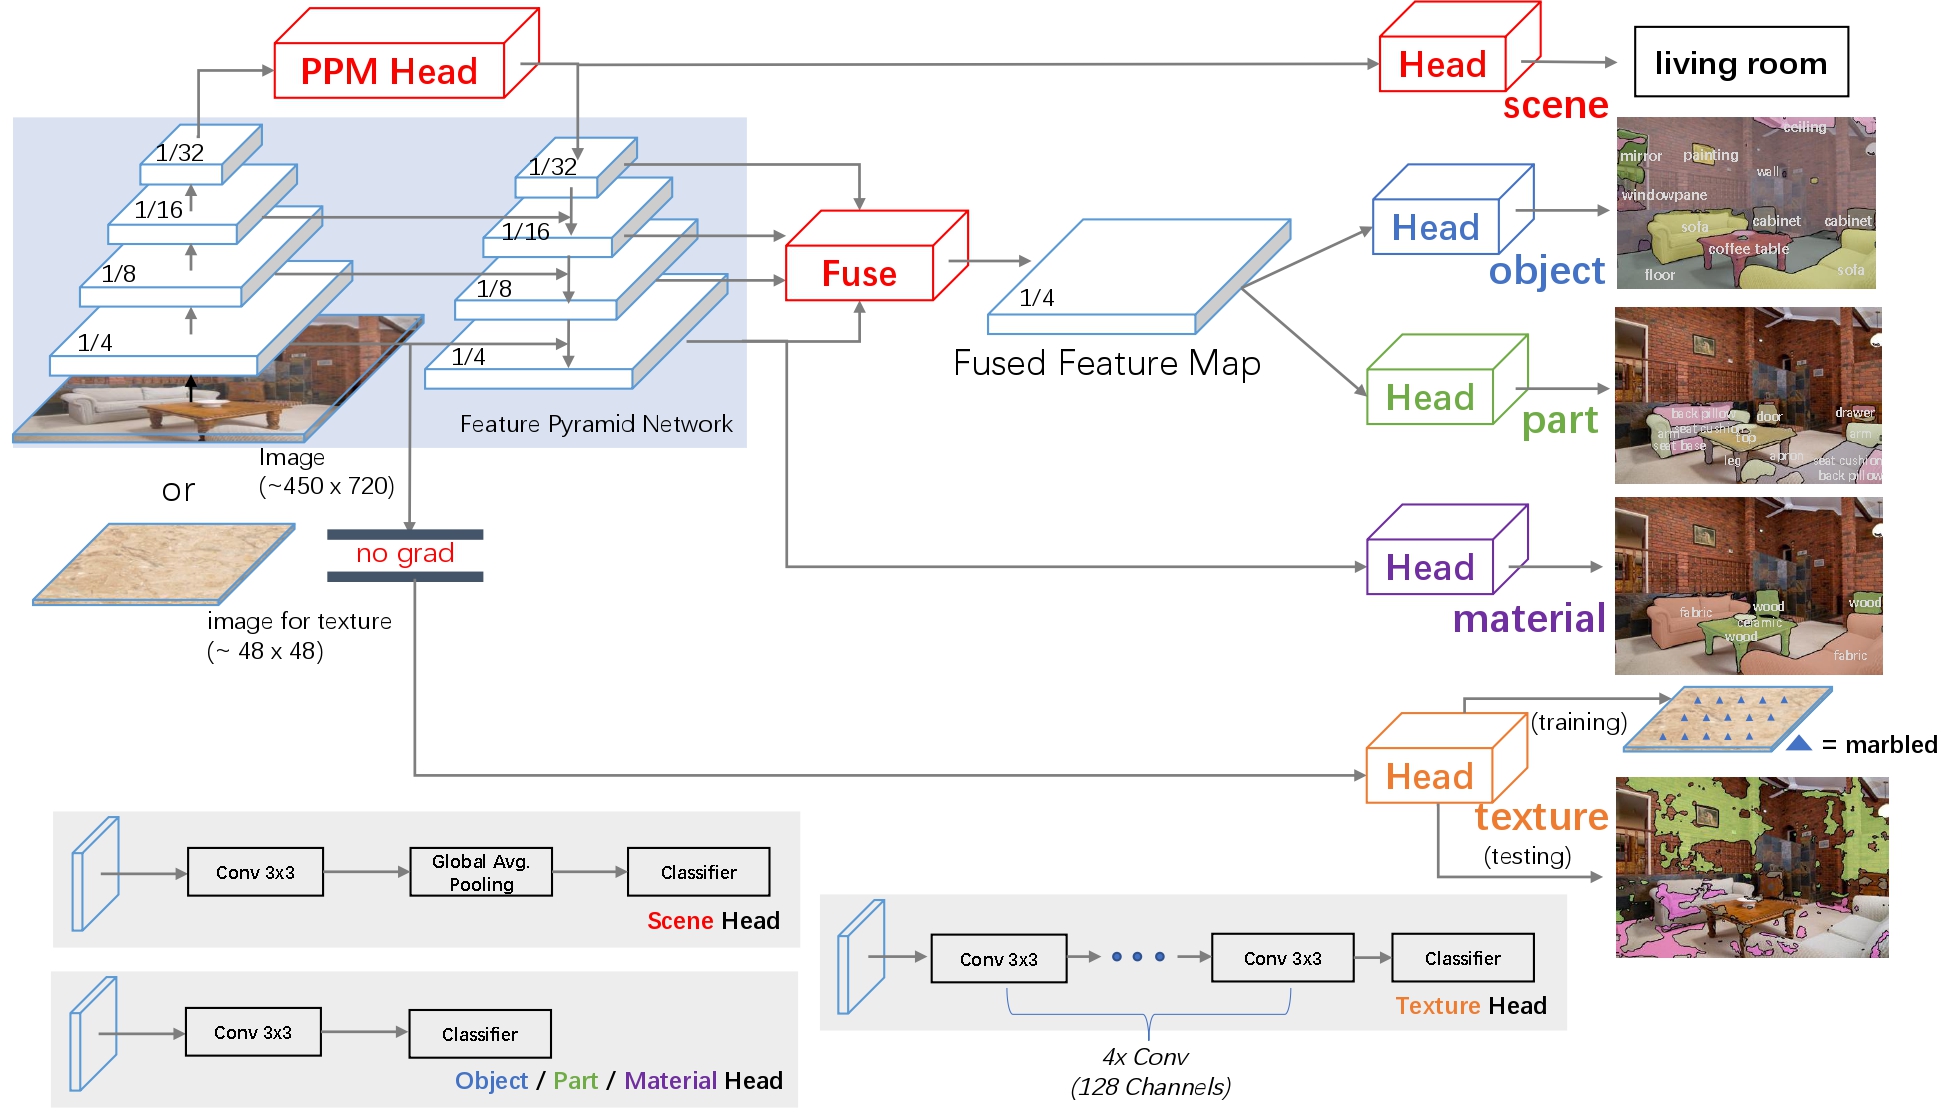
UperNet architecture

Intended uses & limitations

You can use the raw model for semantic segmentation. See the model hub to look for fine-tuned versions (with various backbones) on a task that interests you.

How to use

For code examples, we refer to the documentation.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · image-segmentation

Можно запустить

Подбираем GPU…

Класс архитектуры
UperNetForSemanticSegmentation
Ревизия весов
876ffc5

0 моделей