/ Модель

Характеристики

Лицензия
MIT
Архитектура
upernet · dense
Опубликована
13 янв 2023

upernet-swin-tiny

Сегментация изображенийИзображение → mask3 профессии

Компактная модель UperNet со Swin Transformer для семантической сегментации изображений с предсказанием класса каждого пикселя.

1 455скачиваний за 30 дней3лайкавеса обновлены19 янв 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

openmmlab/upernet-swin-tiny — модель семантической сегментации изображений на основе фреймворка UperNet и компактного backbone Swin Transformer. UperNet объединяет backbone с Feature Pyramid Network и модулем Pyramid Pooling Module; модель предсказывает семантическую метку для каждого пикселя изображения.

Модель предназначена для разметки сцен и разделения изображений на семантические области. Вариант Swin Transformer tiny использует иерархический vision transformer со сдвинутыми окнами. Репозиторий содержит веса PyTorch и опубликован под лицензией MIT. Карточка не приводит конкретные датасеты или набор классов сегментации; для специализированных сценариев доступны дообученные варианты.

Сценарии применения

  • пиксельная разметка объектов и областей на изображении
  • семантическое разделение элементов городской или природной сцены
  • создание карт классов пикселей для компьютерного зрения

Ограничения

Модель выдаёт семантические метки пикселей, а не экземплярные маски объектов. Карточка не уточняет набор классов и датасет обучения.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

UperNet, Swin Transformer tiny-sized backbone

UperNet framework for semantic segmentation, leveraging a Swin Transformer backbone. UperNet was introduced in the paper Unified Perceptual Parsing for Scene Understanding by Xiao et al.

Combining UperNet with a Swin Transformer backbone was introduced in the paper Swin Transformer: Hierarchical Vision Transformer using Shifted Windows.

Disclaimer: The team releasing UperNet + Swin Transformer did not write a model card for this model so this model card has been written by the Hugging Face team.

Model description

UperNet is a framework for semantic segmentation. It consists of several components, including a backbone, a Feature Pyramid Network (FPN) and a Pyramid Pooling Module (PPM).

Any visual backbone can be plugged into the UperNet framework. The framework predicts a semantic label per pixel.
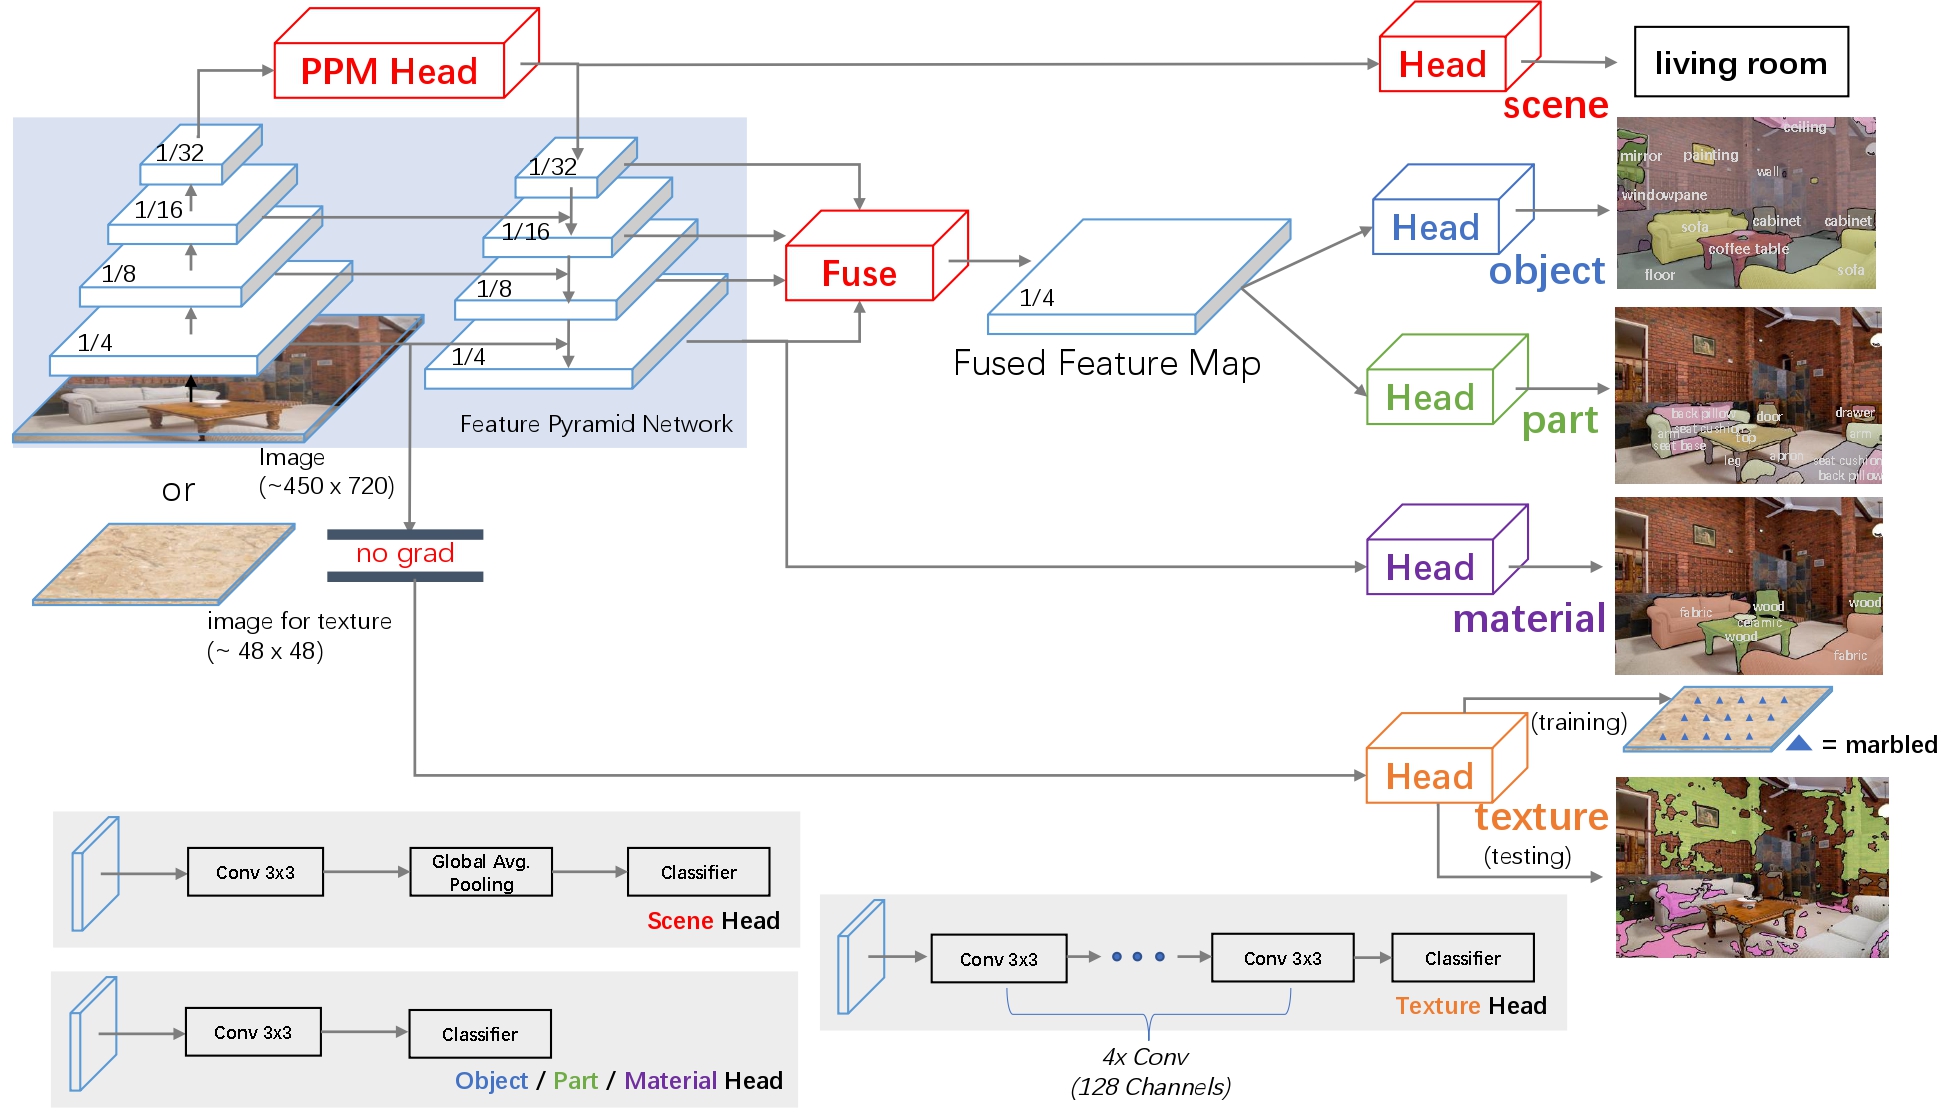
UperNet architecture

Intended uses & limitations

You can use the raw model for semantic segmentation. See the model hub to look for fine-tuned versions (with various backbones) on a task that interests you.

How to use

For code examples, we refer to the documentation.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · image-segmentation

Можно запустить

Подбираем GPU…

Класс архитектуры
UperNetForSemanticSegmentation
Ревизия весов
dc8e8c9

0 моделей