/ Модель

Характеристики

Контекст
131 072 токена
Параметры
1,6 млрд
Размер весов
41,8 ГБ
Архитектура
gpt_oss · MoE
Базовая модель
gpt-oss-20b
Библиотека
transformers
Опубликована
12 мая 2026

harness-1

Генерация текстаТекст → текст8 профессий

Harness-1 — дообученная на базе openai/gpt-oss-20b модель-агент для поиска и извлечения информации из веба, патентов и отчётности SEC.

299скачиваний за 30 дней107лайковвеса обновлены15 июн 2026

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Harness-1 — поисковый агент на базе gpt-oss-20b, опубликованный pat-jj. Это дообученная и объединённая с базовой моделью контрольная точка; веса доступны в формате safetensors для Transformers. Модель предназначена для поиска и извлечения сведений из веб-материалов, патентов, финансовой отчётности SEC и корпуса BrowseComp+.

README описывает обучение на 899 траекториях SFT и 3 453 примерах SEC для RL, а также указывает корпусные данные для поиска. Метаданные задают архитектуру GPT-OSS MoE, задачу генерации текста, чат-возможность и контекст до 131 072 токенов. Для работы с опубликованными корпусами потребуется отдельный поисковый контур; сам репозиторий модели содержит веса. Лицензия в предоставленных данных не указана.

Сценарии применения

  • поиск ответов в веб-материалах
  • поиск сведений в патентах
  • извлечение данных из отчётности SEC
  • ответы на исследовательские вопросы с использованием поискового корпуса

Ограничения

Для поиска требуются корпуса и поисковый контур, которые опубликованы отдельно от весов модели. В предоставленных данных условия лицензии не приведены.

Для каких профессий подходит8

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Harness-1

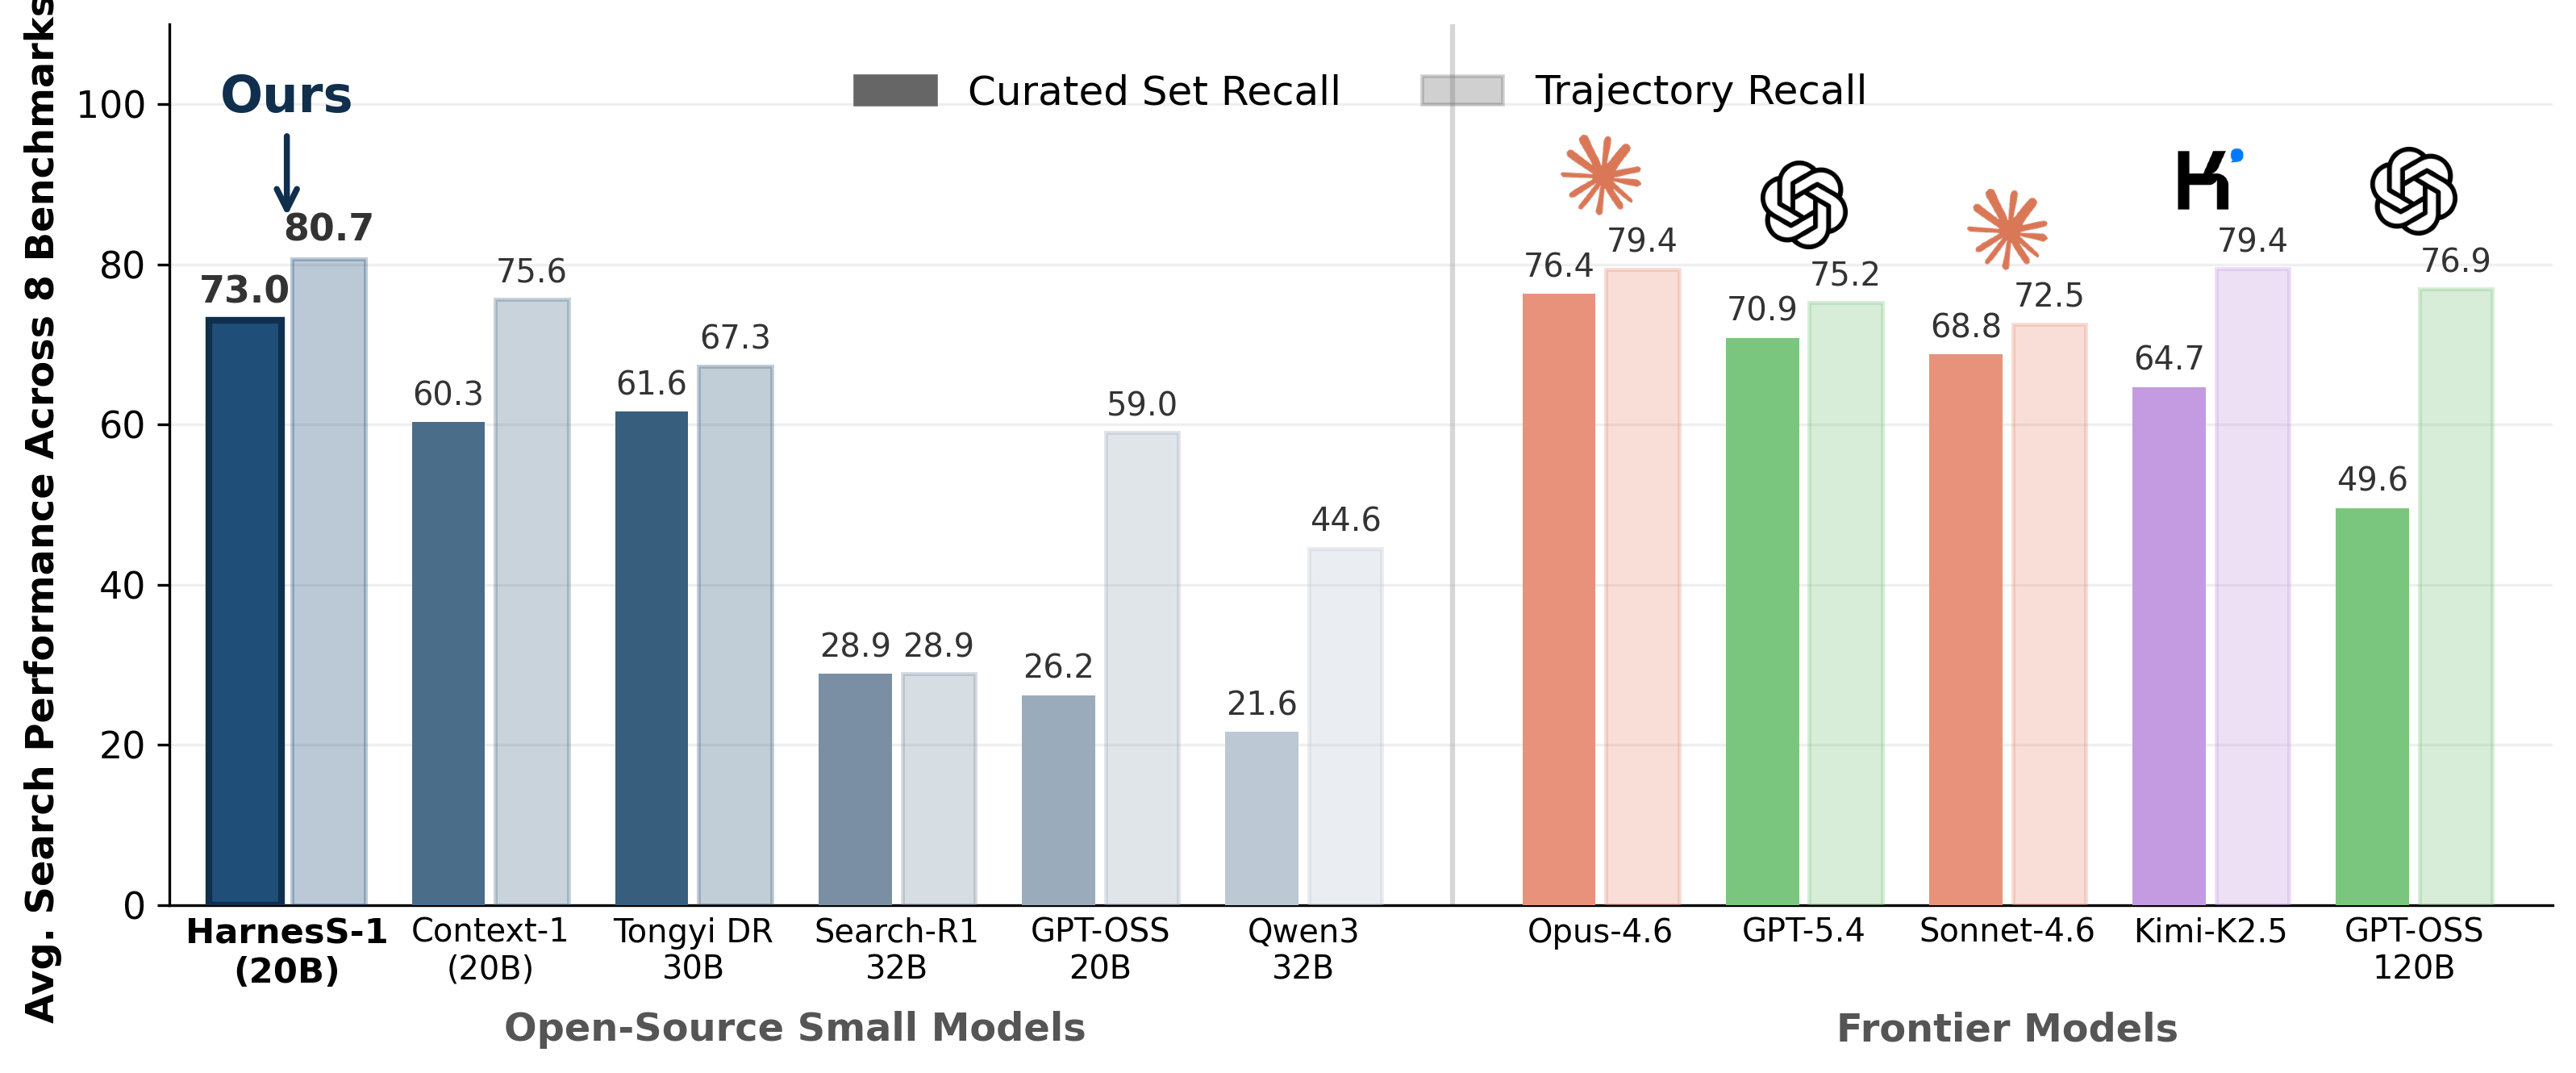
A 20B search agent that matches frontier AI's search capability.

News

  • 2026-06-15: Released Harness-1 training data and retrieval corpora at pat-jj/harness-1-train-data: 899 SFT trajectories, 3,453 RL SEC train-split examples, and corpus shards for BrowseComp+, web, patents, and SEC.
  • 2026-06-15: Released the full merged Harness-1 checkpoint as standard Hugging Face safetensors shards.

Harness-1 average search performance

Code: https://github.com/pat-jj/harness-1

Paper: https://arxiv.org/abs/2606.02373

Training data and corpora: https://huggingface.co/datasets/pat-jj/harness-1-train-data

Tinker inference example: https://github.com/pat-jj/harness-1/blob/main/inference/tinker_inference.md

vLLM inference example: https://github.com/pat-jj/harness-1/blob/main/inference/vllm_h100_browsecompplus.md

This repository contains the full merged Harness-1 release checkpoint. The model is merged into the openai/gpt-oss-20b base model and saved as standard Hugging Face safetensors shards.

Training Data And Corpora

The Harness-1 training data and retrieval corpora are published separately as pat-jj/harness-1-train-data. It contains one train split with a stage column:

  • sft: 899 raw GPT-5.4-generated v8d SFT trajectories produced by generate_sft_ultra_0417.py.
  • rl: 3,453 SEC training-split query records used for RL (TRAIN_DATASETS=sec, RL_QUERY_SPLIT=train).

The same dataset repo also includes retrieval corpora under corpora/:

  • corpora/browsecompplus/test: 1,144,886 chunks.
  • corpora/web/train: 219,388 chunks.
  • corpora/web/test: 54,735 chunks.
  • corpora/patents/train: 104,842 chunks.
  • corpora/patents/test: 35,551 chunks.
  • corpora/sec/train: 2,115,106 chunks.
from datasets import load_dataset

ds = load_dataset("pat-jj/harness-1-train-data", split="train")
sft = ds.filter(lambda row: row["stage"] == "sft")
rl = ds.filter(lambda row: row["stage"] == "rl")

sec_corpus = load_dataset(
    "parquet",
    data_files="hf://datasets/pat-jj/harness-1-train-data/corpora/sec/train/*.parquet",
    split="train",
)

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · transformers

Можно запустить

Подбираем GPU…

Класс архитектуры
GptOssForCausalLM
Ревизия весов
363a19f

0 моделей