Portuguese BERT large cased QA (Question Answering), finetuned on SQUAD v1.1
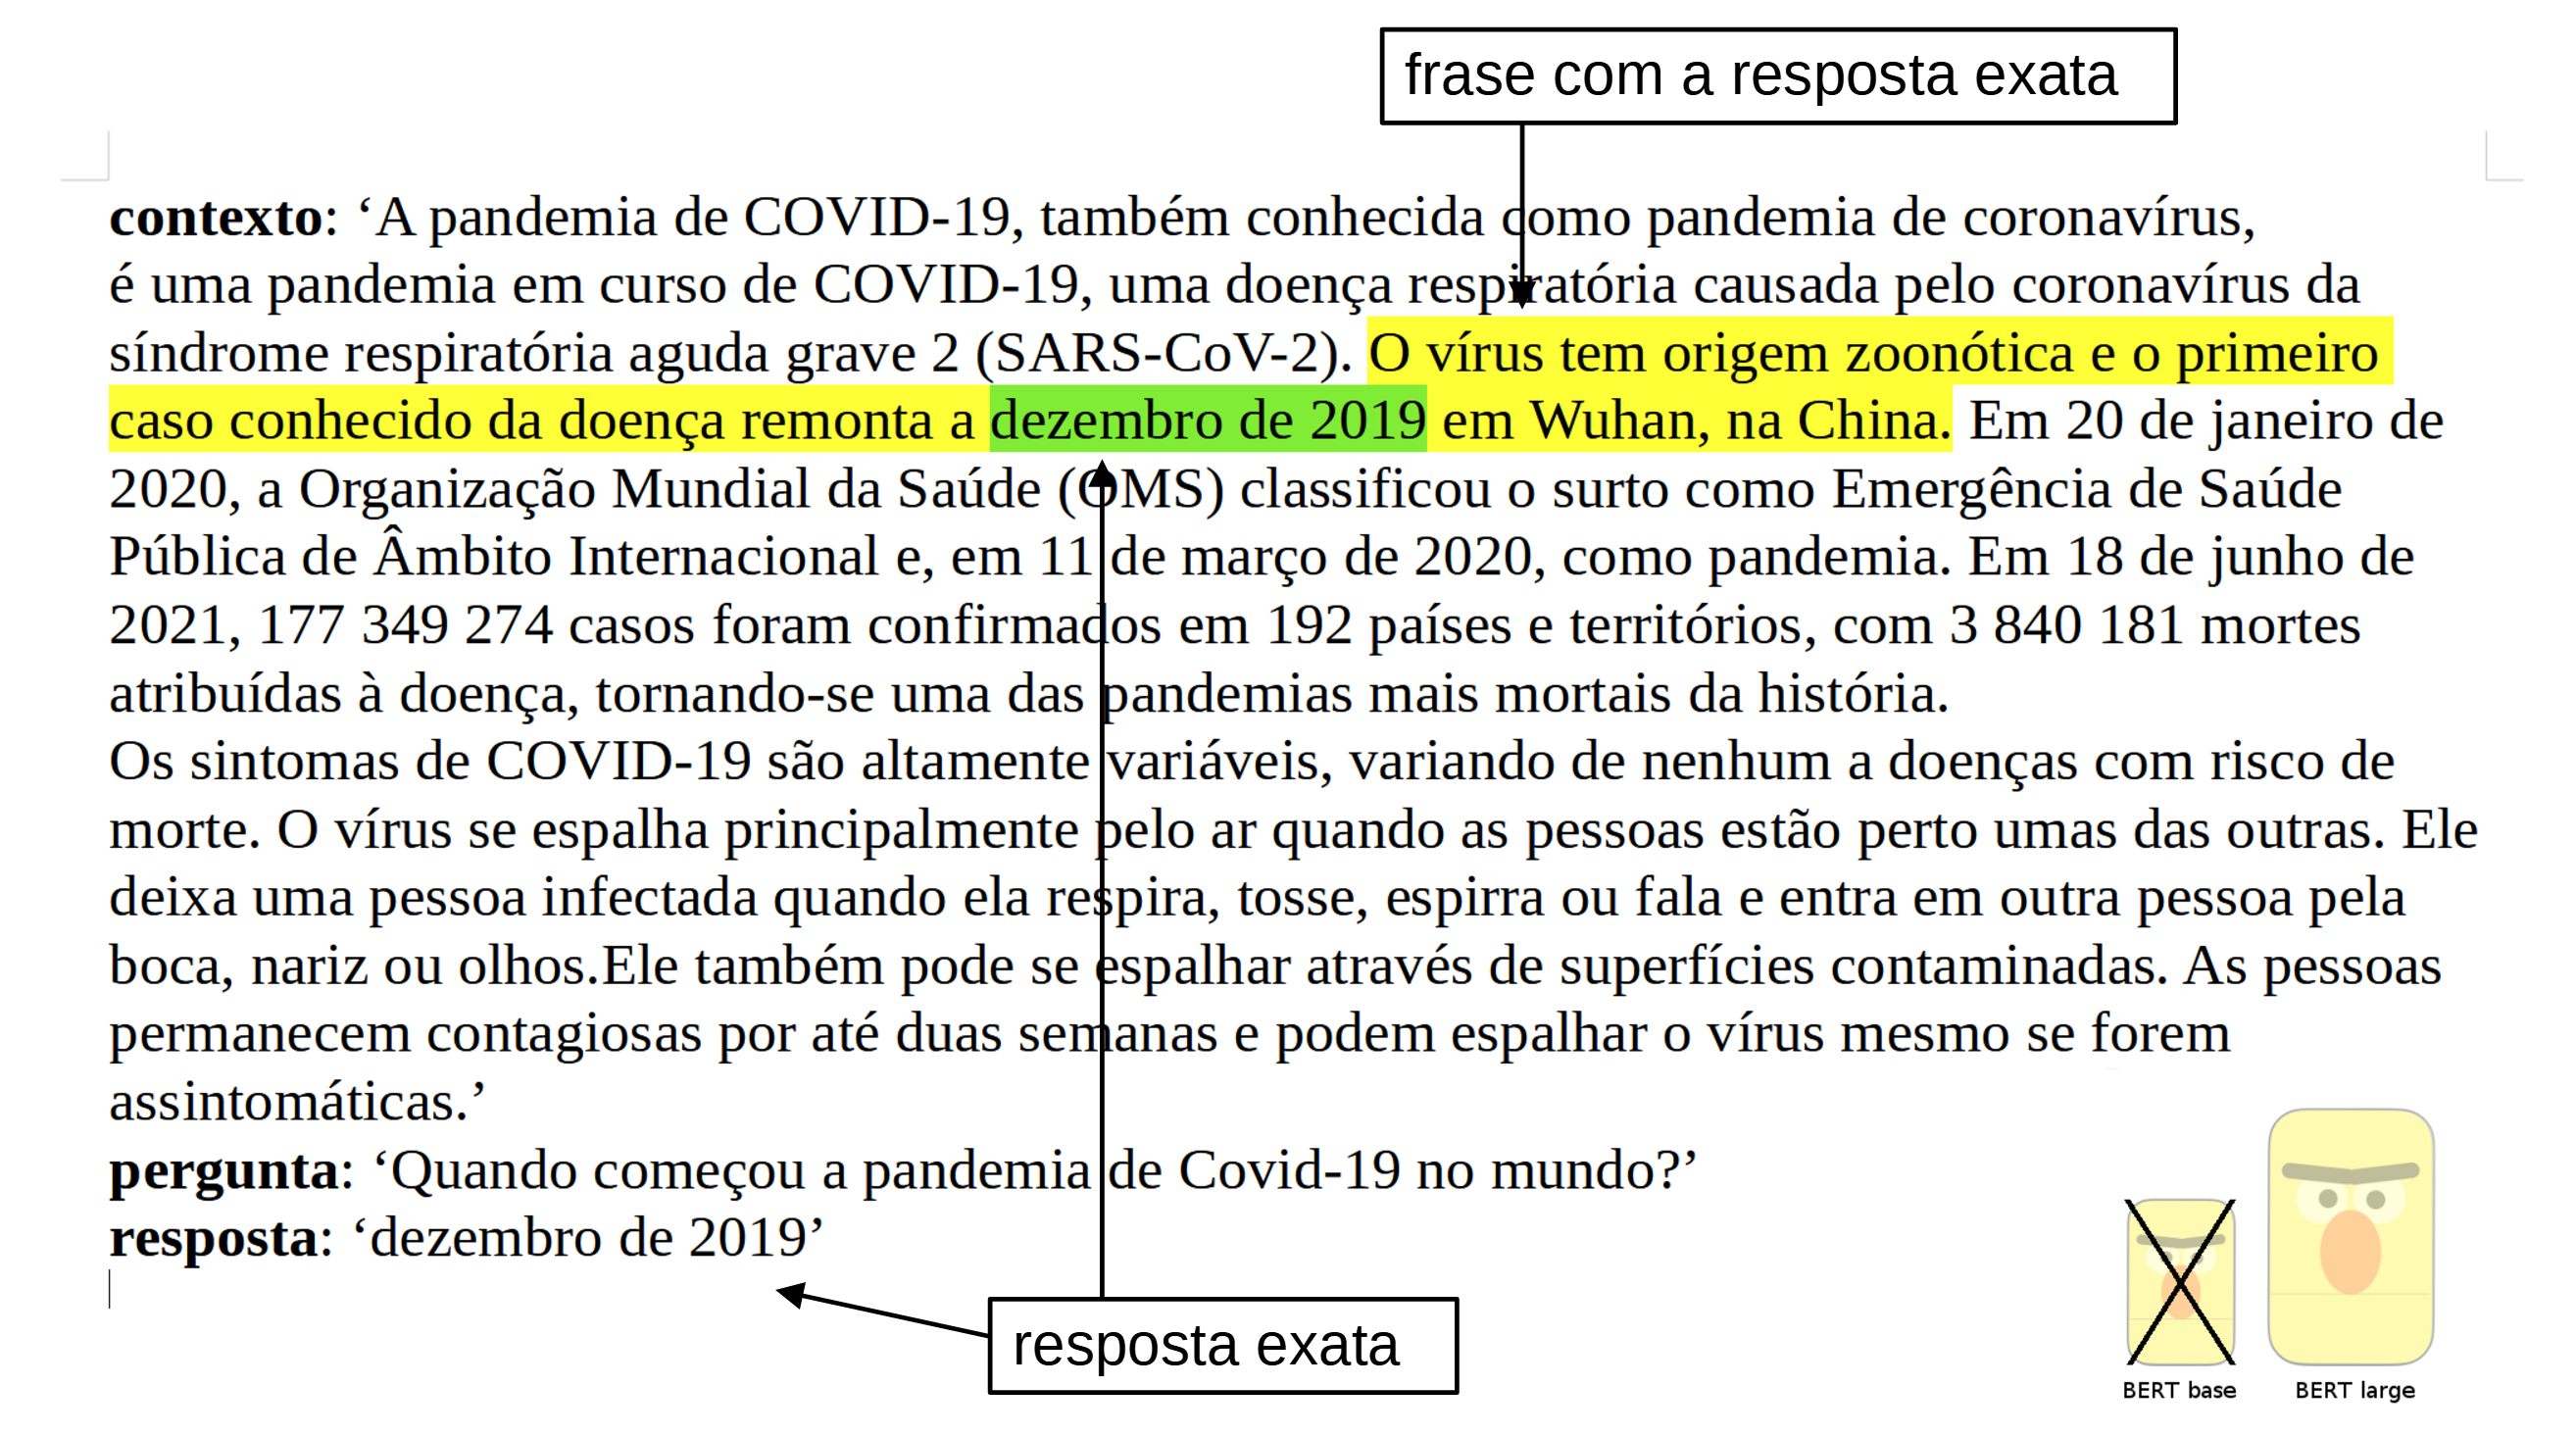
Introduction
The model was trained on the dataset SQUAD v1.1 in portuguese from the Deep Learning Brasil group.
The language model used is the BERTimbau Large (aka "bert-large-portuguese-cased") from Neuralmind.ai: BERTimbau is a pretrained BERT model for Brazilian Portuguese that achieves state-of-the-art performances on three downstream NLP tasks: Named Entity Recognition, Sentence Textual Similarity and Recognizing Textual Entailment. It is available in two sizes: Base and Large.
Informations on the method used
All the informations are in the blog post : NLP | Como treinar um modelo de Question Answering em qualquer linguagem baseado no BERT large, melhorando o desempenho do modelo utilizando o BERT base? (estudo de caso em português)
Notebook in GitHub
question_answering_BERT_large_cased_squad_v11_pt.ipynb (nbviewer version)
Performance
The results obtained are the following:
f1 = 84.43 (against 82.50 for the base model)
exact match = 72.68 (against 70.49 for the base model)
How to use the model... with Pipeline
import transformers
from transformers import pipeline

# source: https://pt.wikipedia.org/wiki/Pandemia_de_COVID-19
context = r"""
A pandemia de COVID-19, também conhecida como pandemia de coronavírus, é uma pandemia em curso de COVID-19,
uma doença respiratória causada pelo coronavírus da síndrome respiratória aguda grave 2 (SARS-CoV-2).
O vírus tem origem zoonótica e o primeiro caso conhecido da doença remonta a dezembro de 2019 em Wuhan, na China.
Em 20 de janeiro de 2020, a Organização Mundial da Saúde (OMS) classificou o surto
como Emergência de Saúde Pública de Âmbito Internacional e, em 11 de março de 2020, como pandemia.
Em 18 de junho de 2021, 177 349 274 casos foram confirmados em 192 países e territórios,
com 3 840 181 mortes atribuídas à doença, tornando-se uma das pandemias mais mortais da história.
Os sintomas de COVID-19 são altamente variáveis, variando de nenhum a doenças com risco de morte.
O vírus se espalha principalmente pelo ar quando as pessoas estão perto umas das outras.
Ele deixa uma pessoa infectada quando ela respira, tosse, espirra ou fala e entra em outra pessoa pela boca, nariz ou olhos.
Ele também pode se espalhar através de superfícies contaminadas.
As pessoas permanecem contagiosas por até duas semanas e podem espalhar o vírus mesmo se forem assintomáticas.
"""

model_name = 'pierreguillou/bert-large-cased-squad-v1.1-portuguese'
nlp = pipeline("question-answering", model=model_name)

question = "Quando começou a pandemia de Covid-19 no mundo?"

result = nlp(question=question, context=context)

print(f"Answer: '{result['answer']}', score: {round(result['score'], 4)}, start: {result['start']}, end: {result['end']}")

# Answer: 'dezembro de 2019', score: 0.5087, start: 290, end: 306
How to use the model... with the Auto classes
from transformers import AutoTokenizer, AutoModelForQuestionAnswering

tokenizer = AutoTokenizer.from_pretrained("pierreguillou/bert-large-cased-squad-v1.1-portuguese")
model = AutoModelForQuestionAnswering.from_pretrained("pierreguillou/bert-large-cased-squad-v1.1-portuguese")
Or just clone the model repo:
git lfs install
git clone https://huggingface.co/pierreguillou/bert-large-cased-squad-v1.1-portuguese

# if you want to clone without large files – just their pointers
# prepend your git clone with the following env var:

GIT_LFS_SKIP_SMUDGE=1
Limitations and bias
The training data used for this model come from Portuguese SQUAD. It could contain a lot of unfiltered content, which is far from neutral, and biases.
Author
Portuguese BERT large cased QA (Question Answering), finetuned on SQUAD v1.1 was trained and evaluated by Pierre GUILLOU thanks to the Open Source code, platforms and advices of many organizations (link to the list). In particular: Hugging Face, Neuralmind.ai, Deep Learning Brasil group and AI Lab.
Citation
If you use our work, please cite:
@inproceedings{pierreguillou2021bertlargecasedsquadv11portuguese,
  title={Portuguese BERT large cased QA (Question Answering), finetuned on SQUAD v1.1},
  author={Pierre Guillou},
  year={2021}
}