Document Understanding model (finetuned LiLT base at line level on DocLayNet base)
This model is a fine-tuned version of nielsr/lilt-xlm-roberta-base with the DocLayNet base dataset. It achieves the following results on the evaluation set:
- Loss: 1.0003
- Precision: 0.8584
- Recall: 0.8584
- F1: 0.8584
- Tokens Accuracy: 0.8584
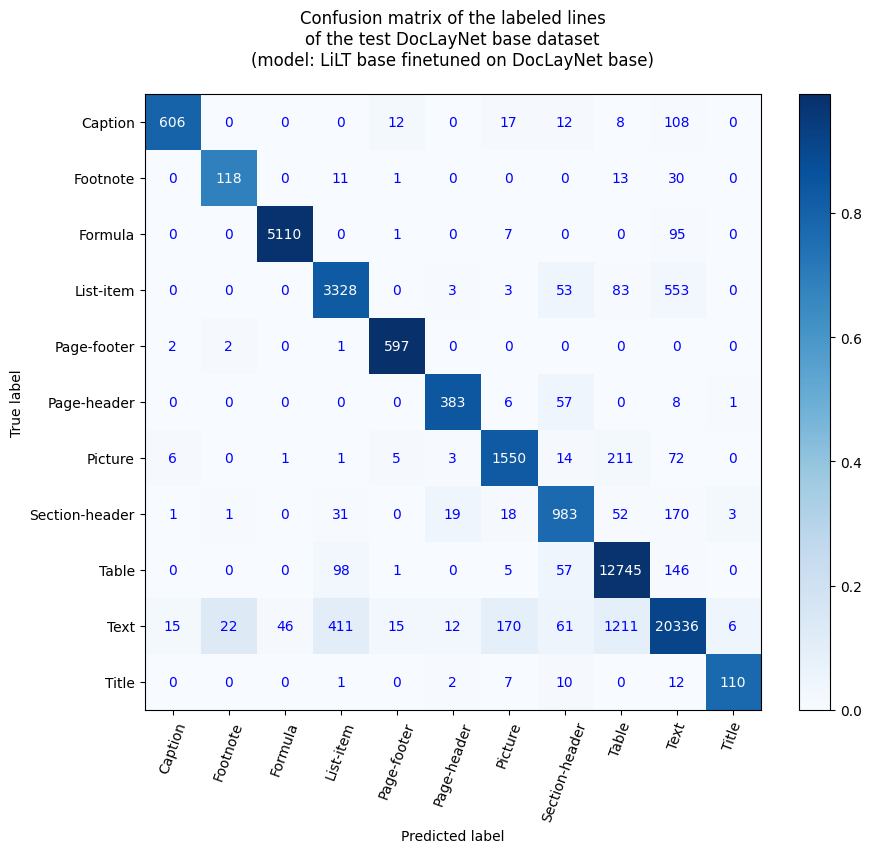
- Line Accuracy: 0.9197
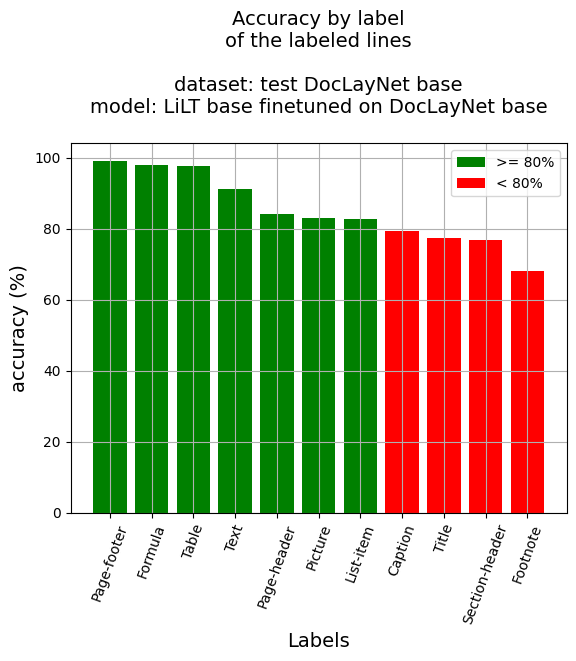
Accuracy at line level
- Line Accuracy: 91.97%
- Accuracy by label
- Caption: 79.42%
- Footnote: 68.21%
- Formula: 98.02%
- List-item: 82.72%
- Page-footer: 99.17%
- Page-header: 84.18%
- Picture: 83.2%
- Section-header: 76.92%
- Table: 97.65%
- Text: 91.17%
- Title: 77.46%
References
Blog posts
- Layout XLM base
- LiLT base
- (02/16/2023) Document AI | Inference APP and fine-tuning notebook for Document Understanding at paragraph level
- (02/14/2023) Document AI | Inference APP for Document Understanding at line level
- (02/10/2023) Document AI | Document Understanding model at line level with LiLT, Tesseract and DocLayNet dataset
- (01/31/2023) Document AI | DocLayNet image viewer APP
- (01/27/2023) Document AI | Processing of DocLayNet dataset to be used by layout models of the Hugging Face hub (finetuning, inference)
Notebooks (paragraph level)
- LiLT base
- Document AI | Inference APP at paragraph level with a Document Understanding model (LiLT fine-tuned on DocLayNet dataset)
- Document AI | Inference at paragraph level with a Document Understanding model (LiLT fine-tuned on DocLayNet dataset)
- Document AI | Fine-tune LiLT on DocLayNet base in any language at paragraph level (chunk of 512 tokens with overlap)
Notebooks (line level)
- Layout XLM base
- Document AI | Inference at line level with a Document Understanding model (LayoutXLM base fine-tuned on DocLayNet dataset)
- Document AI | Inference APP at line level with a Document Understanding model (LayoutXLM base fine-tuned on DocLayNet base dataset)
- Document AI | Fine-tune LayoutXLM base on DocLayNet base in any language at line level (chunk of 384 tokens with overlap)
- LiLT base
- Document AI | Inference at line level with a Document Understanding model (LiLT fine-tuned on DocLayNet dataset)
- Document AI | Inference APP at line level with a Document Understanding model (LiLT fine-tuned on DocLayNet dataset)
- Document AI | Fine-tune LiLT on DocLayNet base in any language at line level (chunk of 384 tokens with overlap)
- DocLayNet image viewer APP
- Processing of DocLayNet dataset to be used by layout models of the Hugging Face hub (finetuning, inference)
APP
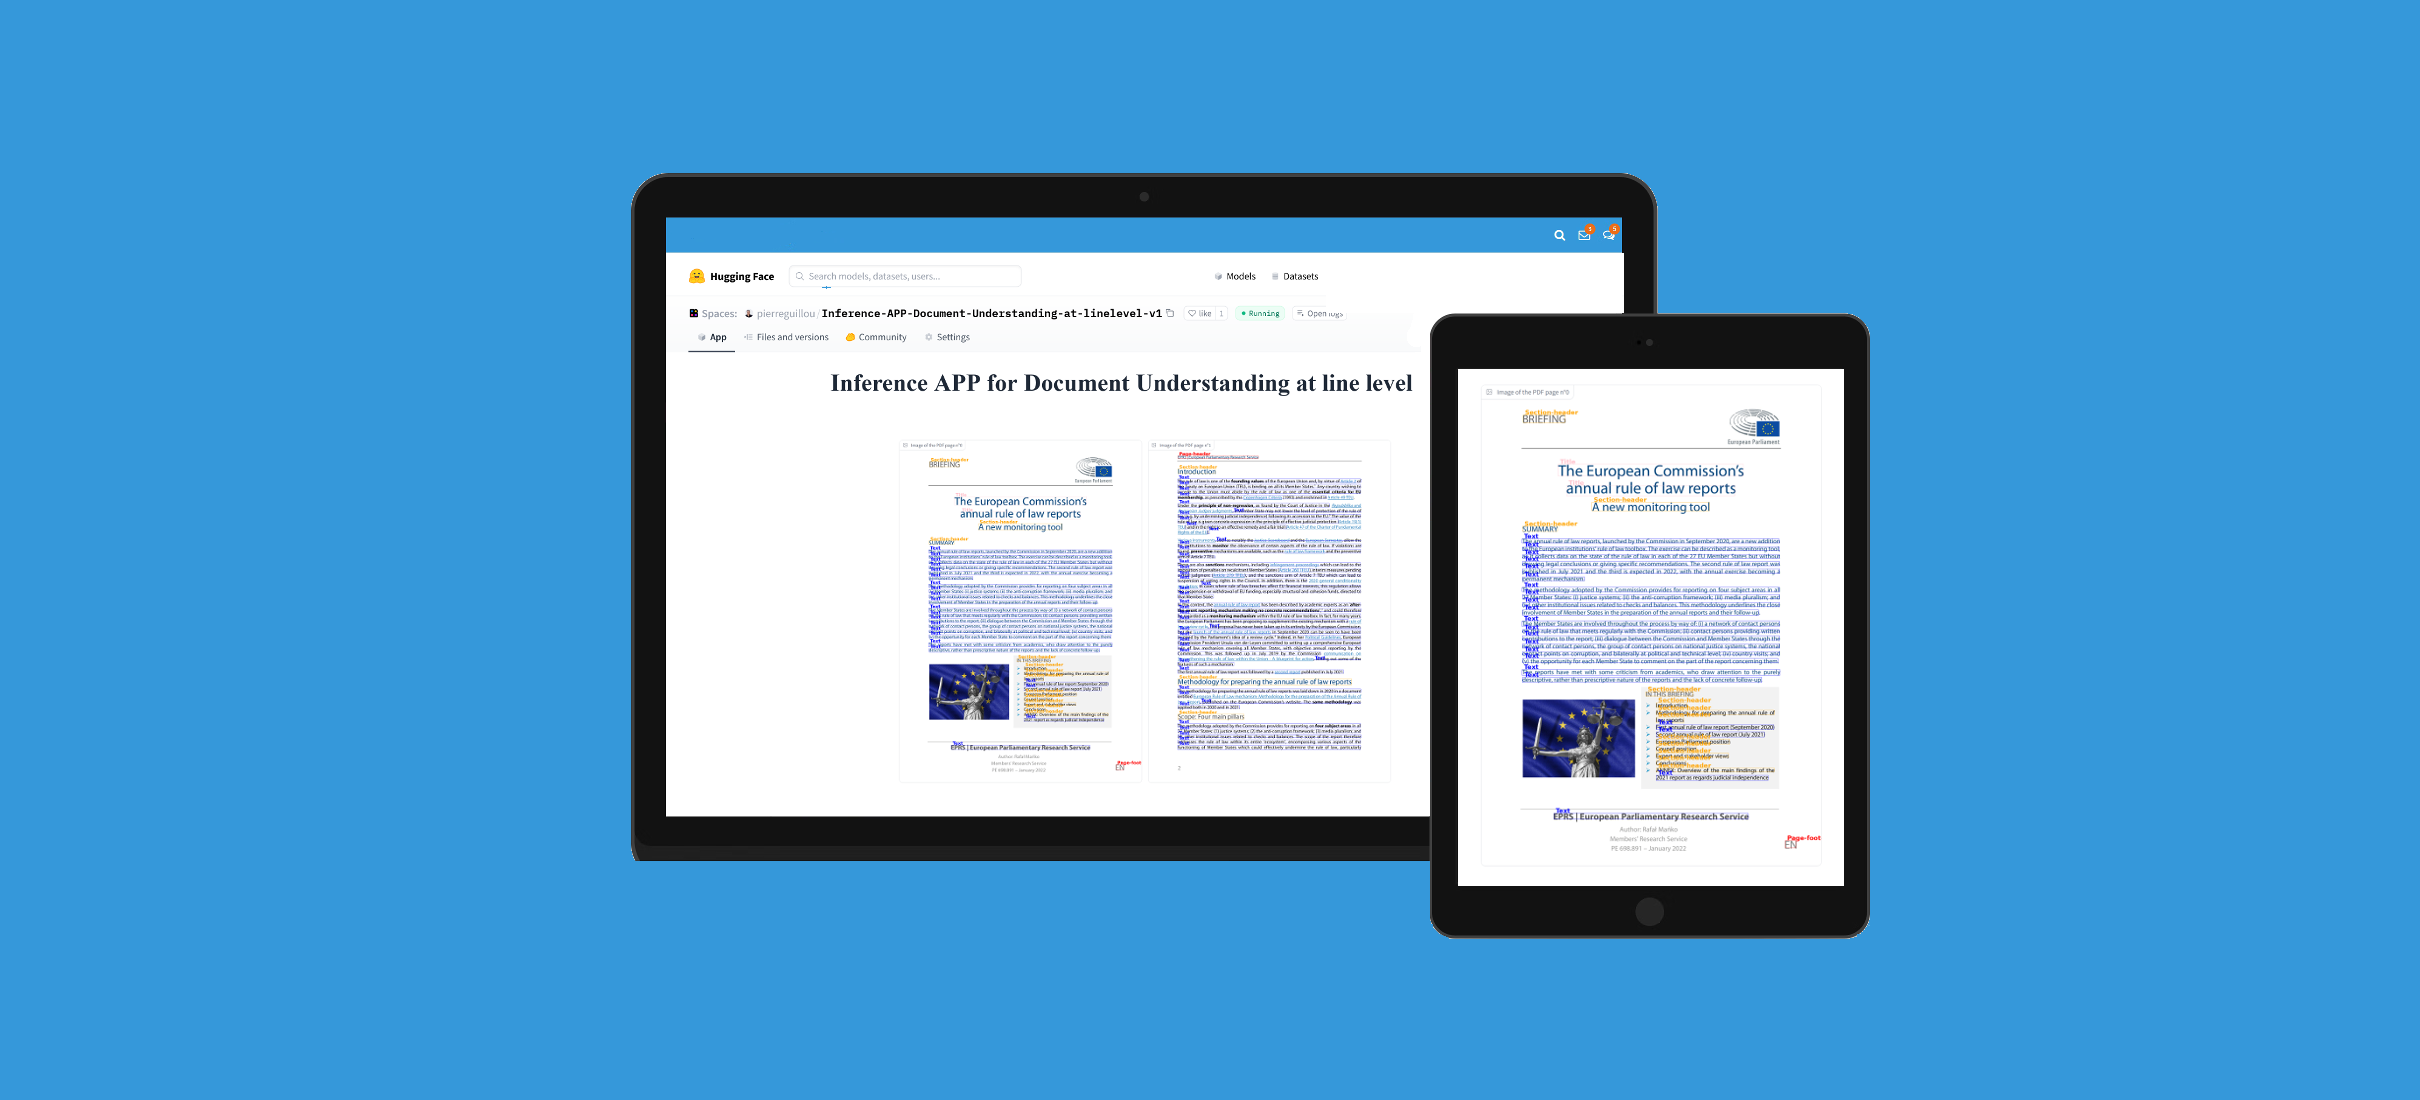
You can test this model with this APP in Hugging Face Spaces: Inference APP for Document Understanding at line level (v1).
DocLayNet dataset
DocLayNet dataset (IBM) provides page-by-page layout segmentation ground-truth using bounding-boxes for 11 distinct class labels on 80863 unique pages from 6 document categories.
Until today, the dataset can be downloaded through direct links or as a dataset from Hugging Face datasets:
- direct links: doclaynet_core.zip (28 GiB), doclaynet_extra.zip (7.5 GiB)
- Hugging Face dataset library: dataset DocLayNet
Paper: DocLayNet: A Large Human-Annotated Dataset for Document-Layout Analysis (06/02/2022)
Model description
The model was finetuned at line level on chunk of 384 tokens with overlap of 128 tokens. Thus, the model was trained with all layout and text data of all pages of the dataset.
At inference time, a calculation of best probabilities give the label to each line bounding boxes.
Inference
See notebook: Document AI | Inference at line level with a Document Understanding model (LiLT fine-tuned on DocLayNet dataset)
Training and evaluation data
See notebook: Document AI | Fine-tune LiLT on DocLayNet base in any language at line level (chunk of 384 tokens with overlap)
Training procedure
Training hyperparameters
The following hyperparameters were used during training:
- learning_rate: 5e-05
- train_batch_size: 8
- eval_batch_size: 16
- seed: 42
- optimizer: Adam with betas=(0.9,0.999) and epsilon=1e-08
- lr_scheduler_type: linear
- num_epochs: 5
- mixed_precision_training: Native AMP
Training results
| Training Loss | Epoch | Step | Validation Loss | Precision | Recall | F1 | Accuracy |
|---|---|---|---|---|---|---|---|
| 0.7223 | 0.21 | 500 | 0.7765 | 0.7741 | 0.7741 | 0.7741 | 0.7741 |
| 0.4469 | 0.42 | 1000 | 0.5914 | 0.8312 | 0.8312 | 0.8312 | 0.8312 |
| 0.3819 | 0.62 | 1500 | 0.8745 | 0.8102 | 0.8102 | 0.8102 | 0.8102 |
| 0.3361 | 0.83 | 2000 | 0.6991 | 0.8337 | 0.8337 | 0.8337 | 0.8337 |
| 0.2784 | 1.04 | 2500 | 0.7513 | 0.8119 | 0.8119 | 0.8119 | 0.8119 |
| 0.2377 | 1.25 | 3000 | 0.9048 | 0.8166 | 0.8166 | 0.8166 | 0.8166 |
| 0.2401 | 1.45 | 3500 | 1.2411 | 0.7939 | 0.7939 | 0.7939 | 0.7939 |
| 0.2054 | 1.66 | 4000 | 1.1594 | 0.8080 | 0.8080 | 0.8080 | 0.8080 |
| 0.1909 | 1.87 | 4500 | 0.7545 | 0.8425 | 0.8425 | 0.8425 | 0.8425 |
| 0.1704 | 2.08 | 5000 | 0.8567 | 0.8318 | 0.8318 | 0.8318 | 0.8318 |
| 0.1294 | 2.29 | 5500 | 0.8486 | 0.8489 | 0.8489 | 0.8489 | 0.8489 |
| 0.134 | 2.49 | 6000 | 0.7682 | 0.8573 | 0.8573 | 0.8573 | 0.8573 |
| 0.1354 | 2.7 | 6500 | 0.9871 | 0.8256 | 0.8256 | 0.8256 | 0.8256 |
| 0.1239 | 2.91 | 7000 | 1.1430 | 0.8189 | 0.8189 | 0.8189 | 0.8189 |
| 0.1012 | 3.12 | 7500 | 0.8272 | 0.8386 | 0.8386 | 0.8386 | 0.8386 |
| 0.0788 | 3.32 | 8000 | 1.0288 | 0.8365 | 0.8365 | 0.8365 | 0.8365 |
| 0.0802 | 3.53 | 8500 | 0.7197 | 0.8849 | 0.8849 | 0.8849 | 0.8849 |
| 0.0861 | 3.74 | 9000 | 1.1420 | 0.8320 | 0.8320 | 0.8320 | 0.8320 |
| 0.0639 | 3.95 | 9500 | 0.9563 | 0.8585 | 0.8585 | 0.8585 | 0.8585 |
| 0.0464 | 4.15 | 10000 | 1.0768 | 0.8511 | 0.8511 | 0.8511 | 0.8511 |
| 0.0412 | 4.36 | 10500 | 1.1184 | 0.8439 | 0.8439 | 0.8439 | 0.8439 |
| 0.039 | 4.57 | 11000 | 0.9634 | 0.8636 | 0.8636 | 0.8636 | 0.8636 |
| 0.0469 | 4.78 | 11500 | 0.9585 | 0.8634 | 0.8634 | 0.8634 | 0.8634 |
| 0.0395 | 4.99 | 12000 | 1.0003 | 0.8584 | 0.8584 | 0.8584 | 0.8584 |
Framework versions
- Transformers 4.26.0
- Pytorch 1.13.1+cu116
- Datasets 2.9.0
- Tokenizers 0.13.2
Other models
- Line level
- Document Understanding model (finetuned LiLT base at line level on DocLayNet base) (accuracy | tokens: 85.84% - lines: 91.97%)
- Document Understanding model (finetuned LayoutXLM base at line level on DocLayNet base) (accuracy | tokens: 93.73% - lines: ...)
- Paragraph level
- Document Understanding model (finetuned LiLT base at paragraph level on DocLayNet base) (accuracy | tokens: 86.34% - paragraphs: 68.15%)
- Document Understanding model (finetuned LayoutXLM base at paragraph level on DocLayNet base) (accuracy | tokens: 96.93% - paragraphs: 86.55%)