/ Модель

Характеристики

Контекст
1 024 токена
Параметры
456 млн
Лицензия
Apache 2.0
Архитектура
whisper · dense
Опубликована
6 дек 2022

whisper-medium-french

Распознавание речиАудио → текст10 профессий

Дообученная на Common Voice 11.0 модель Whisper для транскрибации французской речи в текст.

53скачиваний за 30 дней9лайковвеса обновлены12 дек 2022

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Распознавание речи» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

French Medium Whisper — дообученная модель распознавания речи из семейства Whisper, созданная на основе openai/whisper-medium и обученная на наборе данных Common Voice 11.0. Она преобразует французскую речь в текст и подходит для транскрибации аудио и оценки систем распознавания французской речи. В карточке приведены результаты на тестовой выборке: WER 15,8969 без нормализации и 11,1406 с нормализацией.

Модель содержит 455,8 млн параметров, использует архитектуру WhisperForConditionalGeneration и распространяется в формате PyTorch. Лицензия — Apache-2.0. Результаты сравнения с Whisper Medium приведены для тестовых наборов разных версий Common Voice, поэтому они не гарантируют превосходство на других аудио и сценариях.

Сценарии применения

  • транскрибация французских аудиозаписей
  • распознавание французской речи в голосовых сообщениях
  • создание текстовых расшифровок французских интервью
  • оценка качества систем распознавания французской речи

Ограничения

Заявленные показатели WER получены на тестовой выборке Common Voice 11.0 и не обязательно отражают качество на других данных. Сравнение с результатом Whisper Medium использует Common Voice 9.0, поэтому оно не является прямым сопоставлением на одном тестовом наборе.

Для каких профессий подходит10

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

French Medium Whisper

This model is a fine-tuned version of openai/whisper-medium on the common_voice_11_0 dataset. It achieves the following results on the evaluation set:

  • Loss: 0.2664
  • Wer (without normalization): 15.8969
  • Wer (with normalization): 11.1406

Blog post

All information about this model in this blog post: Speech-to-Text & IA | Transcreva qualquer áudio para o português com o Whisper (OpenAI)... sem nenhum custo!.

New SOTA

The Normalized WER in the OpenAI Whisper article with the Common Voice 9.0 test dataset is 16.0.

As this test dataset is similar to the Common Voice 11.0 test dataset used to evaluate our model (WER and WER Norm), it means that our French Medium Whisper is better than the Medium Whisper model at transcribing audios French in text.
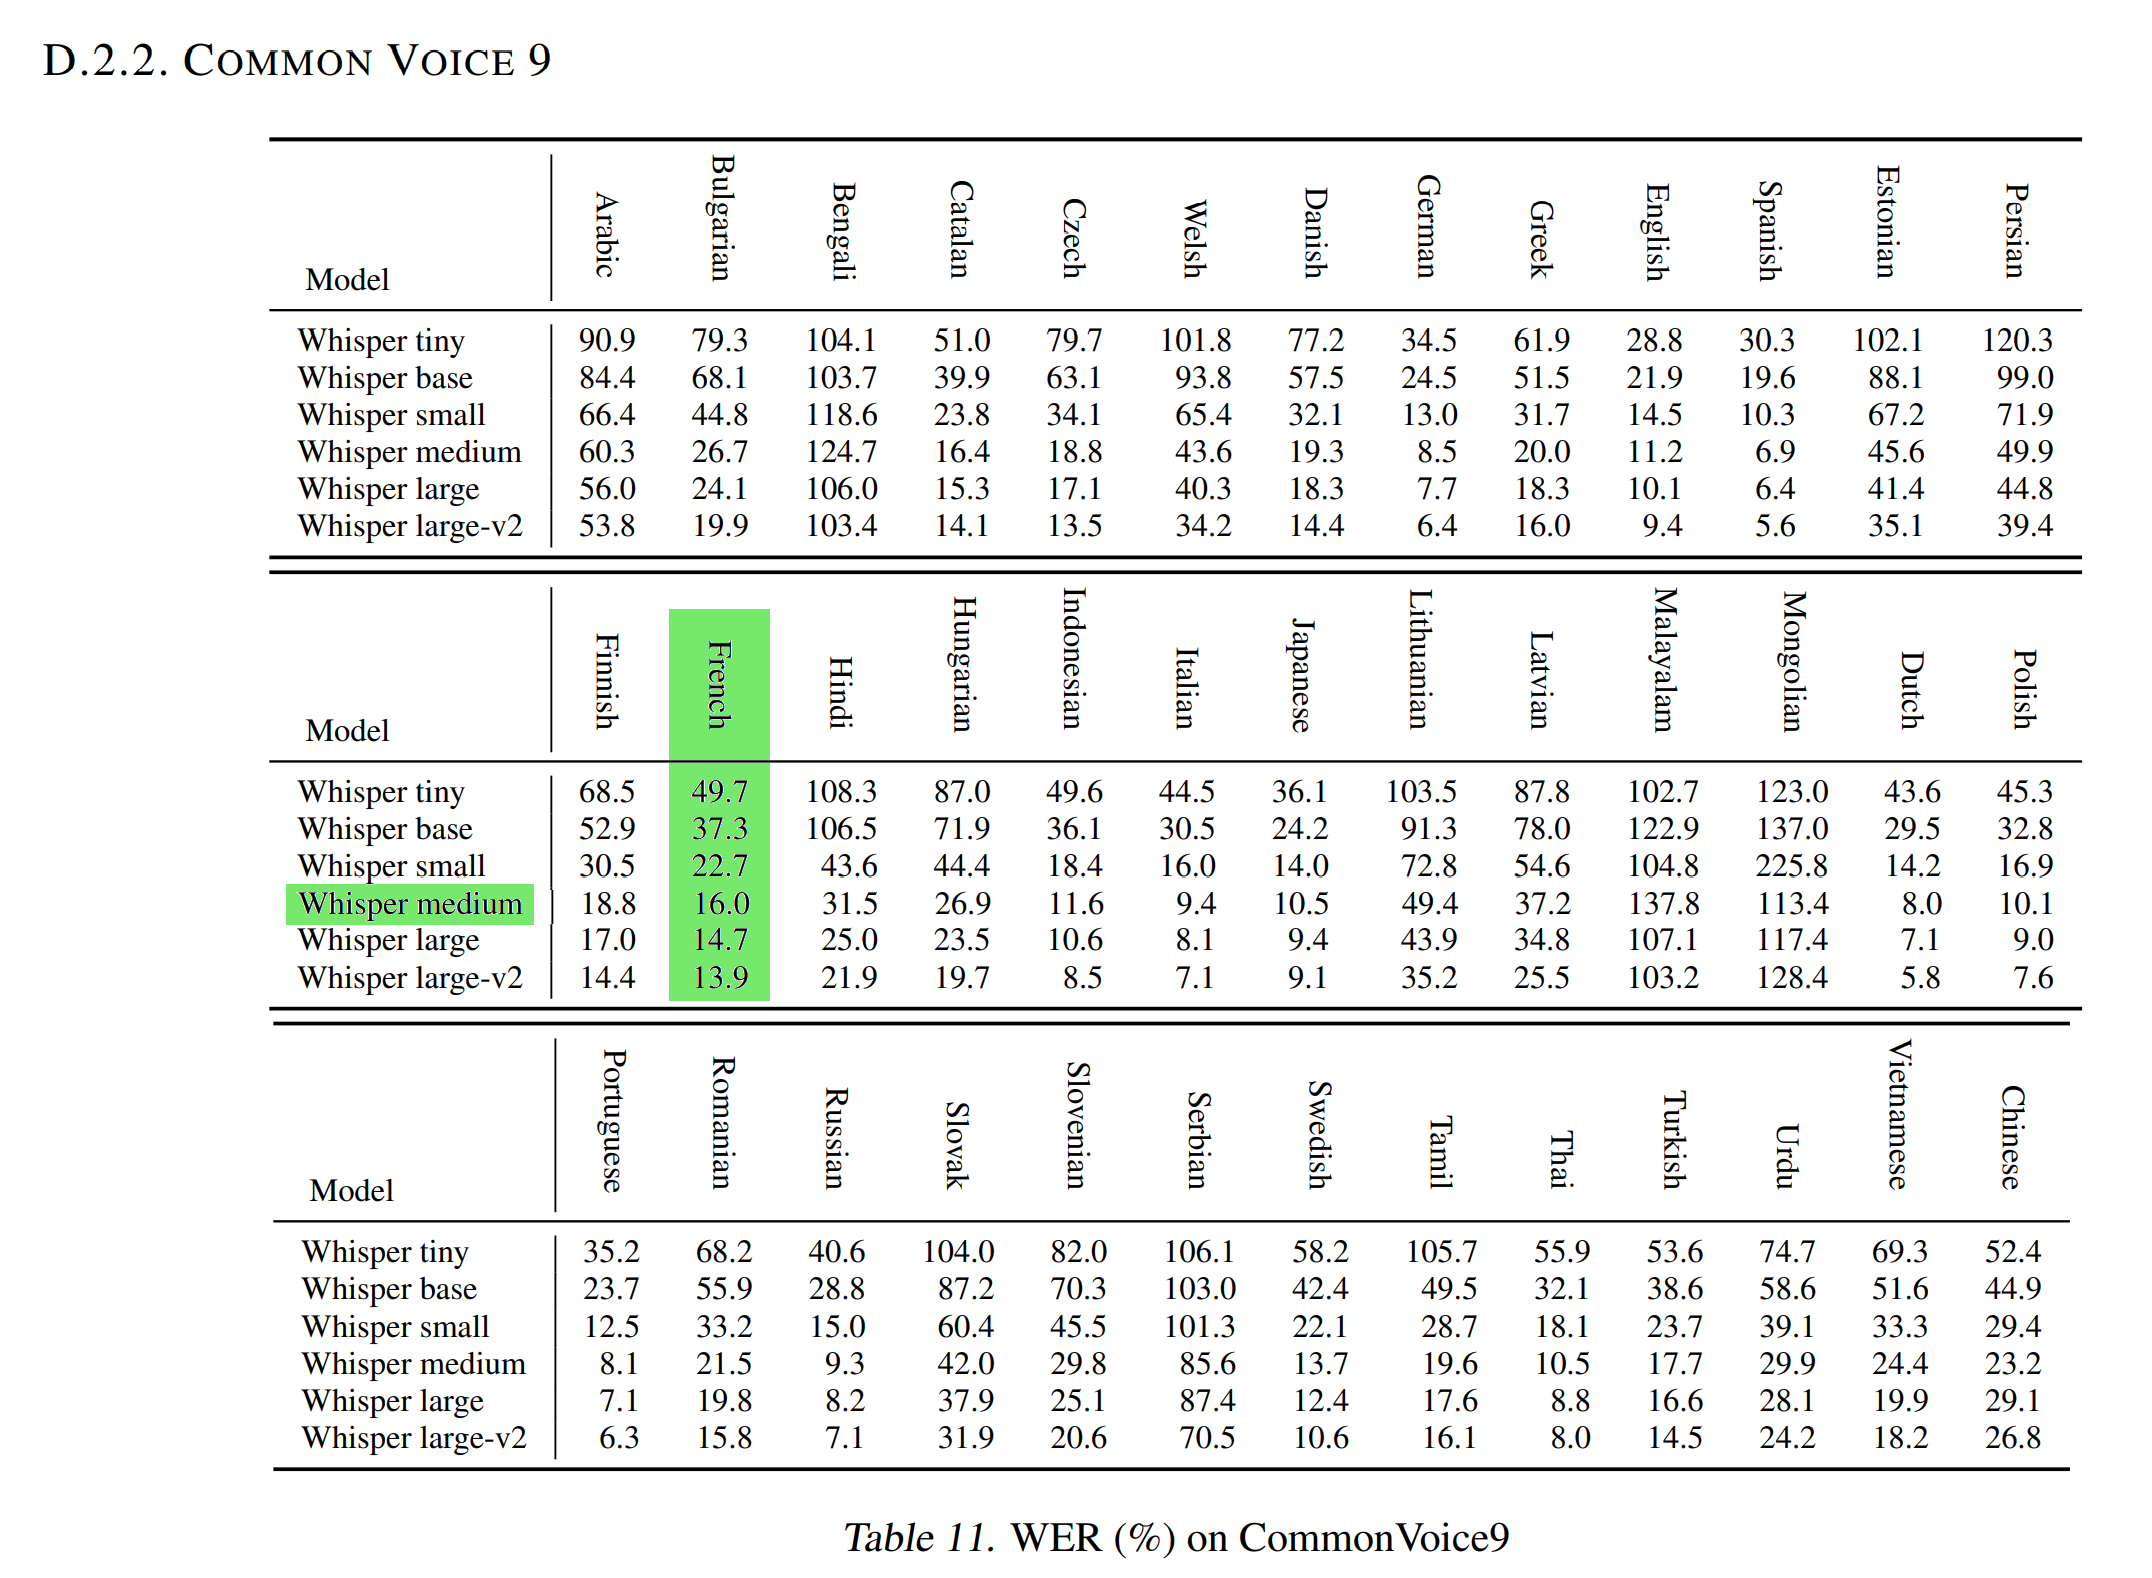
OpenAI results with Whisper Medium and Test dataset of Commons Voice 9.0

Training procedure

Training hyperparameters

The following hyperparameters were used during training:

  • learning_rate: 1e-05
  • train_batch_size: 32
  • eval_batch_size: 16
  • seed: 42
  • optimizer: Adam with betas=(0.9,0.999) and epsilon=1e-08
  • lr_scheduler_type: linear
  • lr_scheduler_warmup_steps: 500
  • training_steps: 5000
  • mixed_precision_training: Native AMP

Training results

Training LossEpochStepValidation LossWerWer Norm
0.26950.210000.308017.808312.9791
0.20990.420000.298117.479212.4242
0.19780.630000.286416.776712.0913
0.14550.840000.275216.459711.8966
0.17121.050000.266415.896911.1406

Framework versions

  • Transformers 4.26.0.dev0
  • Pytorch 1.13.0+cu117
  • Datasets 2.7.1.dev0
  • Tokenizers 0.13.2

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Можно запустить

Подбираем GPU…

Класс архитектуры
WhisperForConditionalGeneration
Ревизия весов
bd4dc9b

0 моделей