OneFormer
OneFormer model trained on the ADE20k dataset (large-sized version, Dinat backbone). It was introduced in the paper OneFormer: One Transformer to Rule Universal Image Segmentation by Jain et al. and first released in this repository.

Model description
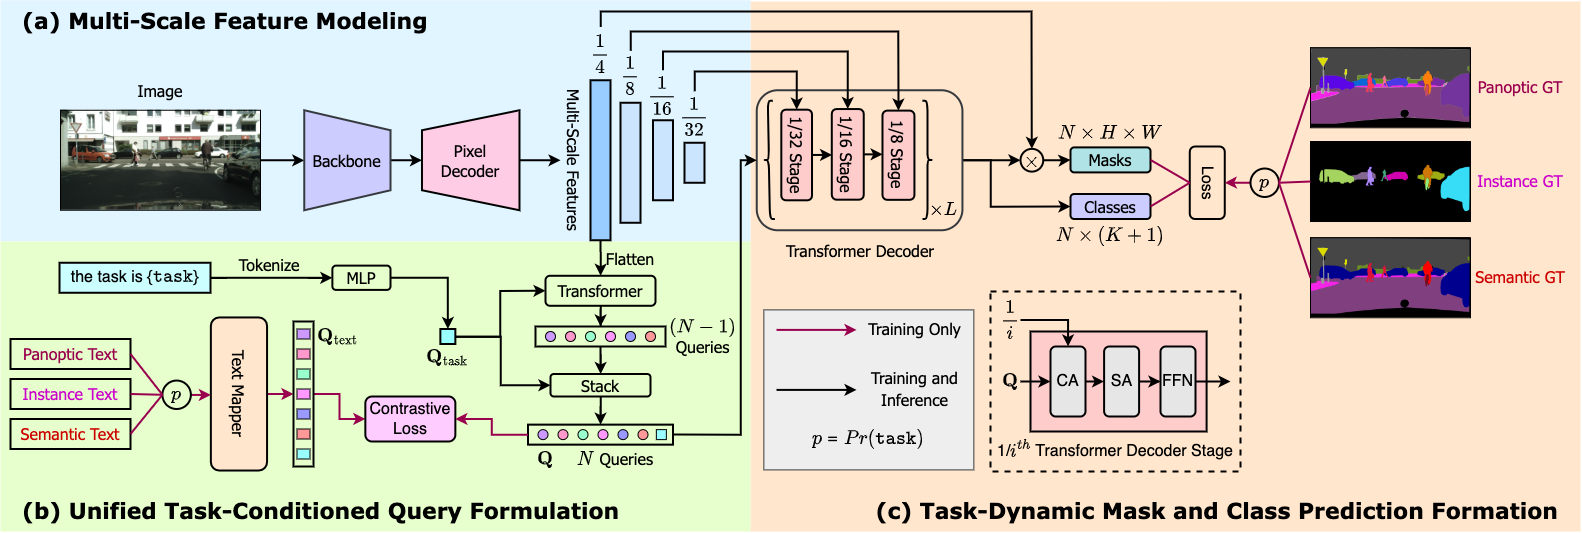
OneFormer is the first multi-task universal image segmentation framework. It needs to be trained only once with a single universal architecture, a single model, and on a single dataset, to outperform existing specialized models across semantic, instance, and panoptic segmentation tasks. OneFormer uses a task token to condition the model on the task in focus, making the architecture task-guided for training, and task-dynamic for inference, all with a single model.
Intended uses & limitations
You can use this particular checkpoint for semantic, instance and panoptic segmentation. See the model hub to look for other fine-tuned versions on a different dataset.
How to use
Here is how to use this model:
from transformers import OneFormerProcessor, OneFormerForUniversalSegmentation
from PIL import Image
import requests
url = "https://huggingface.co/datasets/shi-labs/oneformer_demo/blob/main/ade20k.jpeg"
image = Image.open(requests.get(url, stream=True).raw)

# Loading a single model for all three tasks
processor = OneFormerProcessor.from_pretrained("shi-labs/oneformer_ade20k_dinat_large")
model = OneFormerForUniversalSegmentation.from_pretrained("shi-labs/oneformer_ade20k_dinat_large")

# Semantic Segmentation
semantic_inputs = processor(images=image, task_inputs=["semantic"], return_tensors="pt")
semantic_outputs = model(**semantic_inputs)
# pass through image_processor for postprocessing
predicted_semantic_map = processor.post_process_semantic_segmentation(outputs, target_sizes=[image.size[::-1]])[0]

# Instance Segmentation
instance_inputs = processor(images=image, task_inputs=["instance"], return_tensors="pt")
instance_outputs = model(**instance_inputs)
# pass through image_processor for postprocessing
predicted_instance_map = processor.post_process_instance_segmentation(outputs, target_sizes=[image.size[::-1]])[0]["segmentation"]

# Panoptic Segmentation
panoptic_inputs = processor(images=image, task_inputs=["panoptic"], return_tensors="pt")
panoptic_outputs = model(**panoptic_inputs)
# pass through image_processor for postprocessing
predicted_semantic_map = processor.post_process_panoptic_segmentation(outputs, target_sizes=[image.size[::-1]])[0]["segmentation"]
For more examples, please refer to the documentation.
Citation
@article{jain2022oneformer,
      title={{OneFormer: One Transformer to Rule Universal Image Segmentation}},
      author={Jitesh Jain and Jiachen Li and MangTik Chiu and Ali Hassani and Nikita Orlov and Humphrey Shi},
      journal={arXiv},
      year={2022}
    }