Pingala V1 Universal
A high-performance English speech recognition model optimized for transcription by Shunyalabs.
Try the demo at https://www.shunyalabs.ai
License
This model is distributed under the Shunya Labs RAIL-M License, which includes specific use-based restrictions and commercial licensing requirements.
License Summary
- Free Use: Up to 10,000 hours of audio transcription per calendar month
- Distribution: Model cannot be redistributed to third parties
- Derivatives: Creation of derivative works is not permitted
- Attribution: Required when outputs are made public or shared
Key Restrictions
The license prohibits use for discrimination, military applications, disinformation, privacy violations, unauthorized medical advice, and other harmful purposes. Please refer to the complete LICENSE file for detailed terms and conditions.
For inquiries, contact: 0@shunyalabs.ai
Model Overview
Pingala V1 Universal is a state-of-the-art automatic speech recognition (ASR) model that delivers exceptional accuracy across diverse audio domains. With a low word error rate (WER) of just 3.10 in English, it is optimized for high-precision, verbatim transcription—capturing spoken content word-for-word with remarkable fidelity.
Designed to support transcription across 204 languages, including a wide range of Indic and global languages, Pingala V1 Universal performs consistently across various domains such as meetings, earnings calls, broadcast media, and educational content.
Performance Benchmarks
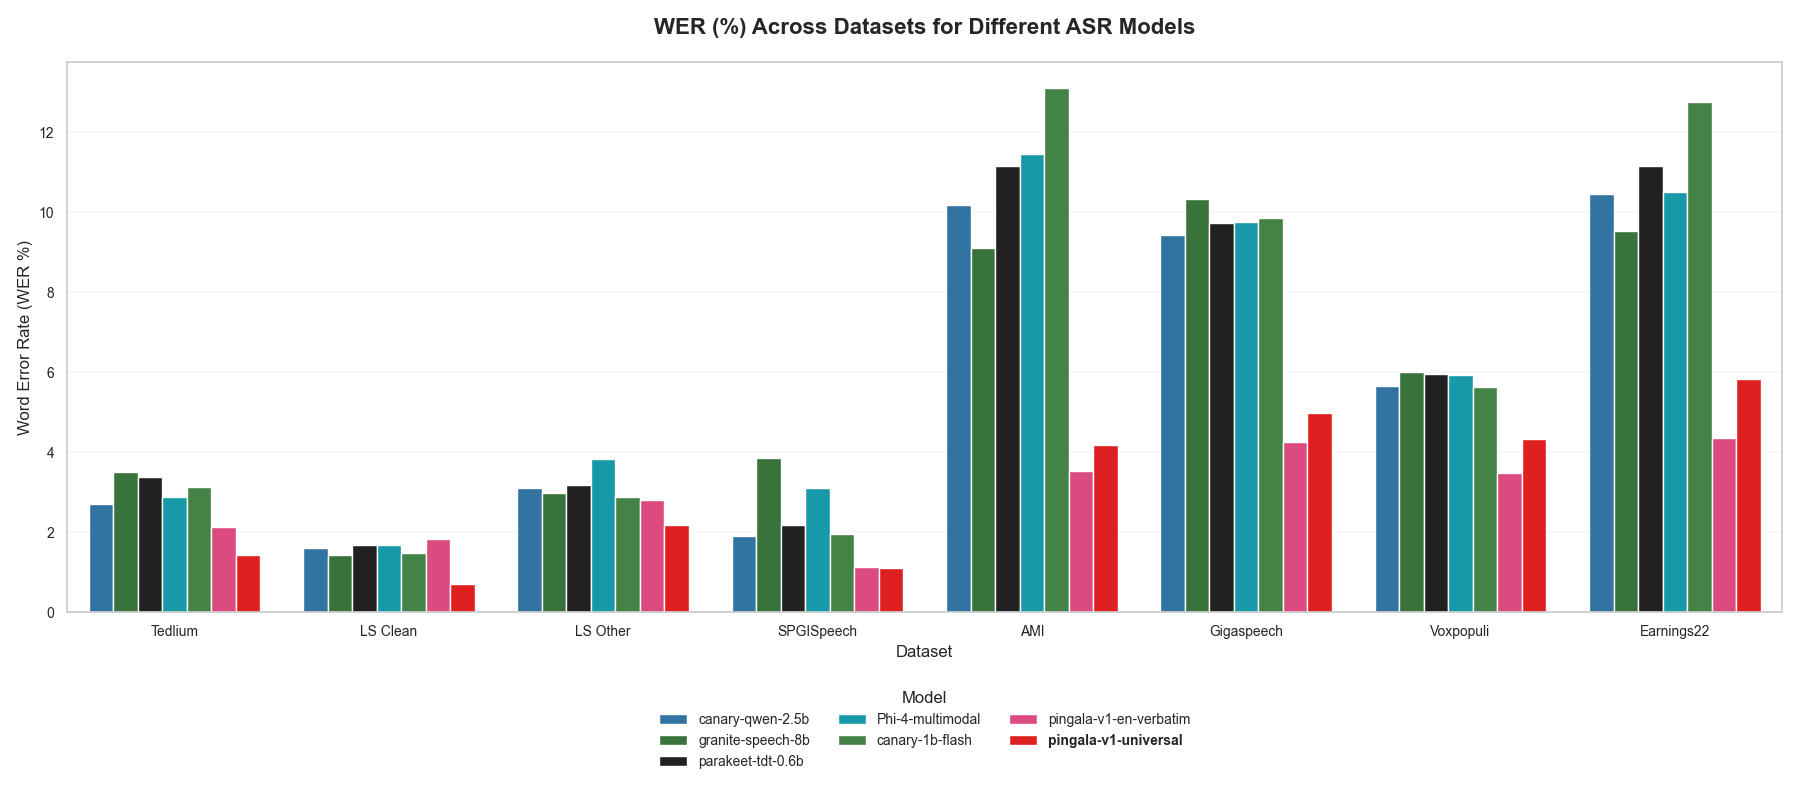
OpenASR Leaderboard Results
The model has been extensively evaluated on the OpenASR leaderboard across multiple English datasets, demonstrating superior performance compared to larger open-source models:
| Dataset | WER (%) | RTFx |
|---|---|---|
| AMI Test | 4.19 | 70.22 |
| Earnings22 Test | 5.83 | 101.52 |
| GigaSpeech Test | 4.99 | 131.09 |
| LibriSpeech Test Clean | 0.71 | 158.74 |
| LibriSpeech Test Other | 2.17 | 142.40 |
| SPGISpeech Test | 1.10 | 170.85 |
| TedLium Test | 1.43 | 153.34 |
| VoxPopuli Test | 4.34 | 179.28 |
Composite Results
- Overall WER: 3.10%
- Average RTFx: 146.23
RTFx (Real-Time Factor) indicates inference speed relative to audio duration. Higher values mean faster processing.
Comparative Performance
Pingala V1 significantly outperforms larger open-source models on 8 common speech benchmarks:
| Model | AMI | Earnings22 | GigaSpeech | LS Clean | LS Other | SPGISpeech | TedLium | Voxpopuli | Avg WER |
|---|---|---|---|---|---|---|---|---|---|
| nvidia/canary-qwen-2.5b | 10.19 | 10.45 | 9.43 | 1.61 | 3.10 | 1.90 | 2.71 | 5.66 | 5.63 |
| ibm/granite-granite-speech-3.3-8b | 9.12 | 9.53 | 10.33 | 1.42 | 2.99 | 3.86 | 3.50 | 6.00 | 5.74 |
| nvidia/parakeet-tdt-0.6b-v2 | 11.16 | 11.15 | 9.74 | 1.69 | 3.19 | 2.17 | 3.38 | 5.95 | 6.05 |
| microsoft/Phi-4-multimodal-instruct | 11.45 | 10.50 | 9.77 | 1.67 | 3.82 | 3.11 | 2.89 | 5.93 | 6.14 |
| nvidia/canary-1b-flash | 13.11 | 12.77 | 9.85 | 1.48 | 2.87 | 1.95 | 3.12 | 5.63 | 6.35 |
| shunyalabs/pingala-v1-en-verbatim | 3.52 | 4.36 | 4.26 | 1.84 | 2.81 | 1.13 | 2.14 | 3.47 | 2.94 |
| shunyalabs/pingala-v1-universal | 4.19 | 5.83 | 4.99 | 0.71 | 2.17 | 1.10 | 1.43 | 4.34 | 3.10 |
Authentication with Hugging Face Hub
This model require authentication with Hugging Face Hub. Here's how to set up and use your Hugging Face token.
Getting Your Hugging Face Token
- Create a Hugging Face Account: Go to huggingface.co and sign up
- Generate a Token:
- Go to Settings > Access Tokens
- Click "New token"
- Choose "Read" permissions
- Copy your token (starts with
hf_...)
Setting Up Authentication
Method 1: Environment Variable (Recommended)
# Set your token as an environment variable
export HUGGINGFACE_HUB_TOKEN="hf_your_token_here"

# Or add to your ~/.bashrc or ~/.zshrc for persistence
echo 'export HUGGINGFACE_HUB_TOKEN="hf_your_token_here"' >> ~/.bashrc
source ~/.bashrc
Method 2: Hugging Face CLI Login
# Install Hugging Face CLI if not already installed
pip install huggingface_hub

# Login using CLI
huggingface-cli login
# Enter your token when prompted
Method 3: Programmatic Authentication
from huggingface_hub import login

# Login programmatically
login(token="hf_your_token_here")
Installation
Basic Installation
pip install pingala-shunya
Usage
Quick Start
from pingala_shunya import PingalaTranscriber

# Explicitly choose backends with Shunya Labs model
transcriber = PingalaTranscriber(model_name="shunyalabs/pingala-v1-universal", backend="transformers")

segments, info = transcriber.transcribe_file(
    "audio.wav",
    beam_size=5,
)

for segment in segments:
    print(f"[{segment.start:.2f}s -> {segment.end:.2f}s] {segment.text}")
Model Details
- Architecture: transformer-based model optimized for multilingual transcription accross 204 languages
- Format: Transformer compatible for efficient inference
- Sampling Rate: 16 kHz
- Model Size: Production-optimized for deployment
- Optimization: Real-time inference capable with GPU acceleration
Key Features
- Exceptional Accuracy: Achieves 3.10% WER across diverse English test sets
- Real-Time Performance: Average RTFx of 146.23 enables real-time applications
- Verbatim Transcription: Optimized for accurate, word-for-word transcription
- Multi-Domain Excellence: Superior performance across conversational, broadcast, and read English speech
- Voice Activity Detection: Built-in VAD for better handling of silence
Performance Optimization Tips
- GPU Acceleration: Use
device="cuda"for significantly faster inference - Precision: Set
compute_type="float16"for optimal speed on modern GPUs - Threading: Adjust
cpu_threadsandnum_workersbased on your hardware configuration - VAD Filtering: Enable
vad_filter=Truefor improved performance on long audio files - Language Specification: Set
language="en"for English audio to improve accuracy and speed - Beam Size: Use
beam_size=5for best accuracy, reduce for faster inference - Batch Processing: Process multiple files with a single model instance for efficiency
Use Cases
The model excels in various English speech recognition scenarios:
- Meeting Transcription: High accuracy on conversational English speech (AMI: 4.19% WER)
- Financial Communications: Specialized performance on earnings calls and financial content (Earnings22: 5.83% WER)
- Broadcast Media: Excellent results on news, podcasts, and media content
- Educational Content: Optimized for lectures, presentations, and educational material transcription
- Customer Support: Accurate transcription of support calls and customer interactions
- Legal Documentation: Professional-grade accuracy for legal proceedings and depositions
- Medical Transcription: High-quality transcription for medical consultations and documentation
Support and Contact
For technical support, licensing inquiries, or commercial partnerships:
- Website: https://www.shunyalabs.ai
- Documentation: https://www.shunyalabs.ai/pingala
- Pypi: https://pypi.org/project/pingala-shunya
- Commercial Licensing: 0@shunyalabs.ai
Acknowledgments
Special thanks to the open-source community for providing the foundational tools that make this model possible.
Version History
- v1.0: Initial release with state-of-the-art performance across multiple English domains
- Optimized for transcription with 3.10% composite WER
- Production-ready deployment capabilities
This model is provided under the Shunya Labs RAIL-M License. Please ensure compliance with all license terms before use.