/ Модель

Характеристики

Контекст
131 072 токена
Параметры
14 млрд
Размер весов
29,5 ГБ
Лицензия
Apache 2.0
Архитектура
qwen2 · dense
Базовая модель
Lamarck-14B-v0.6
Библиотека
transformers
Опубликована
21 янв 2025

Lamarck-14B-v0.7

Генерация текстаТекст → текст15 профессий

Объединённая 14-миллиардная модель Qwen2 для диалогов, многошаговых рассуждений, написания прозы и перевода.

1 597скачиваний за 30 дней46лайковвеса обновлены11 ноя 2025

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

Lamarck-14B-v0.7 — языковая модель на 14 млрд параметров, собранная sometimesanotion как объединение нескольких моделей семейства Qwen2. Для создания использовалась собственная цепочка слияний весов, включая SLERP и TIES, и объединение ветвей, построенных с помощью LoRA и других методов слияния. В числе предшественников — DeepSeek-R1-Distill-Qwen-14B, Virtuoso-Small и предыдущие версии Lamarck.

Модель предназначена для диалогов и генерации текста общего назначения с упором на многошаговые рассуждения, связную прозу, перевод и работу на нескольких языках. Контекст — до 131 072 токенов; в карточке отмечена поддержка английского языка, а автор также заявляет о многоязычных возможностях. Модель доступна в формате safetensors и распространяется по лицензии Apache-2.0.

Заявления о качестве основаны на оценках автора и субъективном описании возможностей; независимые результаты бенчмарков в карточке не приведены. Для унаследованных компонентов и слияния качество может различаться в зависимости от задачи.

Сценарии применения

  • ответы в диалоговом ассистенте
  • решение задач, требующих многошаговых рассуждений
  • написание связной прозы
  • перевод между языками
  • генерация текста общего назначения

Ограничения

Заявления о качестве в README не подкреплены приведёнными независимыми результатами бенчмарков. Многоязычность заявлена автором, но конкретные языки, кроме английского в метаданных, не перечислены.

Для каких профессий подходит15

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Lamarck.webp

[!TIP] With no benchmark regressions, mostly gains over the previous release, this version of Lamarck has broken the 41.0 average maximum for 14B parameter models. Those providing feedback, thank you!

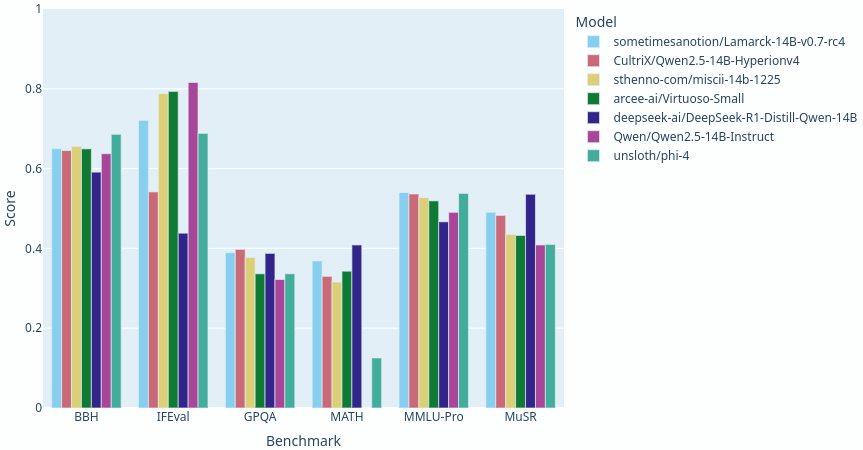
Lamarck 14B v0.7: A generalist merge with emphasis on multi-step reasoning, prose, and multi-language ability. The 14B parameter model class has a lot of strong performers, and Lamarck strives to be well-rounded and solid: 14b.png
Lamarck is produced by a custom toolchain to automate a process of LoRAs and layer-targeting merges:

  • Extracted LoRA adapters from special-purpose merges
  • Custom base models and model_stocks, with LoRAs from from huihui-ai/Qwen2.5-14B-Instruct-abliterated-v2 to minimize IFEVAL loss often seen in model_stock merges
  • Separate branches for aggressive breadcrumbs and conservative DELLA merges
  • Highly targeted weight/density gradients for every 2-4 layers, at each stage
  • Finalization through SLERP+TIES merges recombining the breadcrumbs and DELLA branches to taste

Lamarck's performance comes from an ancestry that goes back through careful merges to select finetuning work, upcycled and combined. Through intermediate merges, arcee-ai/Virtuoso-Small sthenno-com/miscii-14b-1225 and VAGOsolutions/SauerkrautLM-v2-14b-DPO are emphasized in early layers for extra BBH; later layers add synergistic influence from deepseek-ai/DeepSeek-R1-Distill-Qwen-14B, Krystalan/DRT-o1-14B, EVA-UNIT-01/EVA-Qwen2.5-14B-v0.2, and CultriX/Qwen2.5-14B-Wernicke.

More subjectively, its prose and translation abilities are boosted by repeated re-emphasis of Krystalan/DRT-o1-14B and underwoods/medius-erebus-magnum-14b. Other models found in sometimesanotion/Qwenvergence-14B-v3-Prose have their impact on prose quality - and surprising synergy of reasoning.

Kudos to @arcee-ai, @deepseek-ai, @Krystalan, @underwoods, @VAGOSolutions, @CultriX, @sthenno-com, and @rombodawg whose models had the most influence. Vimarckoso v3 has the model card which documents its extended lineage.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · transformers

Можно запустить

Подбираем GPU…

Класс архитектуры
Qwen2ForCausalLM
Ревизия весов
235c2f7

0 моделей