/ Модель

Характеристики

Контекст
920 токенов
Параметры
1,4 млрд
Лицензия
Apache 2.0
Архитектура
mctct · dense
Опубликована
27 мая 2022

m-ctc-t-large

Распознавание речиАудио → текст8 профессий

M-CTC-T — многоязычная трансформерная модель Meta AI для автоматической транскрибации речи по аудиопризнакам.

566скачиваний за 30 дней20лайковвеса обновлены4 янв 2023

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Публичные оценки21

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

  • SIBFLEURS

    main_score

    Результат

    0,2225

    Общий результат 0,3289Общий результат 0,313Общий результат 0,3119
    MTEB

    Публичная таблицаревизия совпадает

  • VoiceGenderClustering

    main_score

    Результат

    0,1926

    MTEB

    Публичная таблицаревизия совпадает

  • JamAltArtistA2ARetrieval

    main_score

    Результат

    0,5096

    MTEB

    Публичная таблицаревизия совпадает

  • ESC50

    main_score

    Результат

    0,1705

    MTEB

    Публичная таблицаревизия совпадает

  • VoxPopuliAccentID

    main_score

    Результат

    0,1313

    MTEB

    Публичная таблицаревизия совпадает

  • MusicGenreClustering

    main_score

    Результат

    0,1279

    MTEB

    Публичная таблицаревизия совпадает

  • MInDS14

    main_score

    Результат

    0,6029

    Общий результат 0,4749
    MTEB

    Публичная таблицаревизия совпадает

  • LibriCount

    main_score

    Результат

    0,3486

    MTEB

    Публичная таблицаревизия совпадает

  • GTZANGenre

    main_score

    Результат

    0,392

    MTEB

    Публичная таблицаревизия совпадает

  • VocalSoundAudioReranking

    main_score

    Результат

    0,4716

    MTEB

    Публичная таблицаревизия совпадает

  • CommonLanguageAgeDetection

    main_score

    Результат

    0,1735

    MTEB

    Публичная таблицаревизия совпадает

  • UrbanSound8KAudioReranking

    main_score

    Результат

    0,3652

    MTEB

    Публичная таблицаревизия совпадает

  • FSDD

    main_score

    Результат

    0,595

    MTEB

    Публичная таблицаревизия совпадает

  • VoxPopuliLanguageID

    main_score

    Результат

    0,994

    MTEB

    Публичная таблицаревизия совпадает

  • NMSQAPairClassification

    main_score

    Результат

    0,5898

    MTEB

    Публичная таблицаревизия совпадает

  • GTZANGenreClustering

    main_score

    Результат

    0,1971

    MTEB

    Публичная таблицаревизия совпадает

  • IEMOCAPGender

    main_score

    Результат

    0,5096

    MTEB

    Публичная таблицаревизия совпадает

  • VoxPopuliGenderID

    main_score

    Результат

    0,56

    MTEB

    Публичная таблицаревизия совпадает

  • FSD50K

    main_score

    Результат

    0,7779

    MTEB

    Публичная таблицаревизия совпадает

  • AudioSetMini

    main_score

    Результат

    0,1994

    MTEB

    Публичная таблицаревизия совпадает

  • BeijingOpera

    main_score

    Результат

    0,4324

    MTEB

    Публичная таблицаревизия совпадает

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

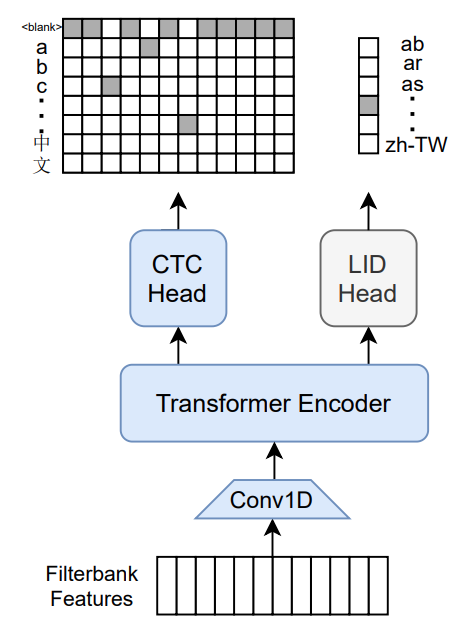
M-CTC-T — многоязычная модель распознавания речи от Meta AI, представленная в PyTorch. Это трансформерный энкодер примерно с 1,4 млрд параметров, CTC-головой на 8065 символьных меток и отдельной головой идентификации языка на 60 меток. На вход модель принимает мел-частотные фильтробанковские признаки аудио с частотой дискретизации 16 кГц и выдаёт посимвольную транскрипцию с сохранением пунктуации и регистра.

Модель обучалась на Common Voice и VoxPopuli, а затем дополнительно на Common Voice. Она предназначена для автоматической транскрибации речи и может использоваться как акустическая модель. В метаданных указан английский язык; README описывает модель как многоязычную, однако конкретный перечень языков в доступных данных не приведён.

Репозиторий содержит PyTorch-представление модели, перенесённое из Flashlight C++ в PyTorch. Лицензия — Apache-2.0. Карточка не сообщает показатели качества; распознавание ограничено поддерживаемыми языками и акустическими условиями, а модель ожидает аудио, преобразованное в признаки для сигнала 16 кГц.

Сценарии применения

  • транскрибация записей речи
  • распознавание речи в аудиофайлах
  • получение посимвольной расшифровки с пунктуацией и регистром
  • определение языка речи среди поддерживаемых языков

Ограничения

Модель ожидает мел-частотные фильтробанковские признаки, подготовленные для аудио 16 кГц, а распознавание доступно только на поддерживаемых языках. В карточке не приведены количественные показатели качества.

Для каких профессий подходит8

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Также подходит для

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

M-CTC-T

​ Massively multilingual speech recognizer from Meta AI. The model is a 1B-param transformer encoder, with a CTC head over 8065 character labels and a language identification head over 60 language ID labels. It is trained on Common Voice (version 6.1, December 2020 release) and VoxPopuli. After training on Common Voice and VoxPopuli, the model is trained on Common Voice only. The labels are unnormalized character-level transcripts (punctuation and capitalization are not removed). The model takes as input Mel filterbank features from a 16Khz audio signal. ​ model image ​
The original Flashlight code, model checkpoints, and Colab notebook can be found at https://github.com/flashlight/wav2letter/tree/main/recipes/mling_pl . ​ ​

Citation

​ Paper ​

Authors: Loren Lugosch, Tatiana Likhomanenko, Gabriel Synnaeve, Ronan Collobert ​

@article{lugosch2021pseudo,
  title={Pseudo-Labeling for Massively Multilingual Speech Recognition},
  author={Lugosch, Loren and Likhomanenko, Tatiana and Synnaeve, Gabriel and Collobert, Ronan},
  journal={ICASSP},
  year={2022}
}

Contribution

A huge thanks to Chan Woo Kim for porting the model from Flashlight C++ to PyTorch. ​

Training method

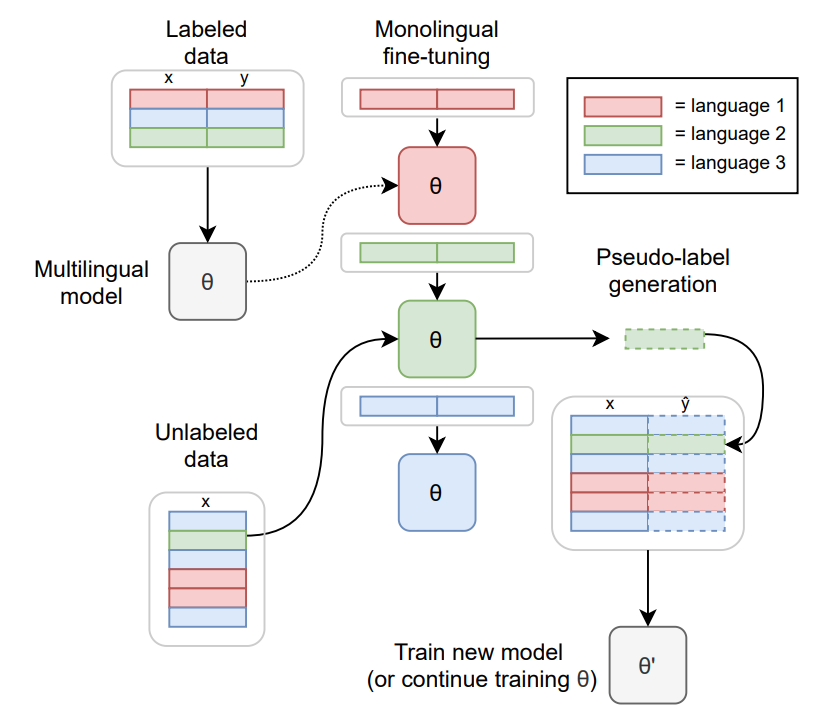
​ model image ​ For more information on how the model was trained, please take a look at the official paper. ​

Usage

​ To transcribe audio files the model can be used as a standalone acoustic model as follows: ​

import torch
import torchaudio
from datasets import load_dataset
from transformers import MCTCTForCTC, MCTCTProcessor

model = MCTCTForCTC.from_pretrained("speechbrain/m-ctc-t-large")
processor = MCTCTProcessor.from_pretrained("speechbrain/m-ctc-t-large")

 # load dummy dataset and read soundfiles
ds = load_dataset("patrickvonplaten/librispeech_asr_dummy", "clean", split="validation")
 
# feature extraction
input_features = processor(ds[0]["audio"]["array"], sampling_rate=ds[0]["audio"]["sampling_rate"], return_tensors="pt").input_features 

# retrieve logits
with torch.no_grad():
    logits = model(input_features).logits

# take argmax and decode
predicted_ids = torch.argmax(logits, dim=-1)
transcription = processor.batch_decode(predicted_ids)

Results for Common Voice, averaged over all languages: ​

Character error rate (CER): ​

"Valid""Test"
21.423.3

Questions & Help

If you have questions regarding this model or need help, please consider opening a discussion or pull request on this repo and tag @lorenlugosch, @cwkeam or @patrickvonplaten

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм

Нельзя запустить

Архитектура mctct неизвестна transformers в образе рантайма.

Класс архитектуры
MCTCTForCTC
Ревизия весов
ed014c8

0 моделей