/ Модель

Характеристики

Контекст
8 192 токена
Параметры
7,8 млрд
Размер весов
10,9 ГБ
Лицензия
Apache 2.0
Архитектура
falcon · dense
Базовая модель
falcon-11B
Библиотека
transformers
Опубликована
20 мая 2024

Falcon2-5.5B-Swedish

Генерация текстаТекст → текст3 профессии

Шведская языковая модель на базе Falcon-11B для генерации текста, диалогов и последующей адаптации под прикладные задачи.

28скачиваний за 30 дней0лайковвеса обновлены5 июн 2024

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

ssmits создал Falcon2-5.5B-Swedish — шведскую языковую модель для генерации текста, полученную преобразованием Falcon-11B методом passthrough с помощью mergekit. Для сокращения модели проанализировали сходство слоёв на 2000 примерах из шведской части Wikimedia Wikipedia и сохранили диапазоны слоёв [0, 25] и [56, 59]. В метаданных указаны архитектура FalconForCausalLM, 7,8 млрд параметров, контекст до 8192 токенов и формат safetensors.

Модель предназначена для исследований и дальнейшей специализации, например, для суммаризации, генерации текста и чат-ботов. Она обучена преимущественно на английском, но также поддерживает шведский и ряд европейских языков. Лицензия — Apache-2.0. Для работы с Transformers требуется PyTorch 2.0; авторы не рекомендуют применять модель в production без оценки рисков и защитных мер.

Сценарии применения

  • генерация текста на шведском языке
  • создание чат-бота на шведском
  • суммаризация шведских текстов после адаптации
  • дальнейшее дообучение языковой модели для целевой задачи

Ограничения

Модель обучалась преимущественно на английском и может плохо обобщать на языки за пределами перечисленных европейских языков; в данных могут присутствовать стереотипы и предубеждения из веб-корпусов. Для production авторы рекомендуют предварительно оценить риски и предусмотреть защитные меры.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

Why prune?

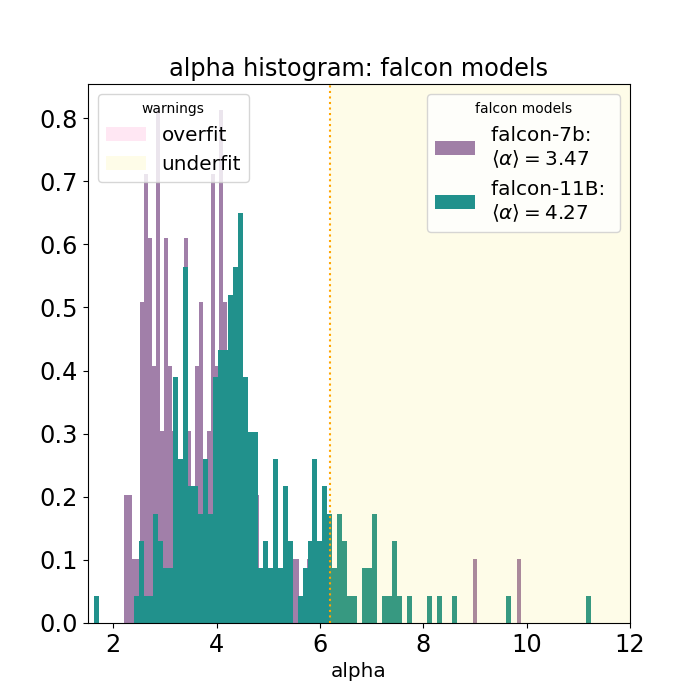
Even though Falcon-11B is trained on 5T tokens, it is still undertrained, as can be seen by this graph: image/png This is why the choice is made to prune 50% of the layers. Note that ~1B of continued pre-training (~1M rows of 1k tokens) is still required to restore the perplexity of this model in the desired language. I'm planning on doing that for certain languages, depending on how much compute will be available.
sliced

This is a merge of pre-trained language models created using mergekit.

Merge Details

Merge Method

This model was merged using the passthrough merge method.

Models Merged

The following models were included in the merge:

Configuration

The following YAML configuration was used to produce this model:

slices:
  - sources:
      - model: tiiuae/falcon-11B
        layer_range: [0, 25]
  - sources:
      - model: tiiuae/falcon-11B
        layer_range: [56, 59]
merge_method: passthrough
dtype: bfloat16

PruneMe has been utilized using the wikimedia/wikipedia Swedish (sv) subset by investigating layer similarity with 2000 samples. The layer ranges for pruning were determined based on this analysis to maintain performance while reducing model size.

Layer Similarity Plot

from transformers import AutoTokenizer, AutoModelForCausalLM
import transformers
import torch

model = "ssmits/Falcon2-5.5B-Swedish"

tokenizer = AutoTokenizer.from_pretrained(model)
pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.bfloat16,
)
sequences = pipeline(
   "Can you explain the concepts of Quantum Computing?",
    max_length=200,
    do_sample=True,
    top_k=10,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
    print(f"Result: {seq['generated_text']}")

💥 Falcon LLMs require PyTorch 2.0 for use with transformers!

For fast inference with Falcon, check-out Text Generation Inference! Read more in this [blogpost]((https://huggingface.co/blog/falcon).

Direct Use

Research on large language models; as a foundation for further specialization and finetuning for specific usecases (e.g., summarization, text generation, chatbot, etc.)

Out-of-Scope Use

Production use without adequate assessment of risks and mitigation; any use cases which may be considered irresponsible or harmful.

Bias, Risks, and Limitations

Falcon2-5.5B is trained mostly on English, but also German, Spanish, French, Italian, Portuguese, Polish, Dutch, Romanian, Czech, Swedish. It will not generalize appropriately to other languages. Furthermore, as it is trained on a large-scale corpora representative of the web, it will carry the stereotypes and biases commonly encountered online.

Recommendations

We recommend users of Falcon2-5.5B to consider finetuning it for the specific set of tasks of interest, and for guardrails and appropriate precautions to be taken for any production use.

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · transformers

Можно запустить

Подбираем GPU…

Класс архитектуры
FalconForCausalLM
Ревизия весов
e373e05

0 моделей