/ Модель

Характеристики

Контекст
40 960 токенов
Параметры
7,6 млрд
Размер весов
16,4 ГБ
Лицензия
Apache 2.0
Архитектура
qwen3 · dense
Базовая модель
diallm-qwen-sft-ind
Библиотека
transformers
Опубликована
16 апр 2026

diallm-qwen-dpo-ind

Генерация текстаТекст → текст3 профессии

Диалоговая модель Qwen3 на 7,6 млрд параметров, дообученная для генерации текстов на индийском английском.

21скачиваний за 30 дней0лайковвеса обновлены24 авг 2026

Бенчмарки

Как модель справилась с задачами пользователей ailist и что о ней публикуют открытые лидерборды

Тесты пользователейпока нет

Никто ещё не опубликовал тест этой модели. Соберите бенчмарк из своих задач — результат появится здесь.

  1. Добавьте модель в бенчмарк

    Вместе с другими моделями категории «Текст» — сравнение идёт внутри одной категории.

  2. Опишите свои задачи

    Напишите запросы, при необходимости приложите файлы и эталонные ответы.

  3. Запустите и опубликуйте

    Модели ответят на каждую задачу, судья оценит ответы. Опубликованный результат появится на этой странице.

Публичные оценки

Из открытых лидербордов. Сравнивайте результаты одного теста при одинаковых условиях — отсутствие оценки не значит, что модель хуже.

В подключённых источниках результатов для этой модели пока нет.

Что умеет модель

Описание составлено по карточке модели и метаданным Hugging Face

DiaLLM Qwen 3-8B en-IN DPO — диалоговая языковая модель на архитектуре Qwen3 с 7,6 млрд параметров, разработанная Surrey NLP в рамках исследования адаптации английских диалектов. Модель обучена на базе jordanpainter/diallm-qwen-sft-ind: после продолжительного предобучения на корпусе International Corpus of English с 18 разновидностями английского языка базовая модель прошла адаптацию к индийскому английскому (en-IN) и DPO-выравнивание на предпочтениях для этой разновидности.

Модель предназначена для генерации ответов в диалоге с особенностями индийского английского и изучения того, как адаптация к диалекту влияет на генерацию и устойчивость модели. Она принимает текст и выдаёт текст; максимальная длина контекста — 40 960 токенов. Поддержка других языков, кроме английского, не заявлена. Репозиторий содержит веса Safetensors и использует библиотеку Transformers. Лицензия — Apache 2.0.

Сценарии применения

  • генерация ответов на вопросы с особенностями индийского английского
  • ведение диалога на индийском английском
  • сравнение генерации моделей для разных разновидностей английского
  • исследование адаптации языковых моделей к диалектам английского

Ограничения

Модель специально адаптирована к индийскому английскому; качество для других языковых разновидностей и задач в карточке не охарактеризовано. Карточка описывает экспериментальную исследовательскую разработку, но не приводит результатов бенчмарков.

Для каких профессий подходит3

Разделы каталога профессий, в задачах которых используется эта модель

Все профессии

Карточка модели

README от автора на Hugging Face, как он его опубликовал

Открыть на Hugging Face

DiaLLM — Qwen 3-8B — en-IN — DPO

Part of DiaLLM: An Investigation into the Robustness-Generation Gap in English Dialect Adaptation (EMNLP 2026 Main).
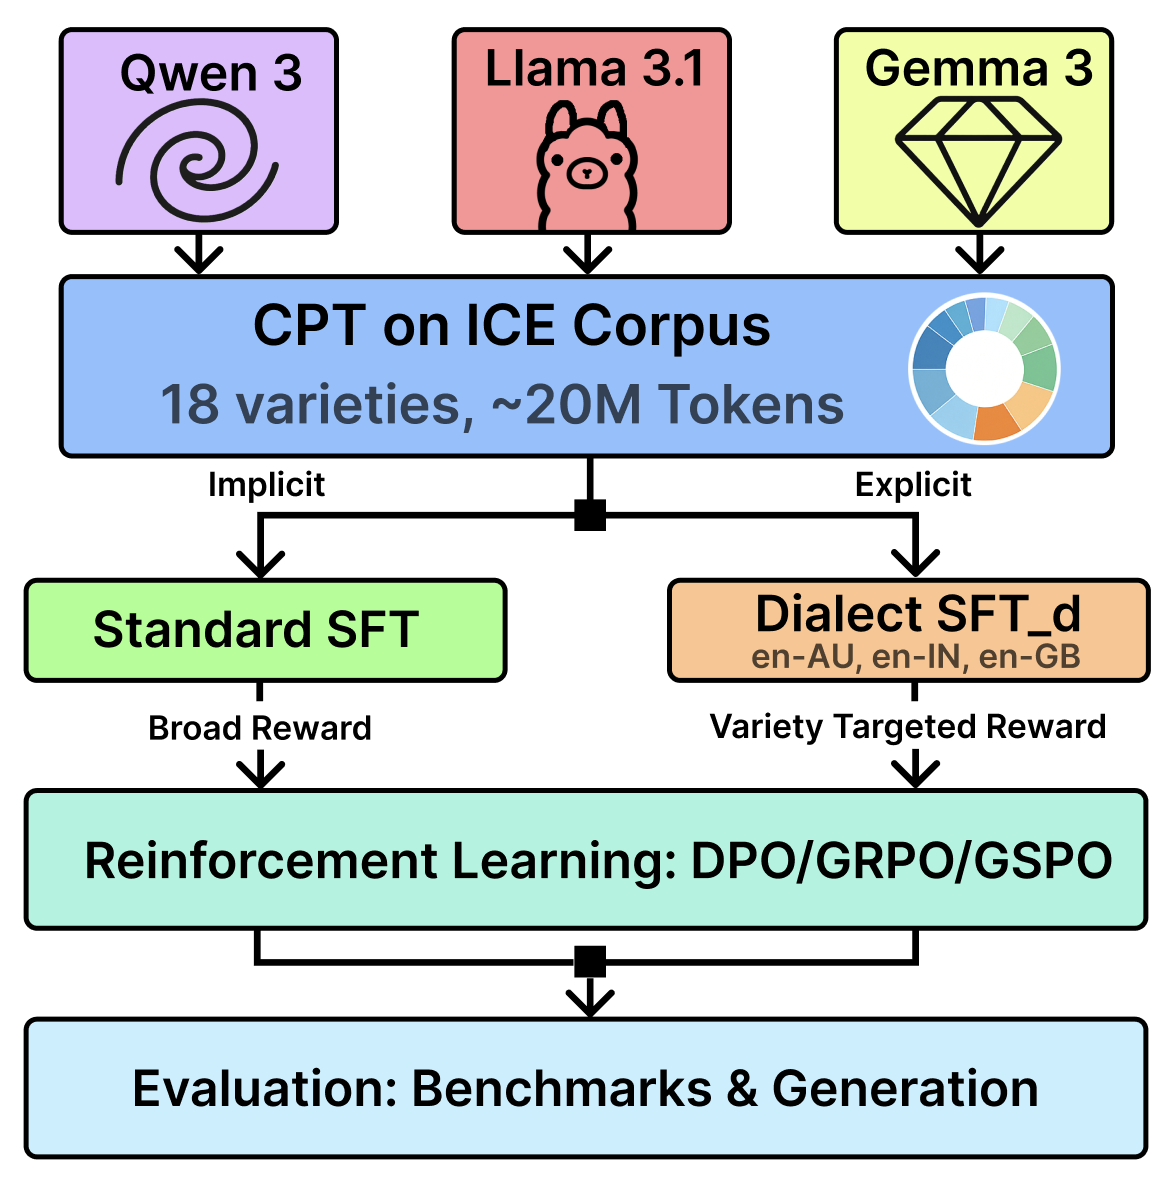
DiaLLM pipeline

  • Base model: Qwen 3-8B
  • Target variety: en-IN (Indian English)
  • Adaptation thread: explicit (variety-targeted)
  • Alignment method: DPO

Continually pretrained on the International Corpus of English (18 varieties, ~20M tokens), then adapted via the explicit thread: dialect-specific SFT on Multi-VALUE-transformed en-IN preference data, followed by DPO with the target-variety preference pairs.

Code, checkpoints, preference datasets, linguistic-analysis toolkit: https://github.com/surrey-nlp/diallm

Paper: https://arxiv.org/abs/2607.07669

This model is a fine-tuned version of jordanpainter/diallm-qwen-sft-ind, trained using TRL.

Quick start

from transformers import pipeline

question = "If you had a time machine, but could only go to the past or the future once and never return, which would you choose and why?"
generator = pipeline("text-generation", model="surrey-nlp/diallm-qwen-dpo-ind", device="cuda")
output = generator([{"role": "user", "content": question}], max_new_tokens=128, return_full_text=False)[0]
print(output["generated_text"])

Training procedure

This model was trained with DPO.

Framework versions

  • TRL: 0.28.0
  • Transformers: 4.57.6
  • Pytorch: 2.5.1+cu121
  • Datasets: 4.5.0
  • Tokenizers: 0.22.2

Citation

@article{painter2026diallm,
  title     = {DiaLLM: An Investigation into the Robustness-Generation Gap in English Dialect Adaptation},
  author    = {Painter, Jordan and Srirag, Dipankar and Kappiyath, Adarsh and Kanojia, Diptesh and Joshi, Aditya and Yin, Lu},
  year      = {2026},
  eprint    = {2607.07669},
  archivePrefix = {arXiv}
}
@inproceedings{rafailov2023direct,
    title        = {{Direct Preference Optimization: Your Language Model is Secretly a Reward Model}},
    author       = {Rafael Rafailov and Archit Sharma and Eric Mitchell and Christopher D. Manning and Stefano Ermon and Chelsea Finn},
    year         = 2023,
    booktitle    = {Advances in Neural Information Processing Systems 36},
    url          = {http://papers.nips.cc/paper_files/paper/2023/hash/a85b405ed65c6477a4fe8302b5e06ce7-Abstract-Conference.html}
}
@software{vonwerra2020trl,
  title   = {{TRL: Transformers Reinforcement Learning}},
  author  = {von Werra, Leandro and Belkada, Younes and Tunstall, Lewis and Beeching, Edward and Thrush, Tristan and Lambert, Nathan and Huang, Shengyi and Rasul, Kashif and Gallouédec, Quentin},
  license = {Apache-2.0},
  url     = {https://github.com/huggingface/trl},
  year    = {2020}
}

Как запустить

На своей GPU в ailist. Цена — по текущим предложениям провайдеров

GPU в ailist

Универсальный рантайм · transformers

Можно запустить

Подбираем GPU…

Класс архитектуры
Qwen3ForCausalLM
Ревизия весов
08937f9

0 моделей